AI 主动替你盯着,为什么消息反而更多了?
让 AI 主动帮忙,难点不只是发现事情,还包括判断什么时候值得打断人。用告警、待办和后台任务三个假设场景,拆开变化检测、去重、聚合与升级,让提醒真正带来下一步行动。
让 AI 帮忙盯着一件事,本来是想少操一点心。结果早上收到“我正在检查”,过一会儿收到“发现值得关注的变化”,下午又收到“提醒你还有待办”。每条都很礼貌,也不一定说错,但看完以后,自己的事情似乎更多了。
这里有个容易忽略的差别:发现了一件事,不等于现在需要通知一个人。后台任务可以很忙,人的注意力却不该跟着每次轮询一起忙。
LangChain 在讨论长期运行的 Agent 时,也把“怎样主动帮忙又不烦人”列为尚未解决好的问题:事件和定时唤醒给了 Agent 更多行动机会,同时也带来了更多打断人的机会。我更愿意把这看作一个具体的产品问题:这条消息到达之后,收件人究竟能多做哪一步?
来源:LangChain:长期运行 Agent 的上下文挑战
先分清检查、变化和通知
设想一个叫 demo-workshop 的公开活动资料站。它有报名页面、有几份等人确认的活动说明,还会在后台生成资料包。我们让一个 AI 助手照看它。下面所有时间、数量和情节都是为解释设计而构造的假设,不是某款产品的实测。
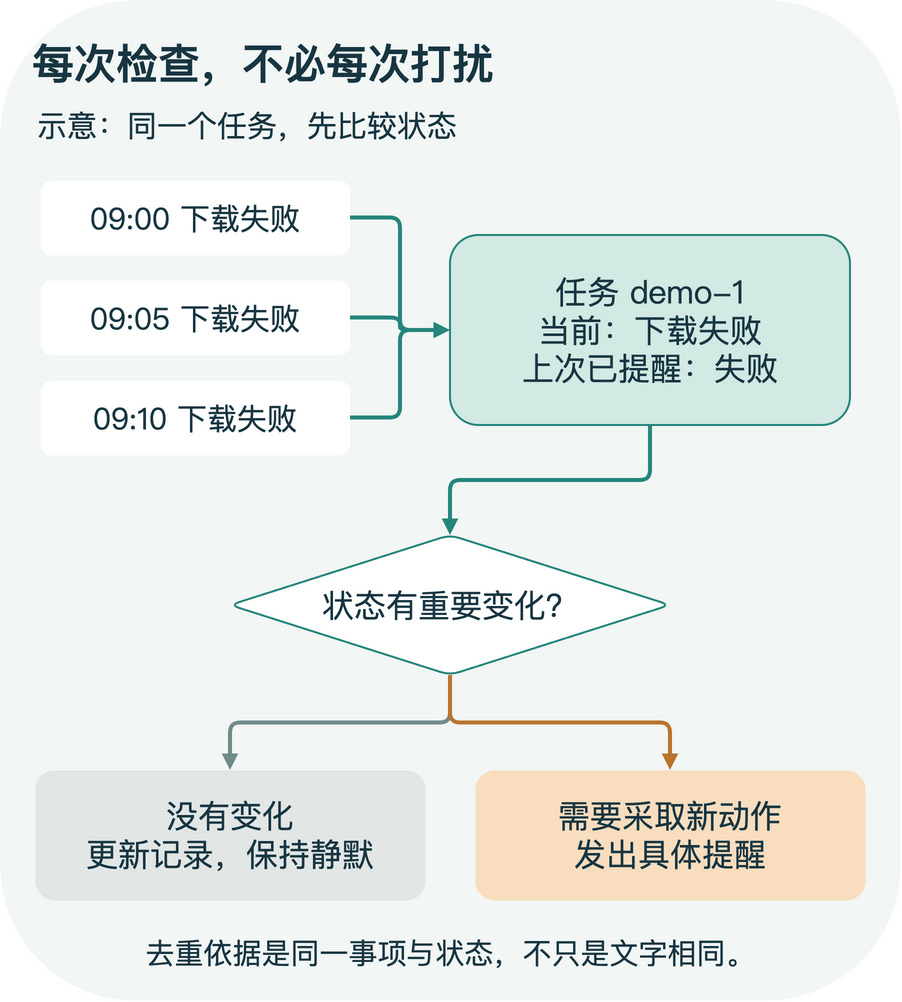
助手每隔一段时间检查一次报名页面,发现连续打不开。第二次检查时,页面还是打不开。第三次也一样。
如果每次都写一条新消息,人会收到三次“页面异常”。可从处置角度看,这很可能仍是同一件尚未解决的事情。检查是三次,事件是一件,通知不必也是三次。
因此,我会让系统分别记住三份东西:刚刚观察到了什么、这件事目前处于什么状态、上次已经向谁说到了哪一步。只留聊天记录不够,模型重读时可能把同一个问题换个说法,再当成新发现。
事件可以先按对象和问题类型建立稳定编号。例如“报名页面无法访问”始终归到同一条事件里,更新首次出现时间、最近检查时间和证据。通知记录则保存已发送的状态版本、接收人和发送结果。编号不要用 AI 临时生成的摘要,否则“页面异常”和“无法打开报名页”会变成两个不同的编号。
有了这层记录,助手才能说清“问题还在,但我已经提醒过”,也能辨认“现在与刚才不同,确实需要再告诉你”。这类记账适合交给程序做。AI 可以解释证据、组织文字,不必承担每次都重新猜一遍是否发过消息的责任。
这里还有一个边界:发送请求超时,不代表对方肯定没收到。通知状态应当保留“发送结果不明”,再根据渠道能力查询或补偿。直接把它改成“未发送”并重新投递,很容易造成重复。可靠性要求高的通知,至少要有稳定的发送编号;渠道不支持去重时,就不能承诺绝不会重复。
告警:再次打断,应当有新的理由
回到打不开的报名页面。第一条通知已经告诉负责人:页面异常,检查记录在这里,需要确认是否暂停报名入口。此后继续检查仍然必要,但“我又看了一遍,还是如此”不一定值得再次弹窗。
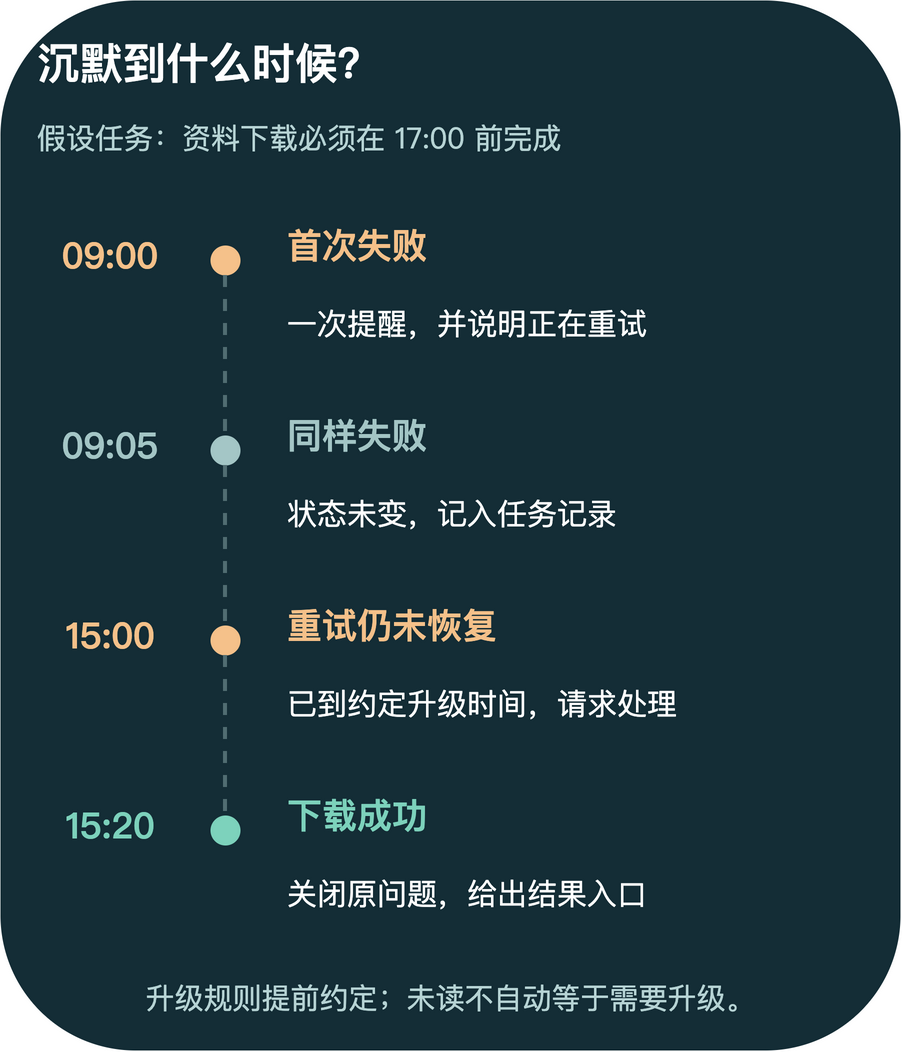
我会先约定哪些变化足以触发新通知。例如影响范围扩大,原本只有报名页不可用,现在活动详情也无法打开;或者已经到了约定的处理时限,还没有人接手。前者有新的影响,后者触发事先约定的升级条件。它们都比简单重复原话更有理由。
“已读”“已接手”“已解决”也要分开。已读只说明打开过消息,已接手说明有人负责,已解决则需要新的检查证据。把已读当成已解决,会让故障消失在记录里;把已接手当成完全没回应,又会在对方正在处理时不断催促。
对于一组相关告警,还应当把处置对象整理清楚。假设同一份资料包生成失败,连带出现“下载文件缺失”“预览不可用”“索引更新失败”,可以先合并成一条事件摘要,同时保留三个症状和对应证据。读者可以展开细节,不必先读三封信才能拼出全貌。
这类整理有成熟的工程参照。Prometheus 的 Alertmanager 提供去重、分组和抑制等机制:分组把相关告警放到一起,抑制则依据已配置的关系,在另一条告警存在时暂不通知某些告警。它们解决的是通知组织问题,不会自动替你证明故障根因。
来源:Prometheus:Alertmanager 的分组、抑制与静默
把这个思路搬到 AI 助手时,我尤其会保留最后这个限制。模型觉得几条报错“应该是同一个原因”,只能先作为待验证的解释。若它猜错后把其他告警全压下去,消息虽然少了,独立问题也可能被藏住。没有可靠依赖关系时,可以合并展示,别贸然删除或屏蔽。
恢复通知也有价值,但要与之前的异常连起来。报名页重新打开时,更新原事件,告诉已经接手的人哪些检查恢复正常,而不是另开一条毫无来由的“系统正常”。如果页面刚好成功了一次,后面又失败,是否足以判定恢复,就要由事先约定的检查条件决定。否则一会儿故障、一会儿恢复,照样会把收件箱变成摇摆的指示灯。
紧急通知的标准也要比“看上去有点异常”明确。Google 的 SRE 实践强调,呼叫值班人的告警应当有立即可执行的动作。对个人助手也可以借用这个问题:现在打断我,是让我做什么?若答案只是“知道一下”,通常有机会放进稍后的摘要。
待办:截止时间之前,什么时候提醒才有用
同一个活动资料站,还有一份明天下午要公开的说明,正在等待用户确认。它没有系统故障,照搬故障告警的升级方式就很别扭:五分钟没回应一次、十分钟没回应再一次,反而像不断催促。
这时,提醒时点要围绕行动窗口设计。假设确认后还需要一小时排版,排版后还要留出复核时间。只在发布前一分钟提醒,虽然及时发现了“即将截止”,实际上已经没有从容处理的余地。系统应该把完成后续动作所需的时间算进去,再由用户确定合适的提醒规则。
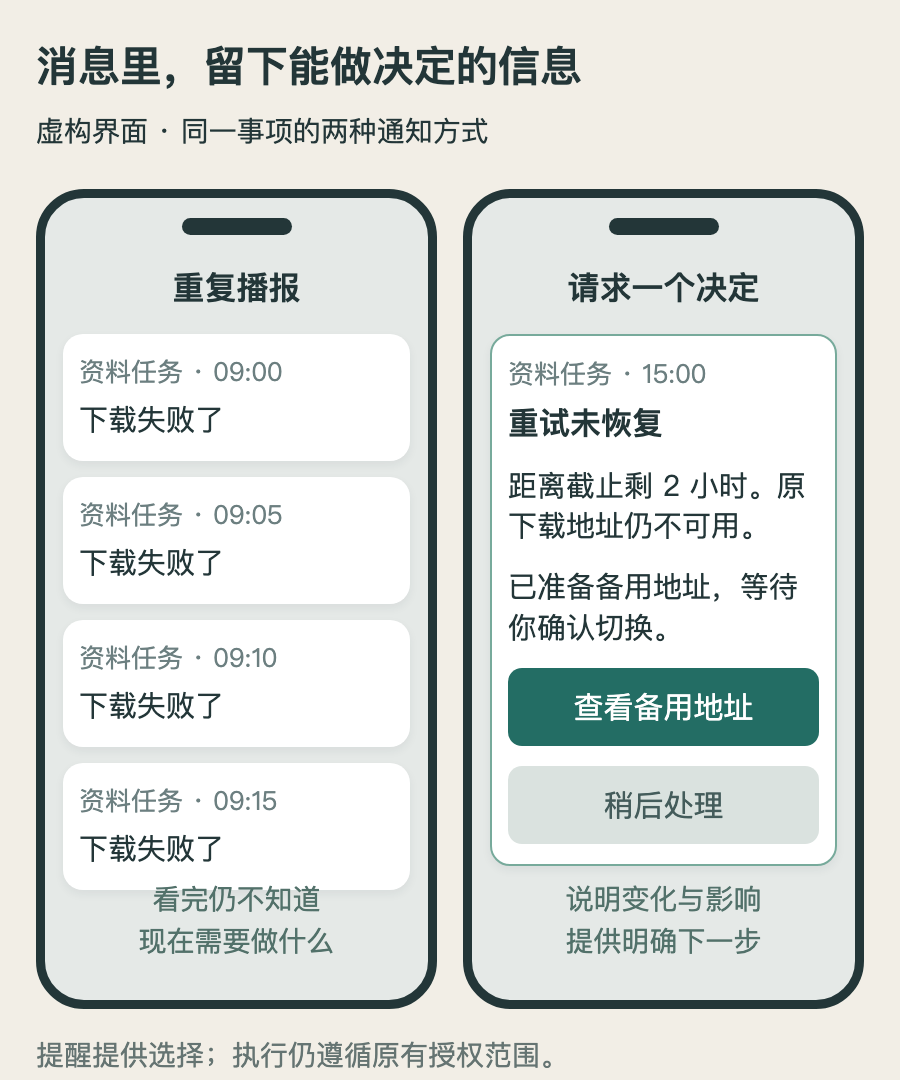
我会让提醒直接带上待确认的内容,而不是只说“你有一项待办”。例如:“活动说明剩两处待确认:开始时间和报名上限。确认后才能生成最终资料包。”用户打开后知道该看哪里,才有可能一次处理完。
延后也不该只有一个模糊的“稍后”。“今天傍晚再提醒”“等新版本来了再提醒”“这次不再提醒”,对应不同条件。第一种是时间,第二种是事件,第三种是对当前事项的偏好。系统若把它们全理解成“过半小时再发”,就没有真正听懂反馈。
同样,不回复不能自动推断成“这类事都不重要”。用户可能正在忙,可能没有看到,也可能已经在别处处理。助手可以记录没有收到确认,但不要据此擅自把整个类别的优先级永久调低。要学习偏好,明确的反馈比猜测沉默更可靠。
多项待办一起出现时,汇总也要保留区别。三份说明都等确认,可以放进同一条摘要,但每份都应保留截止时间、未决问题和入口。不能只写“共有三件事”,让用户再挨个追问。若其中一份已经临近最后处理时间,它应当从普通汇总里单独提出来。聚合节省的是重复打开消息的成本,不是抹平每件事的紧迫程度。
偏好本身还应该有范围。用户说“这场活动的进度晚一点汇总就行”,不等于允许所有紧急事项都延后。至少保留适用对象、条件和到期时间;活动结束以后,这条临时安排就不该继续影响下一次活动。让 AI 记住反馈很有用,但把临时要求记成永久规则,会制造另一种漏事。
后台任务:少报流水账,多报交付和阻塞
再看资料包生成。助手可能经历下载图片、整理文件、转换格式、压缩打包、检查产物等步骤。如果每完成一步都来报告,用户仍然得持续盯着任务,只是从看终端变成了看聊天框。
对于这种已经明确交付目标的工作,我更想知道三类情况:结果可用了;遇到必须由我决定的阻塞;原先约定的完成时间或交付范围发生明显变化。其他步骤可以留在可展开的进度记录里,需要时再看。
假如一张插图的下载地址失效,助手已经获得替换为占位图的授权,就可以继续处理,并在交付时说明替换项。如果这张图是活动地点地图,缺失会影响资料包的用途,就应当及时说明阻塞,提出具体选项。是否提醒,取决于它对交付的影响,以及剩余动作是否还在已有授权内。
一条有用的阻塞通知,可以很短:“资料包已整理好,地图链接失效。其余内容检查通过;需要你提供替代地图,或确认本次去掉地图后交付。”这比“发生错误,请检查”多做了一步,也比把十几行错误日志直接推过来更容易处理。
任务完成的消息也应当有可访问的结果和边界。压缩命令退出成功,不一定代表资料完整;上传接口返回成功,也不一定代表下载链接能打开。通知里说“已完成”的依据,应当对应用户要拿到的东西。能检查文件、链接或页面,就先检查,再报告结果。
主动帮助还不意味着扩大权限。可以发现说明中有错字,可以准备修订稿,但“已经替你发给所有报名者”是另一种动作。需要批准时,把具体稿件和影响范围准备好,一次提出明确请求;反复询问已经授权的步骤,也会成为消息噪音。
少发消息之后,还得检查有没有漏事
一个全天不发消息的助手,当然不会烦人,但也可能没有帮上任何忙。因此,不能把“通知数量下降”单独当成成功指标。
我会抽取一段时间内的完整事件记录,回看几件具体事情:有多少通知带来了实际处理;同一件事被重复打断了几次;必须处理的事项有没有错过行动窗口;用户需要补问多少次,才知道该做什么。这里先看个案和原因,比急着合成一个总分更容易改进设计。
尤其要检查没发出来的那部分。比如被合并的事项里是否藏着独立故障,被延后的待办有没有已经失去处理余地,被判定为“常规进度”的消息是否其实意味着任务卡住。只有成功送达的消息,没有那些被推迟和压下的记录,就无法评价取舍是否合理。
可以先让新规则试运行:照常检查并记录“本来会通知谁、为什么”,但先不给用户新增打断。拿这些记录与真实处置过程比较,修正明显不合理的触发条件,再逐步开启。试运行仍需覆盖任务失败、无人响应和恢复等情况,只观察一段平静时期不够。
我希望一个主动助手越来越懂得节省我的注意力:它知道什么已经说过,知道哪些变化值得再说,也知道一句“需要你确认”之前,还有哪些准备工作可以自己完成。收到消息时,我能直接决定下一步;没收到消息时,也有地方查看它究竟检查了什么。这才像有人替我盯着,而不是多了一台不停响的闹钟。
评论