显存装不下,为什么让模型多算一遍反而能训练?
训练不只要放下权重,还要留住反向传播需要的中间结果。用一段可手算的计算和一笔假设显存账,看懂激活检查点怎样用重算换空间,以及哪些函数不能随便重放。
模型已经成功加载到显卡上,输入也送进去了,训练却在半路报显存不足。一个常见建议是:打开激活检查点,让部分计算再跑一次。
乍看这个建议,我觉得有点绕。空间不够,为什么不是少做一点,反而要多算?关键在于,计算需要多长时间,与计算过程中必须同时留下多少东西,并不是同一笔账。
就像在小桌子上推导一道长题。可以把每一步草稿摊开,回头随时查;也可以只留下几个关键位置,后面用到某段推导时再写一遍。后者费一点笔墨,却不必让整道题的所有草稿一直占着桌面。
激活检查点做的正是类似的交换。它也叫 activation checkpointing,有些训练工具称为 gradient checkpointing。这里的“检查点”不是保存到硬盘、方便明天接着训练的断点文件,而是同一次训练计算里面,为重新算出中间结果留下的入口。
反向传播为什么还要看前面的答案
先不用大模型,想一个只有两步的小计算:先算 a = w × x,再算 y = a × a。如果要知道参数 w 变一点会让 y 变多少,就要沿着这两步往回算。
取一个假设例子:x = 3,w = 2,于是 a = 6,y = 36。第二步对 a 的导数是 2a,第一步对 w 的导数是 x,合起来就是 2a × x = 36。这些数字只为手算原理,不是模型训练结果。
问题出在那个 a 上。反向计算需要知道它当时是多少。只保留最终答案 36,并不能普遍替代中间值;平方会丢掉符号,复杂网络还会经过更多无法直接倒推的操作。
自动求导因此会按运算需要保存一些张量。不是把所有计算历史逐字抄一遍,也不是每一层都保存完全相同的东西;不同运算的反向公式需要不同材料。
把标量换成一批句子里的大量向量,再叠上许多层,这些“留着等会儿用”的结果就会变大。参数量没变,输入批次、序列长度或网络中间表示变了,训练时需要的空间仍可能明显变化。
我更愿意把权重理解成解题规则,把激活理解成这一批题产生的草稿。两者都占地方,却回答不同问题。只看模型文件多大,像只看一本教材多厚,就判断书桌能不能摊开整套练习。
丢掉草稿,但保留能重做的起点
假设模型里有连续的三段计算 A、B、C。输入 x 先得到 a,再得到 b,最后得到 c。普通做法会为反向传播留下其中需要的中间结果。
如果把这一整段划成一个检查点区域,就可以保留入口,减少区域内部为反向传播长期保存的张量。等反向走回来需要它们时,再从入口重算相应部分,把材料补出来。
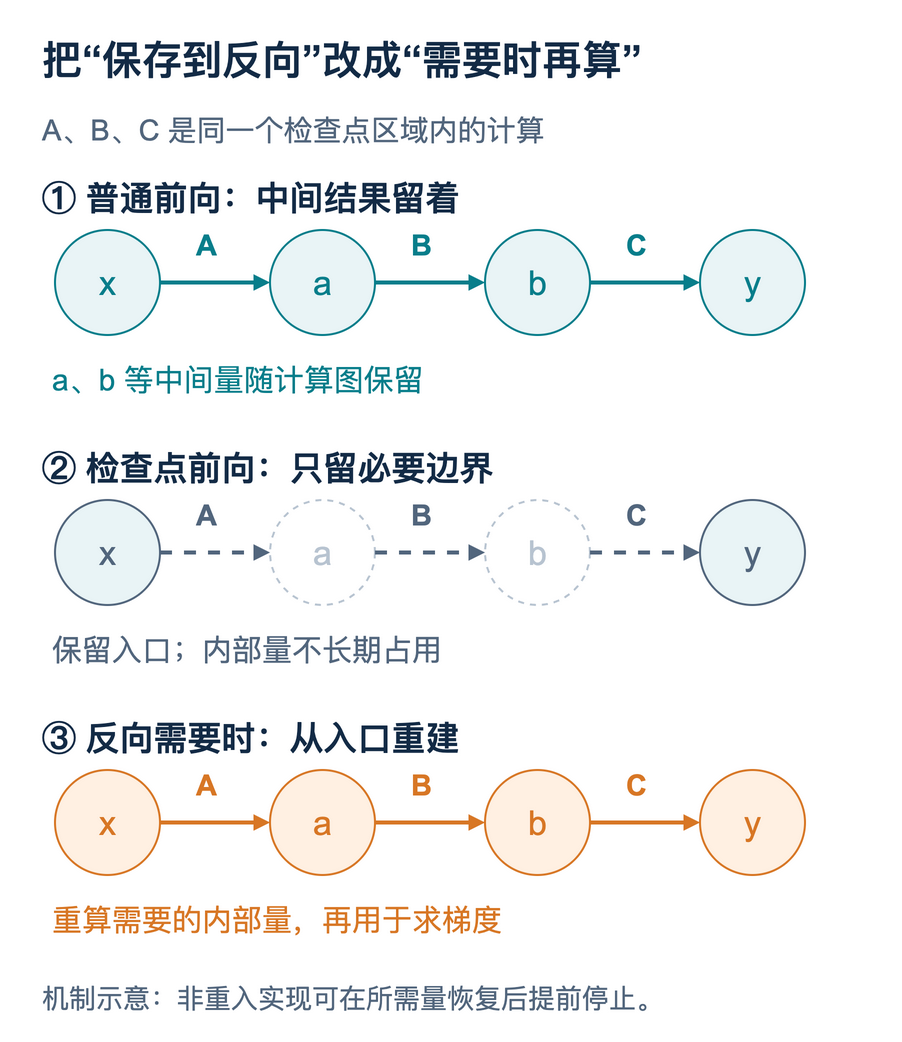
回到刚才的平方例子,若没有一直留着 a = 6,但还有相同的 x = 3 和 w = 2,就能重新乘一次得到 a,再完成导数计算。省的是等待期间占着的空间,付的是重新计算的时间。
这也说明,重算不等于多训练了一轮。重算是在为同一批数据的反向传播补材料,并没有因此多做一次参数更新。把一段前向再跑一遍,与让优化器再迈一步,作用完全不同。
还有一个容易想过头的地方:既然能重算,是不是只存原始输入就够了?数学上的可恢复与工程上的划算并不相同。区域太大,可能重复很多昂贵计算;区域太碎,又会留下不少边界输入。真正要选的是在哪儿分段,以及愿意用多少时间换多少空间。
当前 PyTorch 文档推荐显式使用 use_reentrant=False。这种实现可以在需要的张量已经补齐时提前停止重算,因此“每一层必定完整算两遍”只是粗略比喻,不能拿来精确估计耗时。
下面只是调用位置示意,block 代表已经定义好的模型子模块,hidden 是它的输入;不是一份可直接启动训练的完整程序。
from torch.utils.checkpoint import checkpoint

hidden = checkpoint(block, hidden, use_reentrant=False)
我会先从边界清楚的一段开始试,而不是把数据读取、日志、整个训练循环都塞进这个调用。检查点区域越像一个“给定输入就返回输出”的计算单元,就越容易判断重放是否改变了含义。
再用桌面上的草稿做一次选择。假设 A 很容易重做,却产生很大一摞中间材料;B 计算很久,留下的材料却很少。只按“每隔几层设一个点”切分,未必照顾到了这种差别。把 A 纳入重算,可能是一笔好交易;为了省下一小页纸反复重做 B,就可能很亏。这是选择边界的思路,不是对某种真实层的性能保证。
边界输入本身也有体积。把每一个很小的运算都单独包起来,并不等于省得最多,因为它们之间传递的张量仍可能要保存。反过来,把全部计算包成一个巨块,也不能保证整个过程都轻巧:反向补材料时,仍需要空间容纳当前正在重建和使用的东西。要比较的是完整步骤里的峰值,而不是只数代码里写了几个检查点。
一笔能算清的显存账
假设我们有二十四格可用空间。为便于解释,把权重、梯度和优化器等非激活部分在关注的时刻合并算十四格,激活算十二格,其他开销暂算两格。合计二十八格,超过预算。
再假设选对了检查点区域,激活占用由十二格降到五格,其余两项在这张玩具账单里保持不变,总数就变成二十一格。原来装不下的计算,现在可能装得下了。
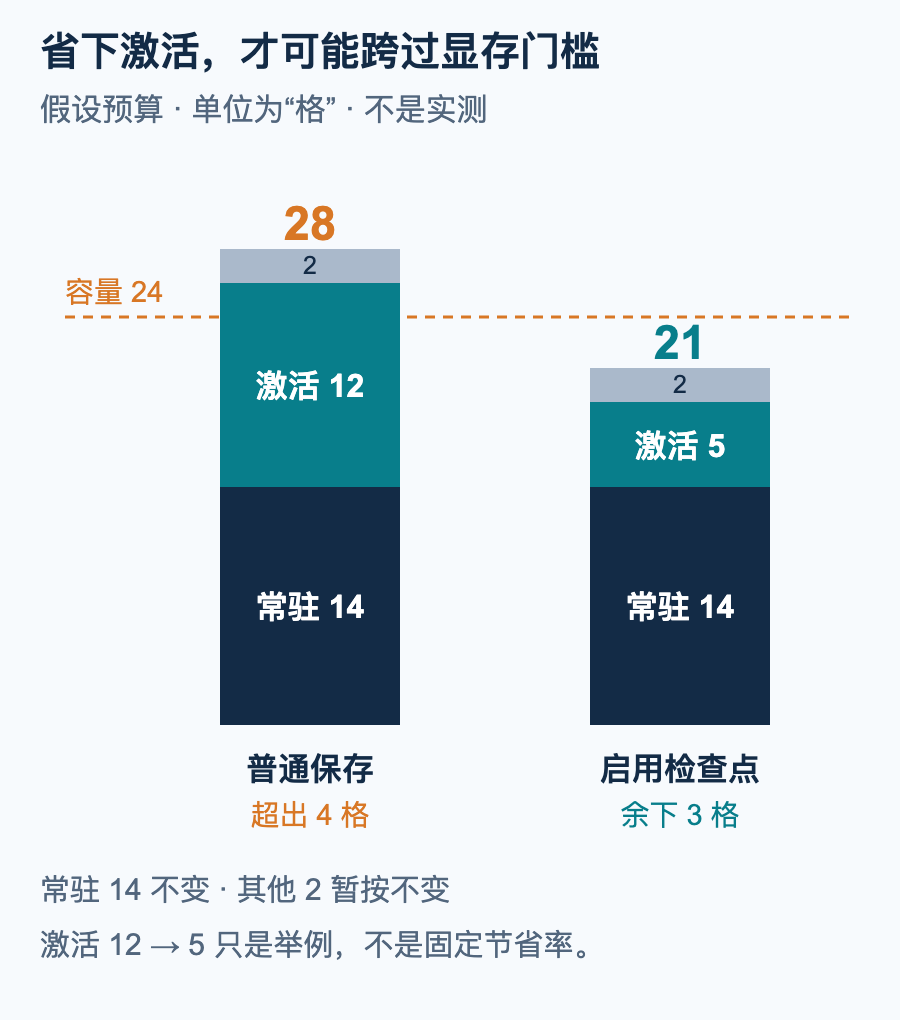
这里最值得看的不是七格,而是哪一项变了。激活检查点没有把所有权重压小,也没有自动清空优化器历史。若十四格那一项本来就超过预算,再怎么削减激活,也不能凭空让它消失。
真实显存使用还会随时间变化。梯度逐渐产生,临时张量申请又释放,优化器可能在第一次更新时才建立状态。上面的加法只是一张指定时刻的假设账单,不能把不同阶段各自的最大值简单相加,当成实际峰值。
PyTorch 的优化器内存教程就展示了一个峰值出现在更新阶段的例子。这提醒我,报错发生在哪一步非常重要:如果最紧张的时刻不靠激活支撑,检查点可能省了不少中间结果,却没有解决真正的峰值。
再换一个反例。假设程序把每个批次的输出都存进列表,准备训练结束后一起分析,而这些输出仍连着计算图。持续增长的占用可能来自程序自己保留的引用。给模块加检查点,并不能替我们决定这些历史输出何时可以丢掉。此时要先检查数据到底被谁握着,而不是不断增大重算范围。
所以我不会把“显存不足”直接翻译成“检查点没开”。更有用的第一问是:权重还没放好就失败,前向进行到某层失败,还是反向与更新时才失败?同一句报错,背后的账单可能完全不同。
重放一遍,必须还是原来的计算
再算一次能够补回材料,有个隐含条件:重算时的规则不能偷偷变了。
想象一个假设函数,每调用一次,就把全局计数器加一,再用这个计数器乘输入。第一次得到的是“输入乘一”,重算得到的是“输入乘二”。形状没变,程序甚至可能继续跑,但它已经不是在重建第一次前向的材料。
哪怕计数器只用于日志,也会让调用次数失去原来的含义。把“函数被调用次数”当成“处理批次数”,在启用重算后就可能高估进度。涉及更新运行统计、缓存或外部状态的模块,也要单独检查,不能因为它叫一个层,就默认重放无副作用。
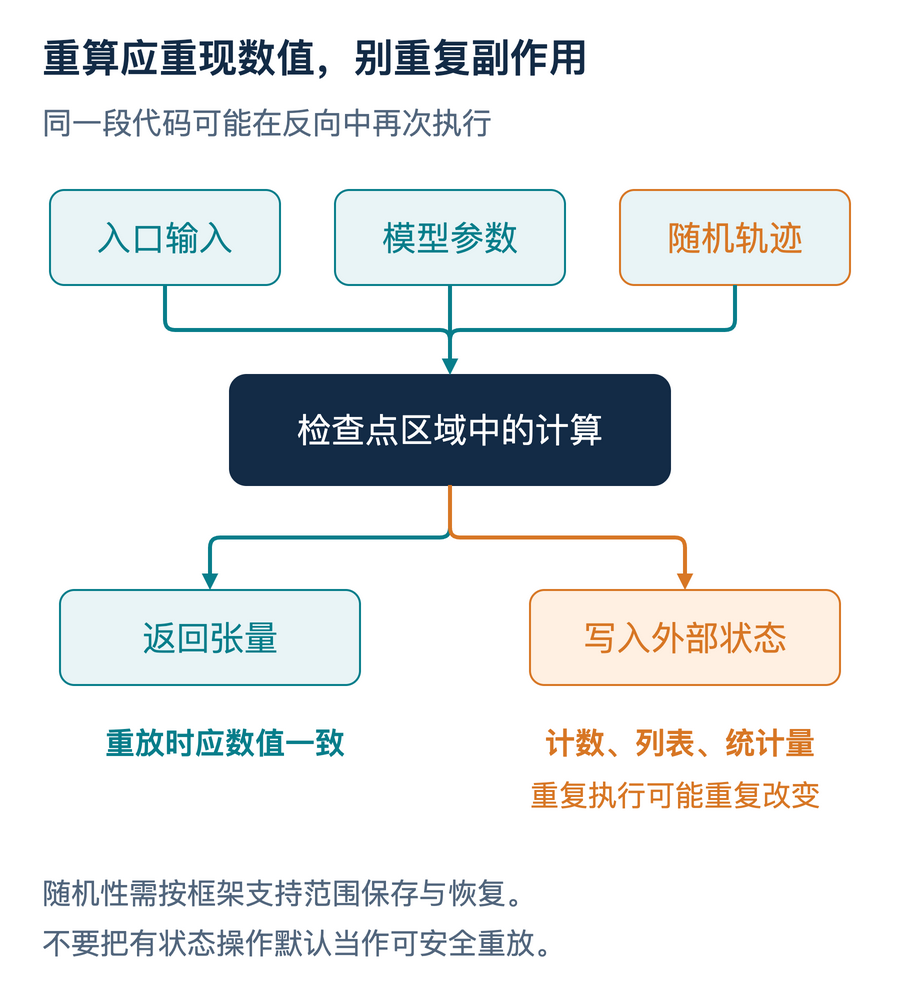
随机操作也需要照顾。比如 Dropout 第一次挡住一组元素,重算时若挡住另一组,用来反向传播的就不是同一次随机计算。PyTorch 默认会保存和恢复相关随机数状态来处理常见场景,但有设备类型和函数内部迁移设备等边界,不能据此推断任意随机代码都被完整接管。
默认的一致性检查也不是逐个数值验算梯度正确性。因此,没报错只能算一条运行证据,不能替代和不开检查点的版本做对照。
来源:PyTorch checkpoint 的随机状态与一致性约束
对开头的三段小网络,我会先缩小输入到两边都装得下,复制相同的初始状态,并让两次计算从相同的随机条件开始。分别跑普通版与检查点版,比较损失、关键参数梯度,以及一步更新后的参数。
如果只是最终分类都答对,很容易掩盖梯度已经不同的问题。另一方面,浮点计算也不该一律要求逐位相同;要根据数据类型和运算设置合理容差,并调查超出容差的差异,而不是为了通过比较不断放宽标准。
省下来了,还要看值不值
正确性站稳以后,才轮到性能。固定模型、输入形状和精度,在同一设备上比较完整训练步骤;先预热,再测多次。否则第一次初始化的开销,可能恰好落在其中一组,看起来像检查点特别慢或特别快。
GPU 执行还有异步性。只在提交调用前后读一次普通时钟,可能量到的是任务送出去的时间。可以使用能正确同步的计时方法,例如 PyTorch 的基准工具,而不是看到一个很短的数字就下结论。
空间也要看对指标。分配给张量的内存,与分配器预留、等待复用的内存不是一回事。PyTorch 的峰值分配指标可以帮助比较,但它不能代表设备上其他进程和所有外部库的占用;显卡监控里的数字不下降,也不必然说明张量没有释放。
选择工具时,我会把目标再说具体一点。若只是单个批次太大,可以评估减少微批次并累积梯度;若合适的计算能用更低精度,可以评估混合精度。这些方法改变的地方不同,不该把几个开关同时打开,再把全部收益归给检查点。
累积梯度是分几次计算,再按设计的时机更新;混合精度会为不同运算选择合适的数据类型。它们与检查点可以组合,但组合后仍须检查损失缩放、更新频率和模型行为,尤其不能默认“小批次累加”在所有有批次依赖的模型里都等价于一次大批次。
还有两种比较最好分开做。第一种固定批次,问加了检查点以后每步多花多久、峰值降了多少;第二种利用省下的空间增大批次,问单位时间最终处理了多少有效样本。第二种即使吞吐提高,也不能倒过来说“重算没有成本”,因为比较条件已经改变。
同样,跑通一个短输入只是起点。如果实际训练里有长短差异很大的句子,短样本通过,最长那一批仍可能溢出。应该保留有代表性的长输入,走过前向、反向和更新的完整过程,再决定是否留够了余量。对资源优化来说,最好的一次结果很漂亮,最紧张的那一步能不能过去却更关键。
我觉得激活检查点最实用的地方,是让“能不能训练”和“每步有多快”可以分开取舍。原来必然溢出的任务,只要多花一点合理的计算时间就能继续,这笔交易可能很值;若空间本来宽裕,额外重算也可能只是徒增等待。
先看清桌面上堆的究竟是什么,再决定哪些草稿值得留下、哪些可以重写。多算一遍并不会让显卡变大,它只是改变了我们必须同时保留多少东西。
评论