权重明明存好了,为什么训练接不上?
模型权重记录了学到哪里,优化器还记着怎么走到这里。用一个可手算的例子,分清推理文件、训练断点与严格复现,并学会检查一次恢复究竟恢复了什么。
假设我们训练一个识别圆形和方块的小模型。跑到一半,保存权重,关掉程序。第二天重新加载,拿同一张测试图试一下,输出与昨天一致。看起来保存成功了。
接着训练,损失曲线却和原来不太一样。学习率明明写着相同的数,模型结构没改,数据也没换。问题出在哪里?
我觉得最容易漏掉的一件事,是把“模型现在会什么”和“训练接下来怎么走”当成了同一份东西。权重可以回答前一个问题,后一个问题往往还要问优化器、学习率调度器,以及数据读到哪里。它们各自握着一小段历史。
这里的训练场景和后面的数值都是解释原理的假设,不是一次实测记录。我们先把模型缩到只有一个参数,看看少存一个数,会怎样改变下一步。
同一个位置,可以有两种下一步
把参数想成山坡上的位置,把损失想成海拔。梯度告诉我们眼前坡度,学习率控制迈步幅度。如果使用不带动量的普通梯度下降,同一位置、同一批数据、相同计算规则和学习率,下一步就由当前梯度决定。
但带动量的优化器会把过去的梯度积累起来。它不只看眼前这一脚,还保留之前的方向。像推着一辆小车下坡,车在哪儿和车正怎么移动,是两件事。
用一个简化的一维动量更新来算。设参数是 1.00,旧动量是 2,当前梯度是 1,动量系数是 0.9,学习率是 0.1。不考虑权重衰减、阻尼和 Nesterov 等额外选项。
保留历史时,新动量是 0.9 × 2 + 1 = 2.8,参数走到 1.00 − 0.1 × 2.8 = 0.72。
如果只加载参数,重新创建优化器,把历史动量丢掉,同样的当前梯度会让第一步使用动量 1,参数走到 0.90。两边出发的位置一样,眼前看到的坡度一样,连学习率都一样,下一步仍然不同。
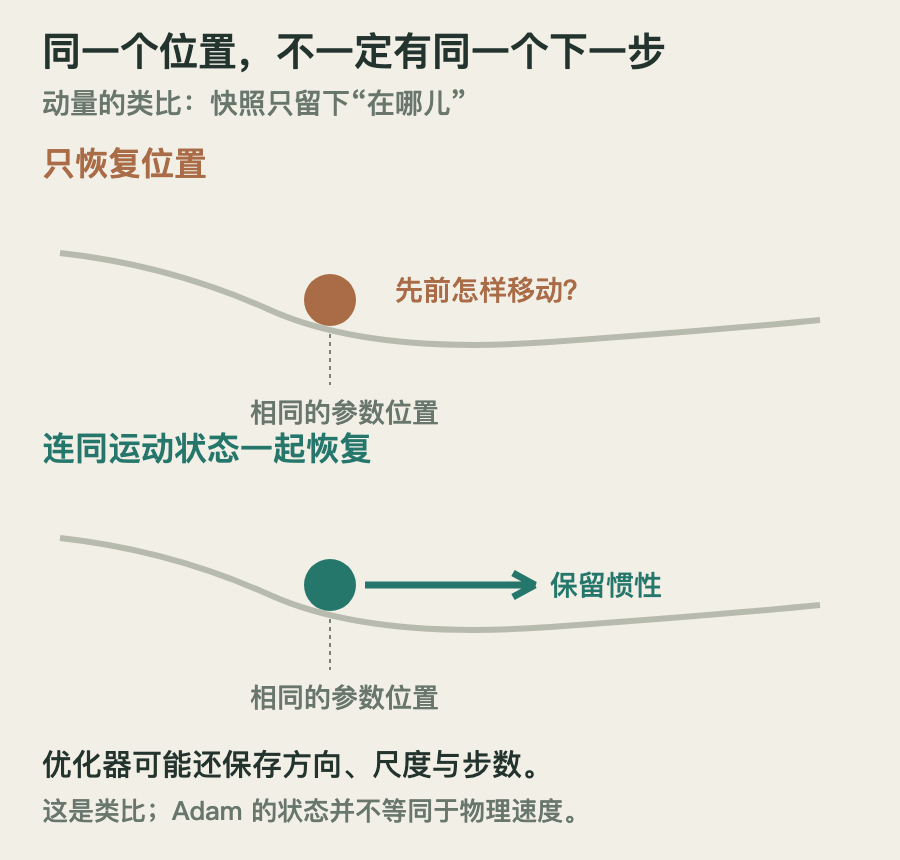
这个差别并不意味着重新开始的那条路一定更差。它说明的是:我们已经改变了训练过程,却可能还以为自己只按了一次暂停键。后续碰到的梯度又取决于新的参数位置,差异便可能继续传下去。
Adam 记住的,还不只一个方向
常用的 Adam 维护两类按参数积累的统计量:梯度的一阶矩估计,以及梯度平方的二阶矩估计。可以粗略理解为,一份记录近期方向,另一份记录近期梯度的量级,用来调整不同参数的更新尺度。
这里的二阶矩不是“模型更有把握了”,也不能直接当成梯度方差。它参与的是更新计算,不是回答问题时的置信度。Adam 还会按更新次数进行偏差修正,因此历史统计和计步状态都可能影响下一次更新。
把权重搬回来,却让这几份记录从头开始,得到的是“从已经学过的位置重新出发”。模型学会的图形特征没有因此全部消失,但优化器此前形成的节奏被打断了。
这也解释了为什么训练断点常常比用于推理的参数文件大。文件里可能装着每个参数对应的额外统计,而不是只多写了“第几轮”几个字。具体占多少空间,取决于优化器、数据类型、是否分片以及保存了什么,不能把某个倍数当成所有训练的固定成本。
回到圆形和方块的例子:刚加载后,测试图输出相同,只能证明这次前向计算用到的模型状态接上了。优化器此时还没迈步,它的历史即使已经丢了,也不会直接在这一张测试图上暴露。
所以“加载后还能识别”和“恢复后沿着原来的过程训练”,应该分别检查。前者是必要的一关,却不足以替后者签字。
一份断点里,究竟要装什么
我会先把保存目标分成两类。只是准备拿模型做预测,需要保留足以重建推理行为的内容,包括模型配置、参数、必要的持久缓冲区,以及相应的输入处理规则。准备中断后接着训练,就得再保存训练的活动状态。
在 PyTorch 中,模型的 state_dict 不只是口语里说的权重和偏置,也包含注册的持久缓冲区,例如某些层积累的运行统计。不过,网络怎样搭建、文本怎样切词、类别编号怎样对应,不能默认都藏在这份字典里。
优化器有它自己的 state_dict。保存模型的那份,不会自动把优化器的那份一起带走。名字都叫“状态字典”,不表示它们属于同一个对象。
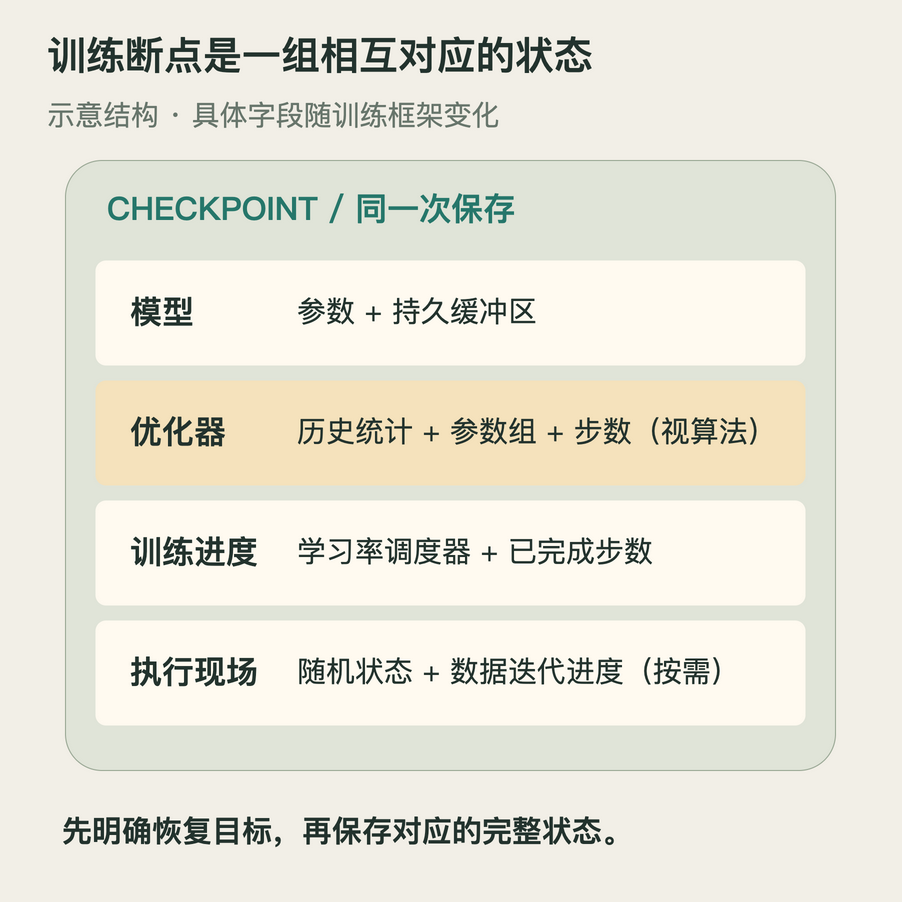
学习率也不一定是写在配置里的一个常数。假设小模型原计划先预热,再逐步降低步幅。中断时已经走到后半程,恢复后却把调度器重新从头计时,后面的步幅安排便会改变。即使刚加载时读到的学习率恰好相同,再走几步也可能分岔。
因此,需要恢复调度器状态,并检查恢复后的实际学习率与下一步调度是否符合预期。加载顺序也有讲究:PyTorch 的优化器文档提醒,应该先初始化学习率调度器,再加载优化器状态,避免初始化过程覆盖已经恢复的学习率。复杂组合要遵循所用组件的恢复约定,不能靠挪动几行代码碰运气。
如果使用带梯度缩放的混合精度训练,缩放器也是有状态的。它会影响如何处理梯度数值范围,恢复时应连同保存。没有使用这个组件的训练,自然不必为它制造一份空状态。
“第十轮”不是准确的书签
假设一轮有很多批数据,训练在第十轮中间断了。文件只写着 epoch=10,我们究竟应该从这一轮开头重读,还是从下一轮开始?前者可能重复一部分样本,后者可能漏掉剩下的样本。
所以进度字段必须有清楚的含义:它表示“已经完成到哪里”,还是“下一步从哪里开始”?除了轮数,往往还需要更新步数、批次或采样器进度。数据如果重新洗牌,仅有批次编号也未必能找回同一批样本;还要考虑那一轮的排列怎样重建。
这里有个很实用的取舍:能接受从轮末恢复的小任务,可以在每轮完成后保存,降低中途定位的复杂度。单轮很长的任务,则值得使用能恢复采样和读取进度的训练框架,并验证它实际覆盖到哪一步。不要把“文件里有 epoch”误当成“数据一定接得上”。
随机数还有类似的书签问题。给程序设置同一个种子,通常是在指定同一条随机序列的起点。训练已经消耗了一段随机数之后,重新回到起点,不等于回到中断位置。
随机打乱、数据增强和 Dropout 都可能消耗随机数。如果追求更严格的续跑,就要考虑所用随机数生成器的当前状态;Python、NumPy、CPU、加速设备及数据工作进程也可能各有来源。哪些需要记录,取决于训练程序真正使用了哪些组件。
哪怕这些都处理了,也不能无条件承诺换个环境仍逐位一致。PyTorch 官方明确说明,跨版本、不同平台,甚至 CPU 与 GPU 之间,都不保证完全可复现。相同种子不是通行证。
先决定在哪个时刻按暂停
还有一种容易漏掉的情况:为了模拟更大的批次,程序可能连续处理几个小批次,积累梯度,最后才让优化器更新一次。如果刚积累了一半就保存,普通的模型状态字典并不会替你保存这份未完成的梯度积累。
最容易解释和验证的保存点,是一次完整更新结束、相关状态都已推进到同一时刻之后。若必须在中间停,就得额外处理尚未完成的梯度和进度。否则,模型记录的是一个时刻,数据书签却跑到了另一个时刻,恢复后就可能少算或重复算。
混合精度教程也强调保存时机:可以在一次迭代尚未前向计算前保存,或在末尾完成缩放器更新后保存。它背后的道理很朴素:存档里的几份记录要对应同一个暂停点。
这让我想到游戏存档。人物坐标正确,背包正确,但任务进度来自几分钟前,读档也不算真正回到了原来的现场。训练断点的完整性同样来自状态之间能对得上,而不是文件字段越多越好。
不要等断电后,才第一次试着恢复
我会在正式长跑之前做一次短的恢复演练:把同一份小任务分成“连续跑”和“中间保存、退出、重新加载再跑”两条路径。先固定可控制的条件,避免一边还在修改数据,一边判断保存机制是否正确。
恢复后先看模型输出,再看优化器状态、更新步数、当前学习率和下一批数据。随后比较下一次更新以及接下来几步的损失。若目标只是恢复训练,事先约定可接受的数值偏差;若目标是严格复现实验,就把随机性与确定性设置也纳入检查。
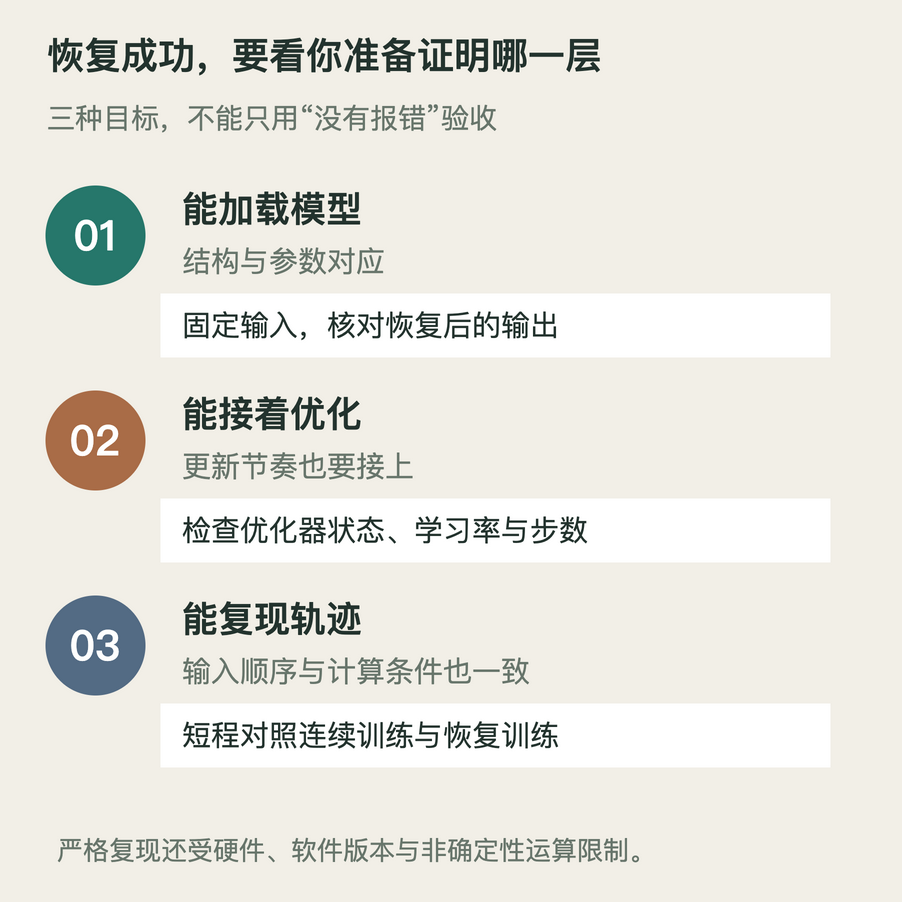
关键是找最早出现差异的地方。如果更新前输出就不同,先查模型状态、模式、输入处理和随机操作;如果输出一致而下一步参数不同,再查优化器、学习率、梯度积累和实际批次。比起盯着很久以后的准确率,这样更容易把问题缩小。
保存文件本身也要验证。写到一半中断的文件,存在于磁盘上不等于可用。可以先写临时文件,成功后再替换正式断点,并保留一个已验证的旧版本。具体做法还要结合本地文件系统或对象存储的语义,不能把“重命名”当作跨所有存储的万能保证。
恢复演练还有一个好处:它会逼我们记录文件之外的条件。假设小模型原先把类别编号零解释成圆形,恢复程序却把零解释成方块,数值输出即使完全相同,读出来的答案也反了。数据版本、类别映射、预处理配置和训练代码版本值得与断点一起留档。它们未必属于优化器状态,却决定我们是不是在继续同一个任务。
同样,模型层数、可训练参数集合或优化器参数分组发生变化时,不应把旧状态硬塞进去,再用“加载没有报错”证明正确。参数形状相同也不等于含义相同。恢复前明确检查配置是否匹配,远比事后猜测一条异常曲线可靠。如果确实要改网络或解冻新的层,就把这次变动记为新的训练阶段,单独验证新旧状态怎样衔接。
最后还要区分“最新”和“最好”。最适合接着训练的,往往是最新且完整的断点;最适合拿去预测的,可能是验证集表现更好的较早版本。两者可以分别保存,不必强迫一个文件同时承担两种角色。
当然,也有意丢掉优化器历史的场景。换数据、换训练目标、重新微调时,从已有参数开始配置新的优化过程很正常。重要的是知道自己做的是一次新的训练阶段,而不是把它误记成原任务的无缝续跑。
我现在更愿意把权重看成“已经学到的结果”,把训练断点看成“足够接上下一步的现场”。先说清楚要接上哪一步,再决定保存什么,往往比等曲线变了以后重新训练更省事。
评论