模型没换,切到评估模式为什么就变了?
同一张图片、同一份权重,train 和 eval 却可能给出不同结果。从 BatchNorm 的两把尺子讲起,分清评估模式、关闭梯度与真正的参数更新。
假设我们训练了一个识别圆形和方块的小模型。训练时看着不错,把同一张图送进验证程序,结果却变了。没有重新训练,也没有加载另一份权重,程序只多了一句 model.eval()。
这很容易让人怀疑:评估模式是不是把模型的某种能力关掉了?更让人困惑的是,把这句删掉,换成 torch.no_grad(),结果可能又接近训练时。
我觉得这里最值得先弄明白的,是三个看起来很像的动作:按什么规则算结果,要不要记录求导过程,以及有没有真的更新参数。它们可以分别发生,不能靠一个“现在不训练了”的想法全部概括。
同一个数,换一批同伴就换了位置
先看 Batch Normalization,通常简称 BatchNorm 或 BN。它会把一组中间特征放到一个共同尺度上:先减去均值,再除以标准差。这里处理的是网络某层的数值,不一定是原图的亮度。
举个可以手算的假设例子。为了只看清归一化,我们只保留一个特征,暂时忽略防止分母为零的很小常数,也不加后面的缩放和平移。
第一批有两个数:2、4。均值是 3,按总体方差口径算,标准差是 1。于是 4 归一化之后是 (4−3)÷1=1,意思是它比这一批的中心高出一个标准差。
第二批换成 4、8。均值变成 6,标准差变成 2。还是那个 4,现在得到 (4−6)÷2=−1。它没有变,参照它的那群数变了,于是相对位置反了过来。
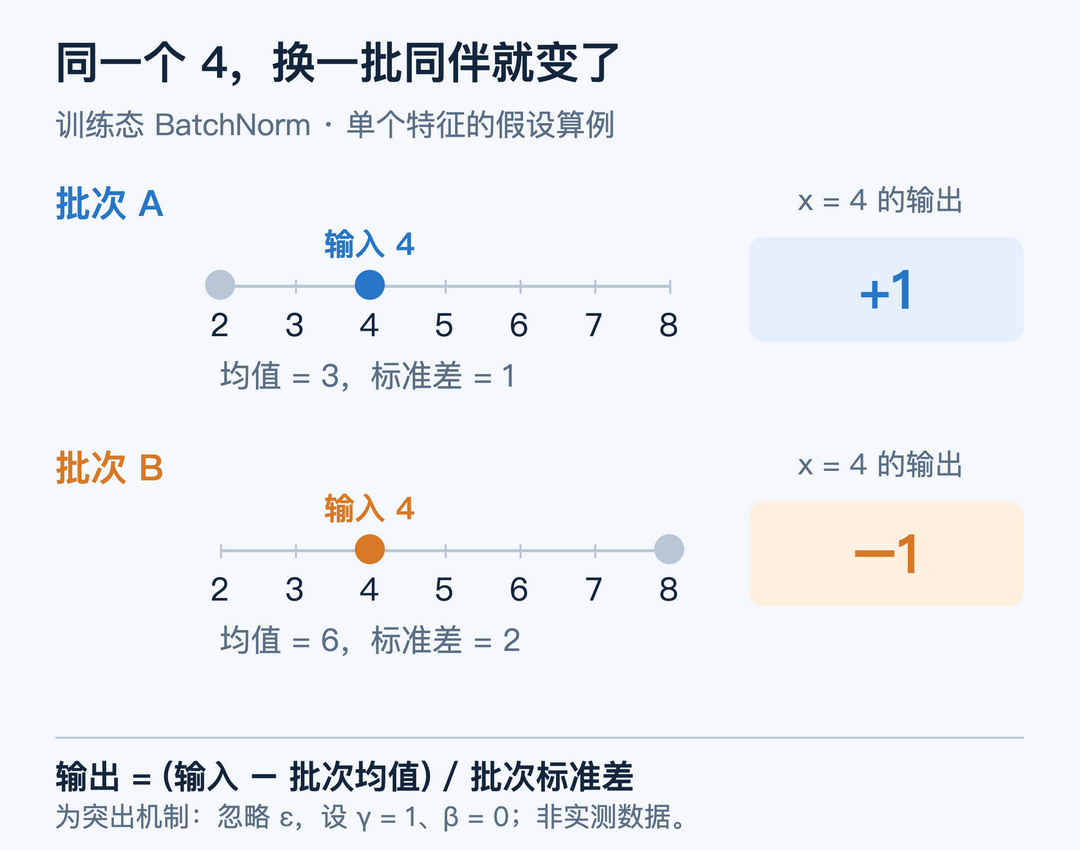
这不是模型偷偷改了权重,也不是计算出错。计算规则本来就在问“你相对于这一批处在什么位置”。像同样高的一棵树,放在幼苗旁显得高,放在成熟树林里显得矮。树高没动,参照系动了。
真实 BN 还会乘上可学习的缩放系数,再加上可学习的偏移。网络并不是被迫永远使用均值为零、方差为一的表示;它可以继续学习怎样调整这个尺度。这里省略它们,是为了把批次依赖单独拿出来。
来源:Batch Normalization 原论文,第 3 节
这个例子也说明,训练模式下,把一张图单独送入与混在一批图里送入,可能并非同一个计算条件。检查结果时,不能只说“图片完全一样”,还要问它经过了哪些依赖同批样本的操作。
训练看这一批,评估用留下来的尺子
日常使用模型时,通常不希望一张图的判断受旁边恰好拼进来的图片影响。否则同样的请求,赶上不同队伍就可能得到不同答案。
PyTorch 的 BN 在默认配置下,会在训练过程中积累均值和方差的运行估计。切到评估模式后,它使用这份保存的统计量,而不再临时拿当前批次重新定尺子。
继续用假设数值:假如保存的均值是 3、方差是 1,忽略很小的稳定项,输入 4 就约为 1。旁边再放一个 8,也不会仅因为这个同伴而改变这一步的参照值。这里的统计量是人为指定来解释计算的,不是声称某次训练必然得到它们。
保存的尺子并不等于“上一批的尺子”,也不必是把全部训练数据重新算一遍。以运行均值为例,PyTorch 默认的更新方式会保留旧估计的一部分,再混入本批均值。假设旧均值为 3,新一批均值为 7,更新系数为 0.1,新的估计就是 3.4。
所以模型虽然没有重新学习参数,切换模式仍会改变前向计算。训练使用的即时批次统计,与评估使用的积累统计,本来就未必完全相等。
有个容易漏掉的例外:如果构建 BN 时设置了 track_running_stats=False,它不维护这份运行统计,评估时也会用批次统计。看到 eval() 不能直接推断“从此与同批样本无关”,还得看层的配置。
来源:PyTorch BatchNorm2d:运行统计与评估行为
手算时还有一处细节要留心:PyTorch 训练前向使用的方差估计,与更新运行方差时采用的估计口径并不完全一样。因此,别把一批数手算出的方差直接当成保存下来的值,再据此判断框架算错了。均值、方差和标准差也要分清;公式的分母需要对方差加上稳定项之后再开平方。
对我来说,“两把尺子”比“训练版模型和正式版模型”更准确。参数可以完全相同,计算时选用的统计量仍然不同。正常的小差异不一定是故障;如果差异大到影响使用,就应该检查尺子如何积累、保存和加载。
关闭梯度,为什么还会改变模型状态
假设验证程序写了 no_grad(),我们可能就以为它只读不写。可它主要控制的是自动求导记录,不是让模型的所有行为进入评估状态。
如果 BN 仍处于训练模式,前向计算依然可能更新运行统计。即使没有调用反向传播,没有让优化器迈一步,保存的均值和方差仍然会变化。于是一次本来只想“看成绩”的验证,反过来改变了模型之后使用的尺子。
这和修改可学习权重不同,却同样属于模型状态变化。把“不算梯度”理解成“整个对象冻结”,就会漏掉它。
反过来,eval() 也不会自动关闭梯度记录。我们可以让模型按评估规则工作,同时保留梯度,用于分析某个输入变化怎样影响输出。是否需要求导,取决于接下来准备做什么,并不由“评估”两个字决定。
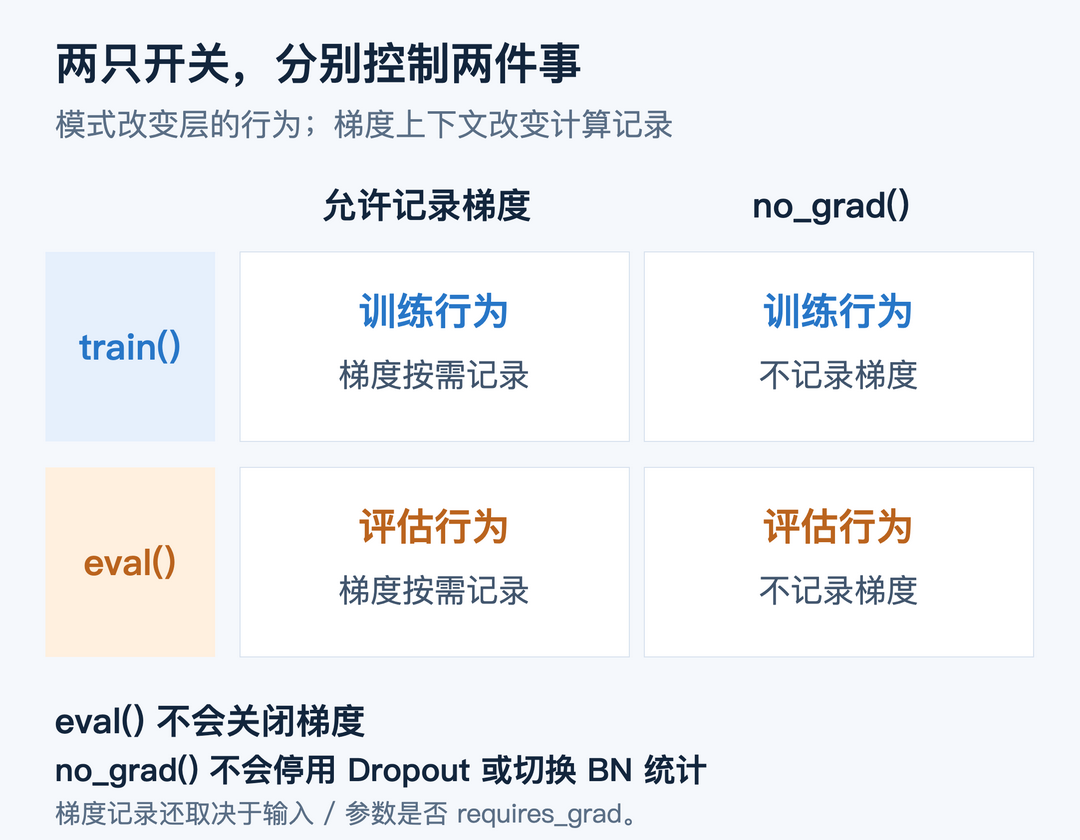
普通验证经常同时需要两件事:让相关层采用评估行为,并且省掉不需要的求导记录。于是常见写法是:
model.eval()
with torch.no_grad():
    prediction = model(batch)
这几行是用法示意,不是一份完整实验。它没有自动处理数据预处理、指标累计、设备选择,也不能保证所有运算从此完全确定。验证之后继续训练,还应按原先的设计恢复训练模式;忘记恢复,后面的训练就可能沿用评估行为。
我习惯把它想成一次考试的两个安排:学生按什么规则答题,旁边要不要记录推演过程。至于老师是否据此改教案,又是之后的事。train() 本身并没有替我们算损失、反向传播或者执行优化器更新。
Dropout 也会切换,但切换的是另一件事
BN 不是唯一会在训练和评估之间改变行为的层。Dropout 就是另一个常见例子。
PyTorch 的普通 Dropout 在训练时,按指定概率把部分元素置零,并缩放保留下来的值。评估时,这个模块按原样传递输入。它没有像 BN 那样改用一套历史均值,只是训练时的随机遮挡不再执行。
想象模型训练识别图形时,某些中间线索会被随机拿掉,迫使后续计算不要只依赖固定一小部分信号。正式判断时不再做同样的遮挡,输出自然可能改变。这个比喻只是解释随机置零的作用,不表示它真会按人理解的“轮廓”“颜色”整块删除知识。
因此,同一输入重复跑、结果忽上忽下,和输入换一批同伴后结果变化,是值得分开观察的两种线索。前者可以让我们检查随机操作,后者可以让我们检查批次依赖;但都不能只凭现象直接宣布根因。
一个模型还可能同时有 BN、Dropout 和自定义模块。调用 eval() 后,哪些部分会改变,最终由各模块的实现决定。普通线性层不会因为收到评估标志,就自动换成另一套权重。
为什么不能照搬到所有大模型
看到 BN 依赖批次,很容易顺势推断:“聊天模型一起处理多个请求,所以我的答案一定受别人的问题影响。”这个跳跃太大了,先要确认模型到底用了什么层。
LayerNorm 的归一化范围就不同。拿一张“每行是一个样本、每列是一个特征”的二维表理解:简化的 BN 沿同一特征向下看多个样本;如果 LayerNorm 配置为覆盖每行全部特征,它就在同一行内部计算统计量。
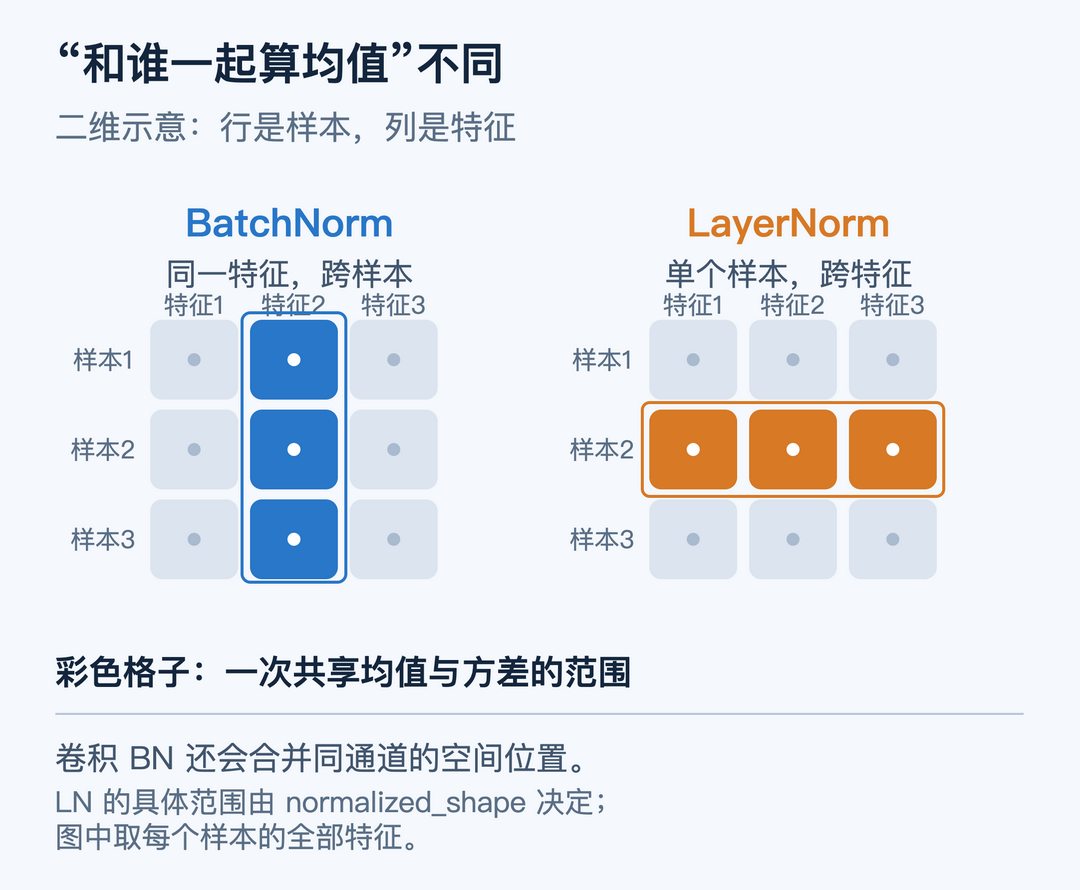
于是,LayerNorm 不需要依靠“刚好和你同批进来的其他样本”决定本行的中心与尺度。它在训练和评估时都根据当前输入计算统计量,不走 BN 那条“训练积累、评估读取”的路径。
实际张量不一定是二维。PyTorch 的 LayerNorm 按 normalized_shape 指定的末尾维度计算;BN 处理图像时,统计还涉及空间位置。行和列只是看懂方向的起点,不能拿这张小表替代真实维度检查。
来源:LayerNorm 原论文、PyTorch LayerNorm 文档
原始 Transformer 架构使用的就是 LayerNorm。不同模型的具体结构还会继续变化,因此,分析一个大模型的批处理行为时,应先查结构,不能把卷积网络里某个 BN 问题当成所有模型共有的机制。
来源:Attention Is All You Need,第 3.1 节
反过来,LayerNorm 不依赖其他样本,也不意味着整个系统的输出必然逐位相同。生成时的采样、其他随机操作和数值实现是另外的问题。找到一种依赖被消除,只能说明这一种机制,不该替整个系统作保证。
真要排查,先让比较条件站稳
如果遇到开头那种切到评估就明显变差的情况,我会先固定一小批输入:使用同一个模型版本、同样的预处理与数据顺序,再记录两种模式的输出。先排除图片缩放、归一化或类别顺序不同,避免把输入链路的问题推给 BN。
接着看模型究竟有哪些会响应模式切换的层,以及它们现在的状态。顶层写了 eval() 是一条线索,不如实际检查相关子模块来得直接;有些程序会单独切换某些层,不能只凭外层调用猜里面的行为。
如果问题指向 BN,就查看运行统计有没有正常积累,保存时有没有带上,加载时有没有遗漏。PyTorch 的 state_dict 不只包含可学习参数,也包含已注册的持久缓冲区,BN 的运行统计就是需要关注的部分。
迁移学习还会遇到一个相近的误会:把骨干网络参数的 requires_grad 设为 False,就以为整块网络完全不动了。参数是否参与求导,与 BN 是否继续积累统计是两个问题。若我们的目标是保留旧特征提取器的行为,就要明确这些缓冲区是否也应保持;若有意让统计适应新数据,则应该把它视作一次明确的状态调整,并单独验证。
这个区别也影响怎样保存排查证据。只比较两份可学习权重一模一样,不能证明完整模型状态相同;只看程序没有调用优化器,也不能证明验证前后没有变化。可以保留验证前后的相关统计量,看看它们是否发生变化,再回查是哪一段前向调用更新了它们。这样的对照,比在很多配置里同时改动一遍更容易解释。
再想一个假设场景:训练主要见到白底图形,使用时却全变成深色背景。即使运行统计完整保存,也不能保证过去积累的尺度适合今天的数据。此时继续往文件里找“漏存的字段”,可能始终找不到;需要把数据变化本身纳入比较。
但我不会为了让测试成绩变好,随手让模型用全部测试数据重新积累统计,再把结果与原来直接相比。这样已经改变了评估条件。若确实要做校准或适配,应单独准备合适数据,说明调整了什么,再用独立样本检查效果。
最后,别把修复写成“让 train 和 eval 永远相同”。有些差异来自设计本身,真正需要的是:评估采用预期规则,保存的状态完整,结果能够代表实际使用。模型有同一份权重,只证明其中一部分条件相同;要看懂它为什么这样答,还得把计算模式和那把尺子一起看进去。
评论