AI 学会了新东西,为什么旧本领反而退步了?
微调不是往空白抽屉里添知识。用一个语言助手的假设案例,解释共享权重如何让新旧任务互相牵动,以及回放、EWC 和 LoRA 各自能保护什么。
假设有个 demo 语言助手,原来很会把生硬的句子解释清楚。你给它一句产品说明,它会拆开术语,再举一个容易懂的例子。
现在想让它再学一件事:从活动介绍里提取日期、地点和人数,只返回固定格式的字段。于是收集一批这样的例子,继续训练。新任务越来越熟练,可回头让它解释一句话,它开始惜字如金,有时还把解释硬塞进字段里。
这里说的是一个用来理解原理的假设案例,并非某款产品的实测。更奇怪的情况也可能发生:输出格式还正常,旧题却真的答错了。模型明明多学了一课,怎么反而丢了分?
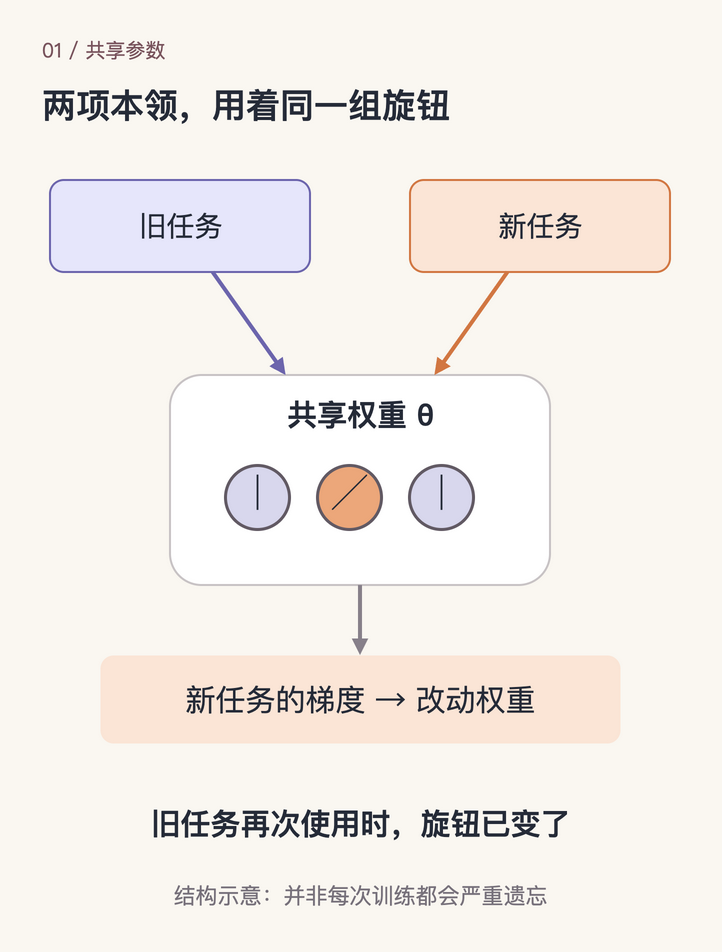
我以前容易把训练想成装书:原来书架上有一本,现在再放一本,两本应该都在。神经网络更像一套大家共用的调音台。新课要调旋钮,旧本领也依赖这些旋钮。只听新曲子调到满意,旧曲子可能已经走调。
研究里把这种先学新任务、随后旧任务能力明显退步的现象称为灾难性遗忘。“灾难性”描述的是可能很剧烈的能力损失,不是每次微调都会把模型清空,更不是说所有退步都只能归到这个原因。
新课没有一间独立教室
模型的知识并不是一条条存在独立格子里的记录。一个回答经过许多层计算,许多权重共同影响结果;同一批权重,也会参与处理不同的问题。
在这个假设的助手里,识别日期、理解句子、决定接下来生成什么,都可能借用已有的表示能力。新任务因此有机会学得很快:它不用从头学会中文。但共享也有代价,训练时改动的地方未必只对新任务生效。
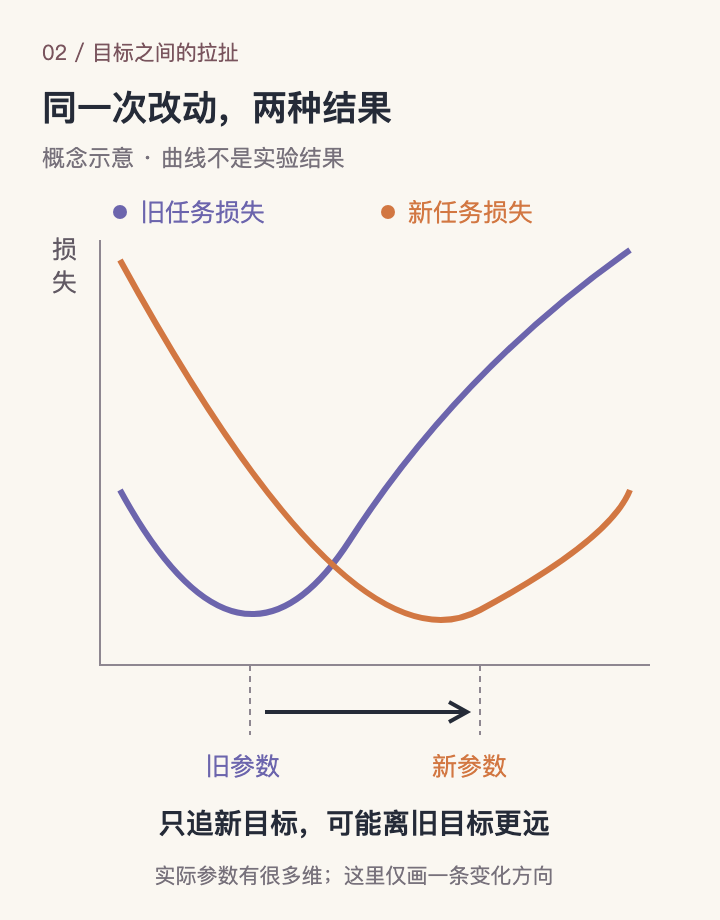
想象只剩一个可以调的参数。旧任务在它偏左时表现好,新任务希望它往右走。训练器现在只看到新样本,就会不断奖励向右的变化。它没有收到“刚才那个解释题变差了”的反馈,当然也没有理由主动退回来。
真实模型远不止一个参数,往往也存在兼顾两个任务的方向。这幅小图只解释冲突是怎么发生的,不能据此推断新旧能力必然此消彼长。如果两个任务恰好需要相近的能力,新训练也可能帮助旧任务。
Kirkpatrick 等人的 EWC 论文把问题说得很具体:为适应后来的任务,网络修改了对早先任务重要的权重。他们在手写数字和游戏任务上研究如何减轻这种干扰。这里讨论的是训练机制,不能把那些实验成绩直接换算成今天某个聊天模型能保留多少能力。
来源:EWC:Overcoming catastrophic forgetting in neural networks
聊天忘了前文,和训练忘了旧本领,是两件事
如果助手昨天知道一个活动地址,今天换了会话就答不出来,我会先检查它今天有没有拿到那段资料,而不是马上怀疑权重坏了。
在通常的推理调用里,输入一段对话,模型按既有权重生成回答;这次聊天本身不等于进行一次参数训练。历史消息没带进来、检索没找到文件、摘要漏了条件,都足以让它表现得像“忘了”。这些问题要检查上下文和外部记忆链路。
灾难性遗忘关心的是另一种变化:训练更新了参数,即使把相同旧问题重新完整地给它,表现仍然下降。两边都叫记忆,很容易把解决方法混用。加长上下文不一定能恢复训练中受损的能力;重新微调也未必能修好一个根本没有传入旧消息的程序。
还有一种相似现象是任务指令含糊。活动文本完全相同,“向读者解释”与“抽取固定字段”要求的输出本来就不一样。如果训练样本没有告诉模型当前要做哪件事,两个答案会相互打架。先补清任务标识,比急着换训练算法更合理。
因此,看到退步时,我会固定旧题、提示词、模型版本和调用设置重新比较。先排除输入改变,再判断能力改变。一次偶然答错,或者评价标准临时换了,都不足以证明发生了训练遗忘。
最直观的补救:学新课时,也做几道旧题
回到那个语言助手。与其只给它字段提取样本,不如在后续训练里混入一部分旧任务样本:解释术语、改写句子、按要求举例。这样优化过程不仅看见新课成绩,也能看见旧课正在付出的代价。
这就是回放思路的直观版本。它让旧需求继续参与训练,而不是只在训练结束后抱怨结果。GEM 研究则进一步利用保存的旧任务样本约束更新方向,目标是缓解遗忘,同时允许新训练对旧任务产生帮助。
来源:GEM:Gradient Episodic Memory for Continual Learning
不过,“掺一些旧数据”只是开头。假设留下的全是短句解释,长文归纳从来没被选进来,那么短句保住了,并不能证明长文能力也保住了。样本应该覆盖真正要保留的行为,尤其是那些不常出现、但一旦错了就很麻烦的情形。
还要把回放样本和验收样本分开。前者用来参与训练,后者用来检查没有见过的问题。如果训练时反复看同一百道旧题,最后再拿这同一百道题宣布“完全没忘”,更像是在检查它有没有背熟这张卷子。
比例也没有一个可以到处照抄的数字。旧数据太少,约束可能不够;旧数据占得过多,在固定训练预算下,新任务得到的练习又会减少。可以先做几组小规模对照,看新旧两边各自的变化,再决定下一轮怎么配。
这会带来保存数据、清理样本和训练计算的成本。旧数据不能保留的场景,也不能为了防遗忘就擅自留副本。方法是否适合,要把这些条件一起算进去。
另一条路:重要的旋钮,别轻易拧太远
EWC 提供了另一种思路:先估计哪些参数对旧任务重要,再在学新任务时,对这些参数偏离原值的幅度施加更强的惩罚。
可以把它想成不同松紧的弹簧。对旧任务特别关键的位置,弹簧更紧;相对不敏感的位置,可以多动一些。这不是把所有参数锁死,而是在新任务成绩与保持旧解之间增加约束。
这时真正要决定的问题就变成了:愿意为了保留旧能力,放弃多少新任务收益?约束非常强,可能很稳,却学不动新东西;放得很松,又可能失去保护作用。重要性估计本身也依赖任务和数据,不能理解成模型已经找到了每项知识的永久存储地址。
我喜欢这个思路,因为它提醒人把“保留”也写进目标。但它不等于一张通用保险单。看见一个方法能在特定实验中减轻遗忘,与证明它能保护一个大型助手的全部旧技能,中间还隔着很多验证。
冻住底座,LoRA 就一定不会忘吗
LoRA 会冻结预训练权重,另外训练低秩的增量参数。就文件而言,原来的底座可以原封不动地保留下来;但启用适配器后,实际计算使用的是底座加上增量,输出行为当然可能变化。
来源:LoRA:Low-Rank Adaptation of Large Language Models
所以需要区分两个承诺:“我能切回原来的模型”,和“加载这个新适配器时,所有旧能力也保持原样”。前者可以通过保存底座与版本来实现,后者仍然要测试。参数改得少,不自动等于影响的行为少。
假设给讲解任务和字段提取任务分别保留适配器,调用时按任务切换,就有机会减少共用一份增量造成的冲突。代价是系统要正确识别任务、维护版本,也要处理一条请求同时需要两种能力的情况。
如果不断在同一个适配器上接着训练新任务,它的参数仍然会变化,旧任务仍可能退步。把文件后缀换成适配器,并不会让训练目标之间的关系消失。
对经常变化的活动时间、地点这类事实,我也会先考虑检索资料,让模型在回答时读取最新记录。这样更新的是外部信息,不必为每次地址变更都重训权重。检索有自己的准确性与权限问题,但至少不需要把所有更新都塞进同一条训练路径。
有些冲突,需要先把题目写清楚
再想一个更简单的例子:训练一个日期格式转换器。旧样本把日期写成“年、月、日”,新样本一律要求“月、日、年”,却不给地区或格式提示。同样的输入对应两种目标,模型没有足够信息判断这次该听哪套规则。
这时把旧数据回放得再勤,也不能让它对完全相同的条件同时输出两个唯一答案。应该先在输入里写明目标格式,或者明确决定旧规范已经作废。如果这次产品本来就是全面切换格式,退回旧输出反而是一种错误。
还有一种情况是任务确实要同时存在,但服务拆分比继续压进同一个模型更清楚。讲解助手与严格的字段提取器可以共用底座、分别调用,调用方知道自己要什么。这样做会增加维护工作,却能让每种行为的验收边界更明确。
因此,面对新旧能力冲突,我不会只盯着学习率和训练轮数。先分清需要兼容、需要替换,还是需要按条件切换,才能知道要保护什么。否则算法很努力地保存了一个已经过时的答案,最后也不是我们要的结果。
验收时,给旧本领留一张独立成绩单
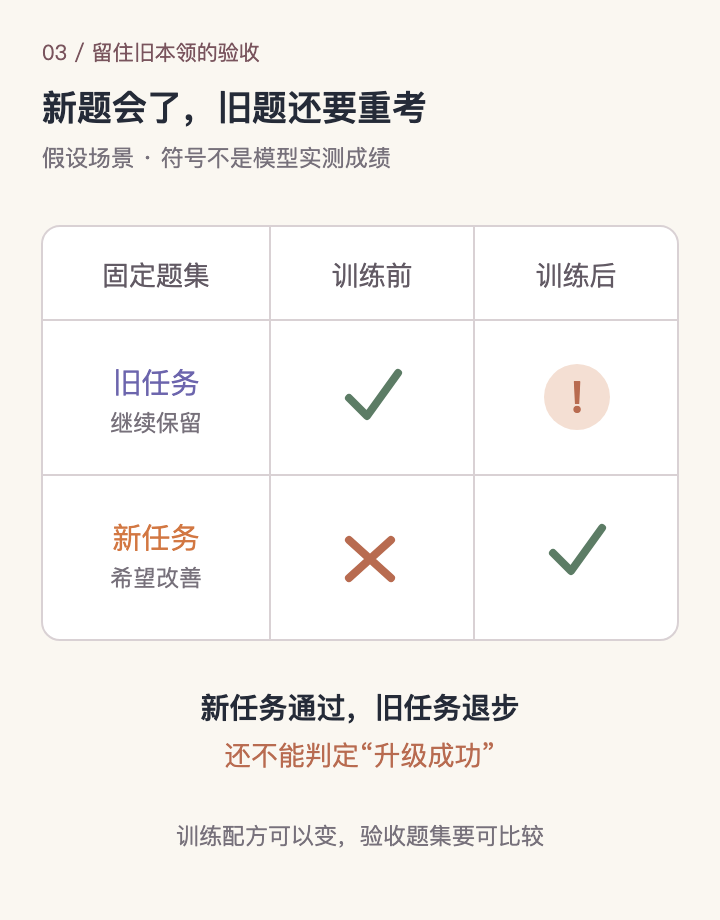
假设这个助手的新任务已经能稳定抽取字段。验收时我会把测试分成两组:一组检查字段是否完整、格式是否合法;另一组检查旧的解释、改写、归纳能力。两组都使用预先保留的未训练样本,同一套判定标准从训练前用到训练后。
只看总分很容易漏问题。假设验收集后来增加了许多字段提取题,新能力的增长可能掩盖解释能力的下降。就算总分上升,也应该能回答“旧任务到底变了多少”。否则这次训练究竟是增益还是交换,根本说不清。
除了分数,还要看错法。模型是丢了关键事实,还是只改变了表达风格?是整类题退步,还是某个词触发了固定输出模板?如果只是新训练让所有回答都过短,就可以针对任务边界和样本格式继续排查,不必先认定整个语言能力都被损坏了。
再换一个例子:识别手写数字的模型,先训练一组数字,再只训练另一组。如果旧数字识别率下降,可以用固定旧测试集观察这种变化。可是生产环境的手写体也可能同时变了,字迹更潦草、拍摄更模糊。此时旧版本也可能一起掉分。把新旧模型放在同一批当前样本上比,才能分开“模型更新带来的退步”和“题目变难”。
实际做小规模微调时,我会先留下可恢复的底座和训练前结果,再逐步增加训练量,定期重测新旧任务。发现新收益已经很小、旧损失却在扩大,就有理由停下来检查数据,而不是因为还有预算就继续跑。
并非所有旧行为都值得保留。错误事实、过时格式,或者本来就不希望出现的回答,应当允许被纠正。真正需要保护的是明确列出的能力和约束。把“永远不变”当目标,同样会阻碍模型学习。
我现在理解“让模型继续学”时,会多问一句:这次更新以后,哪些事情必须仍然做得好?这句话如果没有对应的旧题和验收标准,所谓学会了新东西,就还缺半张成绩单。
评论