AI 能找出九成问题,为什么警报里大半是误报?
用一万份假设文档算清基准率、召回率和误报率:找出九成问题,不代表九成警报可信。真正要验收的,还有复核名单里能找到多少问题,以及没报警的地方漏了什么。
一个 AI 审核工具,能找出九成有问题的内容。把它接上去,打开待复核列表,却发现连续看了好几条都没事。
直觉上,这两件事不该同时发生。“九成”明明挺高,怎么用起来像在捞针?看这类数字时,很容易把“问题能被发现的比例”,顺手理解成“警报值得相信的比例”。但这两个比例,数的根本不是同一群东西。
我想用一份很普通的文档审核任务,把这个差别算清楚。它不需要模型突然变笨,也不需要有人故意挑选漂亮指标。只要真正的问题比较少,少量误报就足以淹没大部分正确警报。
先把一万份文档摊开
假设有一个 demo 资料站,每天新增一万份简短的活动说明。审核目标很具体:找出正文中把报名截止时间写在活动开始之后的文档。这里先假定规则和人工标注都清楚,只讨论审核结果。
下面所有数量、比例和工作量都是为解释原理构造的假设,不是某款模型的实测成绩,也不是一次真实运营记录。
在这一万份文档里,实际有一百份存在目标问题,其余九千九百份没有。AI 能找出其中九十份,漏掉十份;对于没有问题的文档,它又会把百分之五错报成有问题。
百分之五听起来不算多,但它乘的基数是九千九百,结果是四百九十五份。于是待复核列表里共有五百八十五条警报:九十条确实有问题,四百九十五条没问题。
从列表中随便打开一条,命中真实问题的比例约为百分之十五点四。也就是说,平均看六七条警报,才找到一条真的。工具仍然找出了九成问题,复核的人也确实大半时间都在看误报。这两种体验没有矛盾。
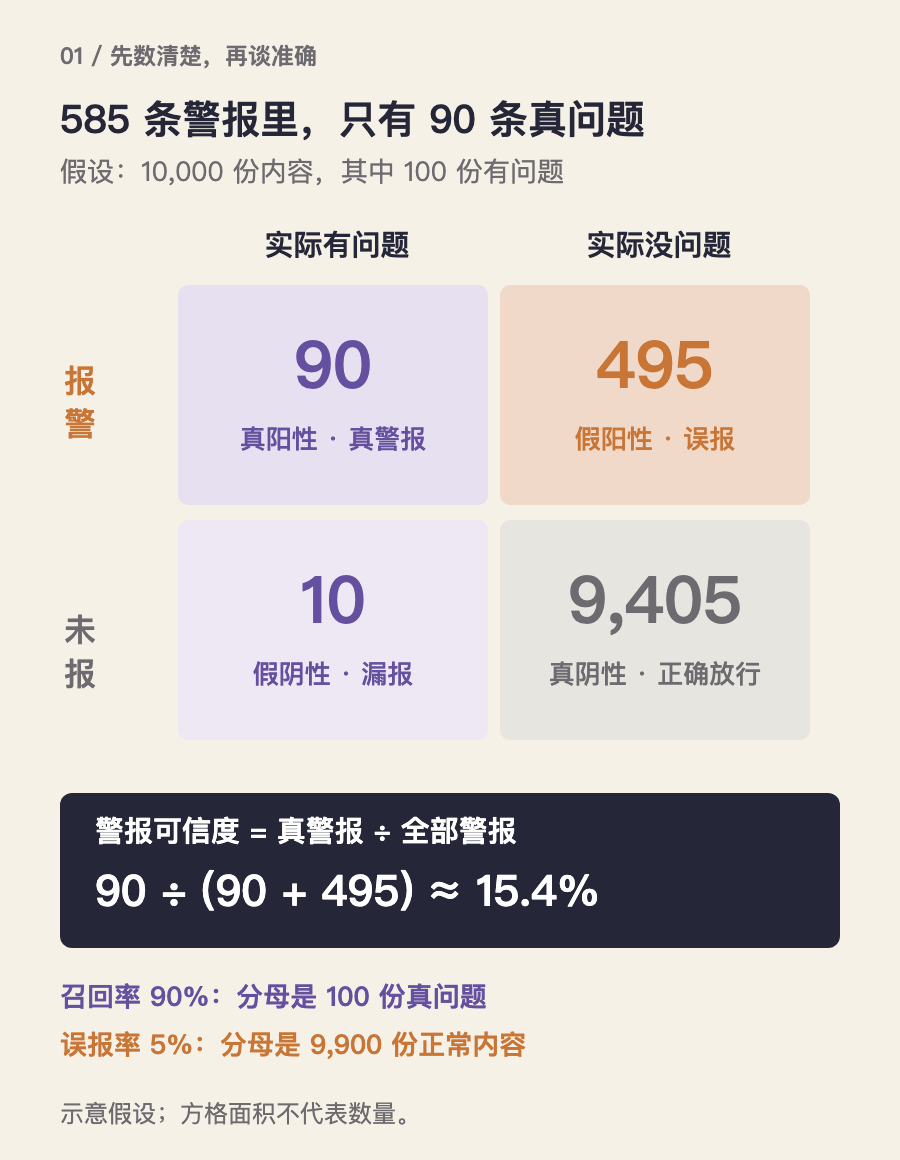
我觉得把数字写成四格,比先背术语有效。每份文档都有两件事:实际是否有问题,AI 是否报警。交叉起来恰好四种结果。少写其中任何一格,都可能让我们误解系统正在做什么。
说“很准”之前,先说分母是谁
“有问题的一百份里,找出九十份”,叫召回率,回答的是问题漏掉多少。“报警的五百八十五份里,九十份真有问题”,叫精确率,回答的是复核名单有多可信。
误报率则是另一种分母:没问题的九千九百份里,四百九十五份被错报,占百分之五。误报率低,不等于警报里误报少。前者从正常文档出发,后者从已经报警的名单出发。Google 的分类指标说明给出了这些口径,读数字时可以据此核对。
还有一个更好看的数:这一万份里,判断正确的包括九十份正确报警,以及九千四百零五份正确放过。加起来,总体准确率是百分之九十四点九五。
这个数没有撒谎,只是没回答复核者最关心的问题。更极端一点,假设有个工具一律说“没问题”,它在这批文档上的总体准确率反而是百分之九十九,却一个问题都找不出来。
因此,看到“准确率百分之九十五”,我会先问它是所有文档的正确率,还是报警名单里的精确率。有时大家都用“准”这个字,实际在谈完全不同的东西。把分子和分母直接写出来,常常比争论哪个术语翻译得更好更管用。
这里也不要走向另一个极端:精确率高就一切都好。一个只敢报一条、而且恰好报对的工具,精确率可以非常漂亮,剩下九十九个问题却全漏了。评价必须同时保留它找到了多少、错报了多少,以及有多少根本没被发现。
同一个工具,换一批文档就像换了性格
现在把资料站换成一个专门收集待修订文档的目录。仍然检查一万份,但其中一千份真的有问题。我们暂时保持工具能力不变:召回率仍是百分之九十,误报率仍是百分之五。
这次它会找出九百份真问题,同时把九千份正常文档里的四百五十份错报。警报共有一千三百五十条,精确率变成约百分之六十六点七。
模型没有升级,提示词没有修改,警报却从“六七条里找一条”变成“三条里有两条”。变化来自输入中真实问题的比例。这个在报警之前就存在的比例,叫基准率。
把“待修订目录”上的表现直接搬到全部新文档,容易在这里翻车。前者本来就聚集了更多问题。只报精确率,而不交代样本是怎么来的,别人就很难判断这项成绩能否对应自己的日常使用。
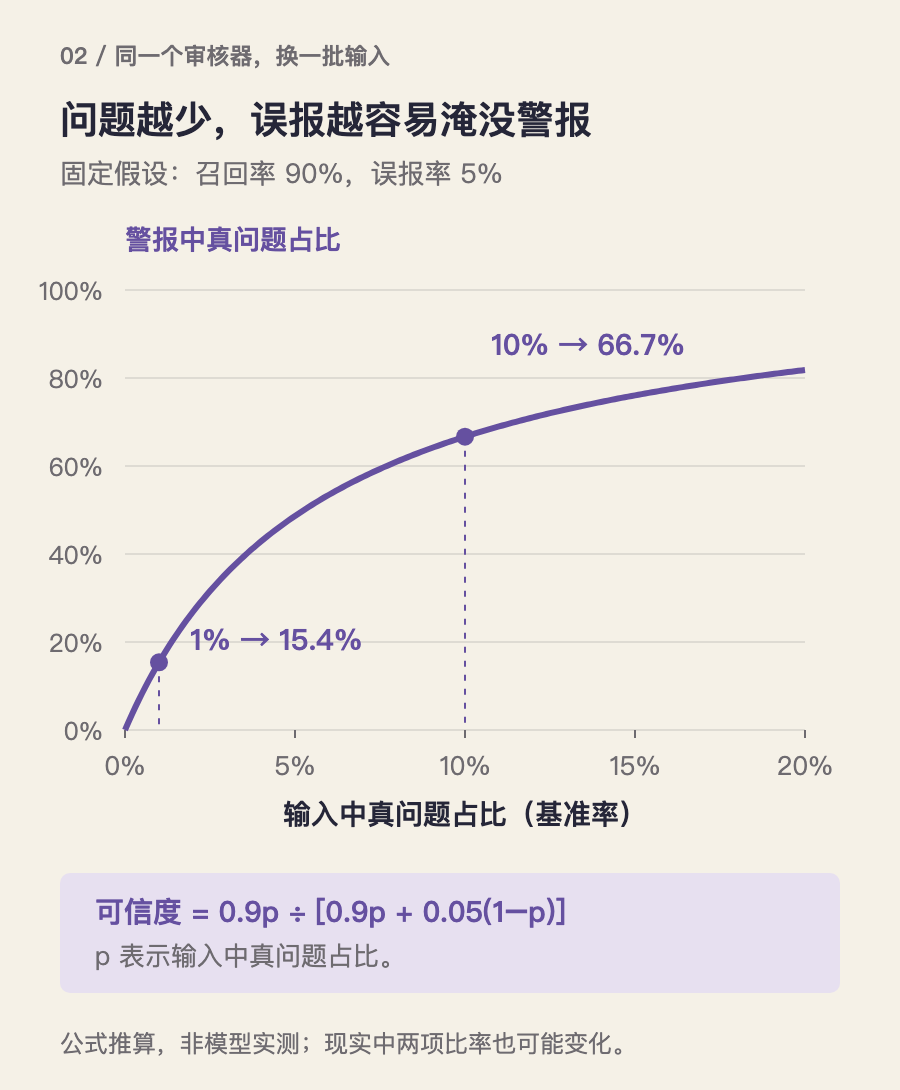
如果愿意写一行算式,可以把真实问题占比记作 p。每份输入平均贡献的正确警报是 0.9p,错误警报是 0.05(1−p)。两者相加是全部警报,所以精确率等于 0.9p / [0.9p + 0.05(1−p)]。
这个式子是前面人数计算的缩写。真实问题越少,可供正确命中的数量越少;正常文档却越来越多,哪怕只有一小部分被错报,也能挤满列表。
当然,实际换一批材料时,召回率和误报率也可能一起变。新的写法、更长的文档、不同的语言,都会改变任务难度。这里故意固定两项能力,是为了单独看清基准率的作用,不能拿这条曲线直接预测某个产品上线后的成绩。
还要注意,问题少不一定是坏消息。如果资料质量提高,真正需要修改的文档减少,同一个审核工具的警报精确率就可能下降。这时只盯着精确率,会把内容变好误读成模型变差。反过来,突然出现大量问题,也可能让警报看起来更可信。模型指标和真实问题的发生率,最好一起观察。
人一天只能看一百二十条,怎么选
回到最初那个每天五百八十五条警报的假设。假如人手每天只能认真复核一百二十条,“多报一点总没坏处”就不成立了。多出来的警报不会自动变成更多已处理的问题,它们会占用等待区,也可能把重要条目压在后面。
如果从五百八十五条里随机抽一百二十条,按刚才的比例,平均只能找到大约十八个真问题。这里说的是随机抽样下的期望,不是任何一天必然得到的结果。如果按分数排序挑前一百二十条,效果取决于排序能否把真正的问题放在前面,不能直接沿用这个数字。
因此,我更想看一张与人手对应的表:每天查看前几十条、前一百条、前两百条,分别能找到多少真实问题,又漏下多少。它把“模型会发现”推进到了“人实际能处理”。这也让工具比较有了具体条件:在相同复核预算下,谁能找到更多需要修改的文档。
复核预算也不一定只按条数算。有的警报把相关句子和日期都列清楚,几十秒就能判断;有的只说“存在矛盾”,编辑还得翻附件、找版本。若两种工具找到的真问题数接近,我会再比较每个确认问题平均花多少时间。把证据整理得清楚,同样可以减少复核成本,但前提是那些引文真的来自待查文档。
提高报警门槛是一种办法,但不能只看列表变短。对同一批固定分数,门槛提高后,被选中的条目不会增加,召回率也不会提高;精确率是否改善,则需要看被留下的究竟是什么。不能把“更自信”直接当成“更正确”。
调整门槛和重新训练模型也要分开记录。scikit-learn 的阈值说明指出,概率输出不变时,改变阈值就能改变最终分类;挑阈值应使用适当的独立验证数据,避免把同一批题反复调成好看的结果。
如果工具让大模型用文字打出“风险八十分”,还要多留一步:这个分数是否真能排序?同一批带标签的文档里,八十分以上是否比六十分附近更常出问题?没有这样的验证,分数只是模型按提示生成的一个输出,不能把八十分读成八成概率。既然打算拿它分配人的注意力,就应当先验证它是否有这种用途。
具体到资料站,还可以先分清处置动作。一个仅供编辑参考的提示,可以容忍一定误报;一旦报警就自动把文档隐藏,误报会直接影响正常内容。目标相同,动作不同,合适的门槛就可能不同。先确定报警之后要做什么,再讨论要把警报压到多“准”。
再找一个 AI 复核,不能直接把错误率相乘
一个很诱人的想法是:第一遍误报百分之五,第二个模型再检查一次,也误报百分之五,那两遍都错的比例是不是只剩千分之二点五?
这个乘法需要额外条件。第二个模型实际收到的,是第一遍筛出来的材料,尤其包括第一遍最容易误解的正常文档。它在全部正常文档上的误报率,并不自动等于它在这批材料上的误报率。
假如两个模型都把“报名截止时间以附件为准”理解错,它们就可能一起报警。第二次判断重复了第一种误解,而不是提供了一次独立抽签。更换模型名称、换一句问法,都不能证明错误已经独立。
两阶段审核当然可以有用,只是应当直接测整条流程。保留原文、第一遍警报理由和第二遍结论,在有人工标签的数据上统计最终四格。特别要看被第二遍撤销的警报里,有没有真的问题被一起放走。
我也会给复核者一个更具体的任务:指出正文的开始时间和截止时间,说明两者的来源,再判断它们是否满足规则。能用日期解析和明确规则直接核对的部分,优先让确定的检查做掉。AI 适合处理表达差异,但一句“复核无误”本身仍然只是待验证的判断。
别只检查已经报警的地方
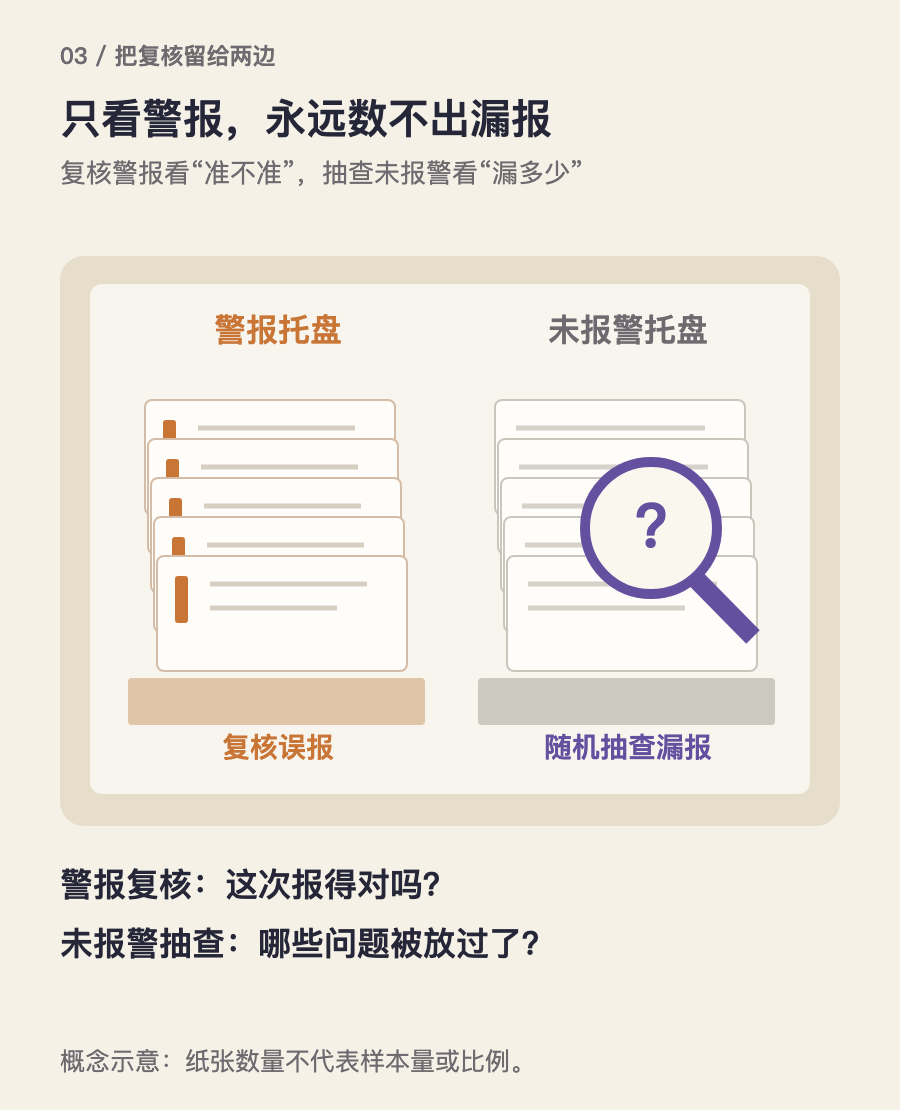
上线后最容易拿到的反馈,是编辑处理警报时标注“有问题”或“误报”。靠这些数据可以估计已复核名单的精确率,却看不到没报警的文档里藏着多少问题。
如果只复核分数最高的部分,还不能把那部分的精确率代表整份报警名单。高分段、中间段和临界段可能很不一样。记录评估结果时,至少说清样本来自哪一段、怎样抽取,以及有多少份。
我会另外从未报警的文档中随机抽一批人工检查,并保留抽样范围。这样才能开始了解漏报,而不是把“没人报告问题”误当成“没有问题”。若为了多找到错误而重点抽查某类文档,也要单独标明;这类定向检查很有价值,但它的发现比例不能直接代表全部输入。
人工标签本身也需要一致。比如正文引用了一份已经作废的旧活动通知,到底算当前文档的日期错误,还是正常的历史引用?先把这种边界说清楚,再把意见分歧的样本单独复核。否则今天按一种规则标注,明天按另一种规则比较,数字变化就未必来自模型。
最后,别把少量样本里的零误报写成“真实误报率为零”。几十份里没有遇见,只说明这次没有看见。实际要接受多大不确定性,取决于用途和错误代价;至少保留样本数量、时间范围、模型及规则版本,让后来的人知道这个比例凭什么成立。
我再看到“AI 能找出九成问题”时,仍然会觉得它可能很有用。但接下来最想问的,会是另外两句:在我每天收到的材料里,问题本来有多少?它递给我的这份名单,需要我花多少工夫,才能找到那些真正值得处理的东西?
评论