练习题越做越熟,模型为什么反而考差了?
训练损失一路下降,不代表模型越来越会处理新数据。从一个手写数字识别的假设案例出发,拆开过拟合、样本泄漏与验证集被反复使用的问题,看看一份可信的成绩究竟怎么留下来。
训练模型时,很容易盯住一个令人安心的数字:损失又降了。昨天认不出的图片,今天认出来了;原来犹豫的答案,现在给得很坚定。既然还在进步,多练一会儿总没坏处吧?
偏偏有一种情况,练习题越来越熟,新题却越做越差。
我觉得这比“模型没有学会”更值得警惕。模型确实学到了东西,只是学到的部分越来越贴近眼前这套题,而我们想要的是它面对下一套题也能用上的本事。这两件事没有自动绑定。
先留下一些模型没有练过的题
假设我们做一个识别手写数字的小实验。收集来的图片里,有人的“七”带横杠,有人的“一”有小帽子,还有些图片边缘带着扫描时留下的灰线。这里的实验是方便说明的假设,不是某个模型的实测报告。
如果把所有图片都用来训练,再拿这些图片给模型打分,我们能知道它对这份材料拟合得怎么样,却很难知道换一批图片会怎样。一个极端做法是把每张图片和答案记成一张查询表。只要输入完全相同,查表就能答对;来一张新图片,它甚至不知道从哪里开始。
神经网络通常不会以这种字典的形式保存数据,但这个极端例子足以说明:在训练样本上正确,并不能单独证明获得了可迁移的规律。我们需要让一部分图片暂时待在外面,观察模型处理没有参与参数学习的材料时,表现是否也在改善。
这就是验证集的用处。它和训练集可以来自同一个任务,却承担不同的工作:训练集让模型调整权重,验证集帮助我们判断这次调整是否值得保留。所谓泛化,就是从已经见过的样本,走向同类的新样本时还能站得住。
“同类”也有分量。用整齐扫描件训练、验证都很好,突然换成夜里手持拍摄的模糊照片,仍然可能失败。那已经改变了输入条件。验证集是一场有范围的考试,不是关于未来所有情况的担保。
相关定义可以看《动手学深度学习》的泛化章节。我习惯先写下要面对什么新数据,再决定留下什么样的题,免得考试本身考错了方向。
两条曲线,开始一起走,后来分了路
继续训练这个数字识别模型。起初它连粗略形状都分不清,训练和验证损失都偏高。学到竖线、圆圈等有用线索后,两边一起改善,这时多练一些确实可能有用。
再往后,训练损失仍在降,验证损失却不再改善,甚至持续升高。这是常见的过拟合信号:模型越来越适应有限训练样本中的细节,其中一部分细节没有帮助它处理新样本。
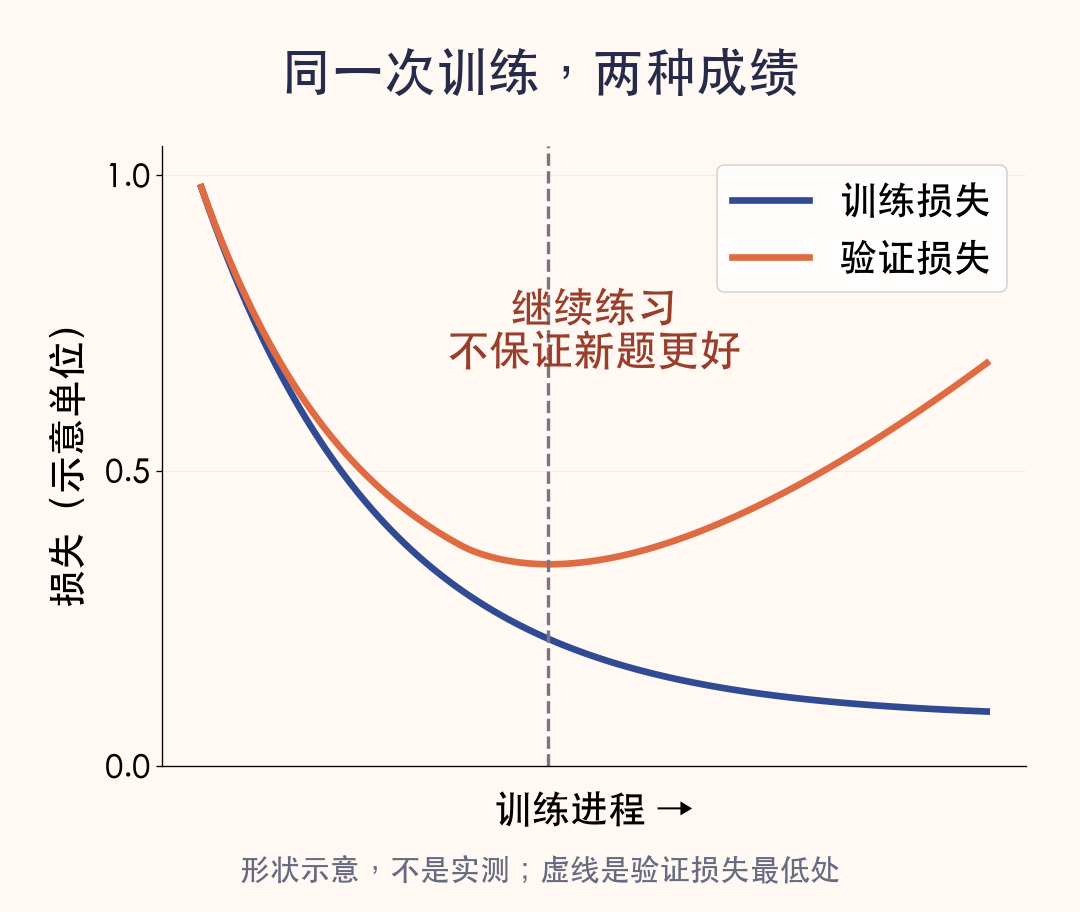
比如,某种扫描灰线恰好更多地出现在数字“三”的训练图片里。它在当前数据里很有预测价值,优化训练损失也不会因为“这条线其实不该有用”就拒绝它。换一批扫描件,灰线和数字不再这样对应,这条捷径就成了负担。
所以,过拟合不等于模型有意识地偷懒,也不要求它完整背下每个答案。只要过度依赖这批有限样本特有的细节,就可能出现问题。把“记忆”和“理解”当成非黑即白的两种模式,反而容易看漏中间那些局部有效、换环境失效的规则。
不过,看到一次验证损失抬头,我不会立刻宣布过拟合。先确认每次评估用的是同一份数据、同一个指标和相同的评估方式,再看变化能不能持续。小验证集里几个样本的变化就可能明显影响均值;如果每次抽到的题还不同,比较起来更容易误判。
训练损失和验证损失的绝对高低也不能机械解读。训练时可能开启数据增强或其他扰动,评估时则关闭;两个数字不是在完全相同的条件下产生的。比起规定“验证必须比训练高”,我更关心固定评估条件下,训练继续改善时,新数据上的表现是否稳定变坏。
训练集和验证集,文件不同还不够
比曲线分叉更隐蔽的问题,是两条曲线一起漂亮地下降,验证成绩却仍然不可信。
假设每一张原始手写图片,我们都生成一个稍微旋转的版本和一个加亮的版本。接着把全部文件打乱,再随机分进训练集和验证集。文件名没有重复,像素也不完全一样,看起来分得很干净。
但同一张原图的三个版本,很可能被分到两边。模型训练时已经见过其中一个,验证时面对的是它的近亲。我们本想考“能否识别新的手写图片”,实际考的却包含“能否认出已经见过的笔迹稍微转了一个角度”。成绩自然可能偏乐观。
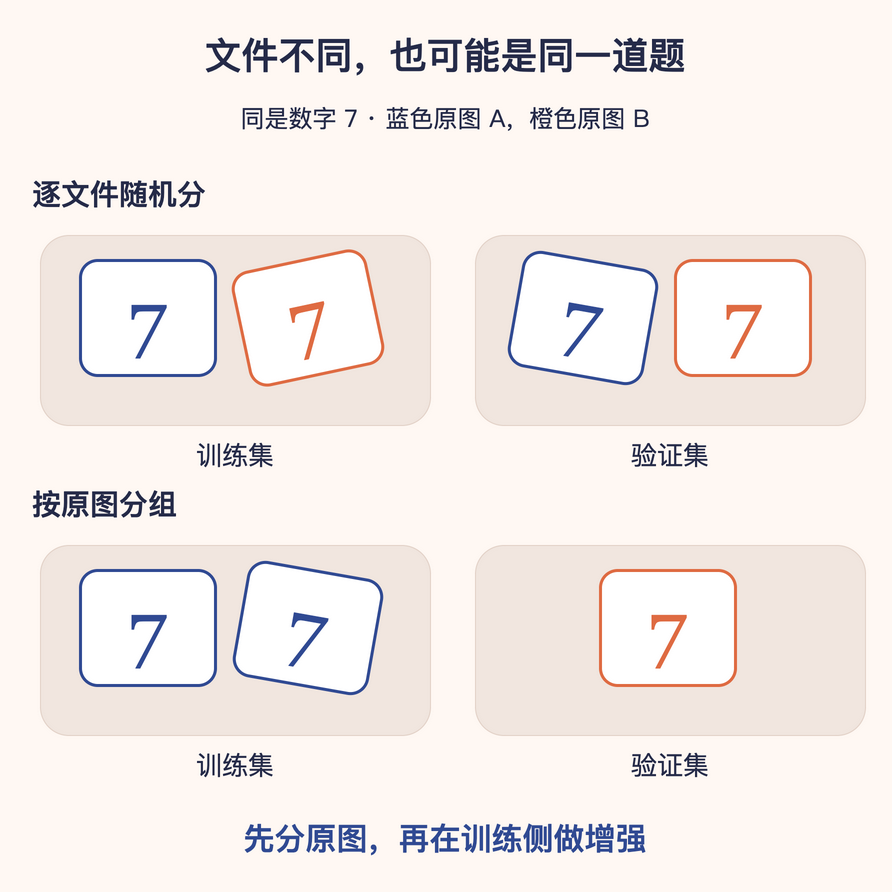
这个例子的修法也很具体:先按原图划分,再只对训练侧做需要的增强。切分的单位是原始样本,而不是增强后的文件。增加文件数量,并不会凭空增加同样多的独立证据。
再往前想一步:如果目标是识别陌生人的字,同一个书写者的图片也可能存在关联。按图片随机划分,能测出面对已有书写者的新图片时怎么样,却未必充分测出面对新书写者时怎么样。这时应考虑按书写者分组,让同一个人的样本留在同一侧。
这不是说随机划分总是错。该怎么划分,取决于上线后遇到的“新”究竟新在哪里:新图片、新用户、新设备,还是未来的一段时间。先定义这个边界,比争论固定的八二比例更有用。scikit-learn 的分组交叉验证说明解释了如何避免同一组样本同时出现在训练与评估两边。
时间也会制造类似的错觉。假设我们预测一家虚构小店下周的客流,把两年的逐日记录随机打散,训练侧可能已经见到了验证日期之后的经营状态。这种成绩与真正只能利用过去预测未来的场景不同。按时间留下后面一段数据,通常更贴近这个目标;如果特征还用到了滚动窗口,就要继续检查窗口里有没有混入未来信息。
但按时间切分之后,成绩变差也不全等于模型背题。季节、营业方式或客户群变了,数据分布本身就可能发生变化。这时要同时比较近期与过去的样本条件,不能只加大正则化,期待它替我们解决所有环境变化。划分方法是为了暴露真实问题,不是为了挑一种能报出最高分的分法。
还有一种穿过边界的方式不在图片本身。比如给表格数据做标准化,先拿全量数据计算均值,再切训练和验证,验证数据的统计信息就已经进入了处理流程。虽然没有直接拿验证答案反向传播,流程仍然提前看到了本该留在外面的材料。
更稳妥的顺序是先切分,用训练集拟合预处理步骤,再把同一套已确定的变换应用到验证集。填补缺失值、选择特征也要留意同一条边界。官方的数据泄漏示例展示了,预处理阶段看过测试数据,也能造出偏高的成绩。
验证集用得越勤,越需要最后一份封存的试卷
如果验证集不参加反向传播,是不是就永远保持“没见过”?
对权重更新来说,它可能没直接参与。但对整个开发过程来说,我们一直在看它。这个网络验证成绩差,就改层数;那个学习率更好,就留下;训练到哪一轮停止,也根据它决定。
这些决定合理,而且正是验证集的用途。但选择本身已经把验证结果带进了最终方案。试的方案越多,就越容易选中一个恰好适合这份验证集的方案。它不一定在新样本上同样占优。
想象有两种配方,本来效果接近。验证集又很小,其中恰好难写的“九”多了一些。我们反复针对这些错题调整,验证分数一点点涨起来,最终得到的可能是一个特别擅长这几种“九”的模型。成绩不是假的,但它回答的范围比我们想象的小。
所以通常还会保留测试集。在训练和调参阶段,尽量不拿它决定模型;方案确定后,再用它做一次最终评估。训练集、验证集、测试集不是三个神秘文件夹,而是给三个不同决策时刻分配的信息权限。
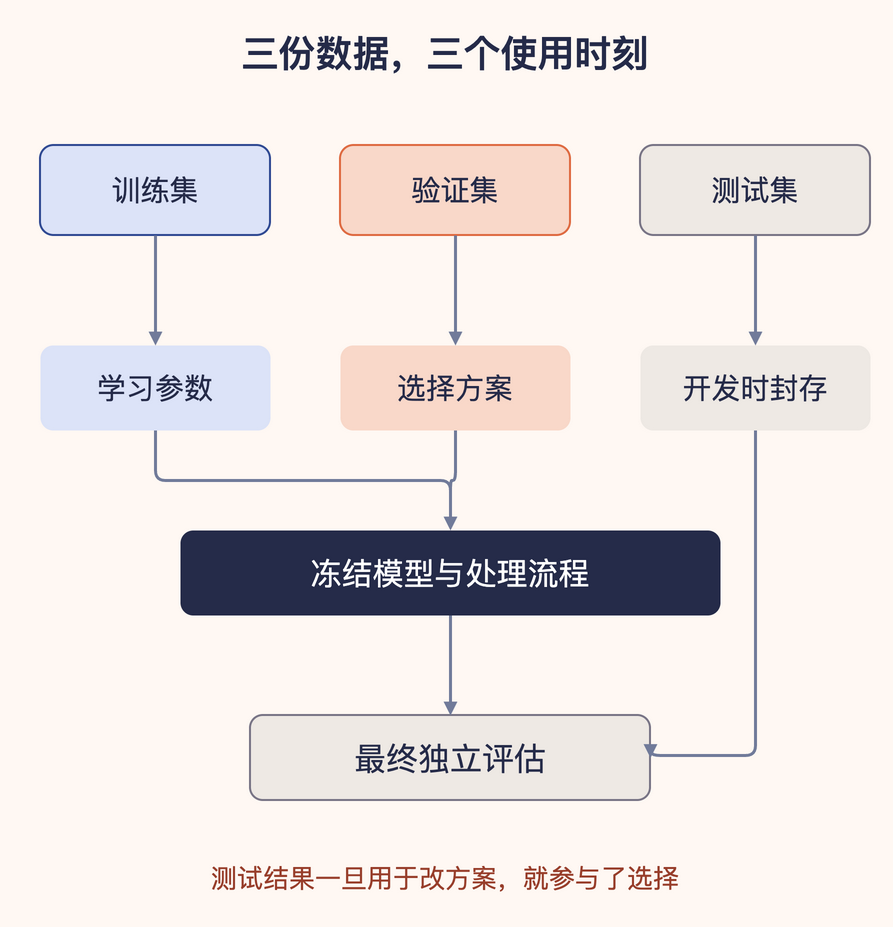
如果测完发现结果不好,当然可以继续开发。只是要承认:一旦根据这份测试结果调整,下一次再报同一份测试成绩,就不能装作这是完全未受影响的新考试。需要新的独立留出数据,或者清楚说明当前评估限制。
数据少时,交叉验证可以帮助更充分地利用开发数据,观察不同划分下表现是否稳定;但它不自动解决泄漏,也不取消最终评估的独立性。分组边界和预处理仍然要在各个折里成立。关于模型选择与测试集分工,可以看交叉验证文档。
真遇到过拟合,该改哪一件事
回到最开始那两条分路的曲线。我会先确认评估可信,再选措施。否则,验证集里混着训练图片的近亲,怎样调模型都可能只是在优化一块有问题的仪表盘。
如果划分与评估没有明显问题,训练继续下降、验证持续退步,可以按预先定好的规则提前停止,并保留验证表现较好的参数,而不是默认最后一轮最好。这里“提前”不是随便看一眼就拍脑袋停下,要给波动留余地,也要把停止规则固定下来,避免今天凭心情留这一轮,明天又换一个标准。
还可以增加真正有代表性的训练材料。多收不同书写者、不同拍摄条件下的图片,和把旧图片复制十遍,解决的不是同一个问题。前者可能补上模型没见过的变化,后者主要增加重复次数。数据增强能模拟某些合理变化,却不能替代一切真实差异;把“六”旋转成像“九”的样子,还坚持原标签,也可能制造错误监督。
减少模型复杂度、加入合适的正则化,也是常见方向,但我不会把“参数少”当成可靠性的证明。模型太弱,可能连训练里的有效规律都学不好;大模型也不必然泛化差。最终仍要回到同一套可信评估,看改善发生在什么样本上、代价是什么。《动手学深度学习》的深度网络泛化讨论也提醒,现代网络的规模与泛化之间并不是简单的一条单调关系。
实际比较时,一次只改少数因素,记下数据版本、划分单位、评估方式和选中的参数版本。除了看总分,还可以看错题集中在哪里:新书写者、模糊图片、少见数字,还是某种拍摄背景。总分涨了一点,若只是本来就容易的题更稳定,可能还没有碰到真正的使用障碍。
我现在更愿意把训练曲线理解成“练习进度”,把独立评估理解成“还能带走多少”。模型确实需要练熟眼前的数据,但值得保留的进步,应该能跨过那条没有提前看答案的边界。
评论