模型答错了,凭什么知道该改哪一个权重?
用一个能手算的微型网络,把前向计算、链式法则、分支求和和参数更新拆开:反向传播算的是局部敏感程度,不是把答案倒着塞回去。
一个模型把答案算错了,我们可以告诉它“正确答案是这个”。但网络里有那么多权重,到底该动哪一个?全都减一点显然不行:有的应该增加,有的应该减少,还有的在这道题上几乎没起作用。
我刚接触反向传播时,容易把它想成老师批卷:最后一层接到错误,再往前一层层追责。这个比喻能解释方向,却留下了最关键的空白——每一层到底收到了什么?它怎么知道该改多少?
把“追责”换成一个更具体的问题,事情就清楚了:某个数轻轻动一下,最终损失会跟着动多少? 反向传播就是沿着已经发生的计算,把这些敏感程度算出来。它不理解答案的语义,也不会从正确答案直接反推出一套正确权重。
先造一台能看清每个零件的小机器
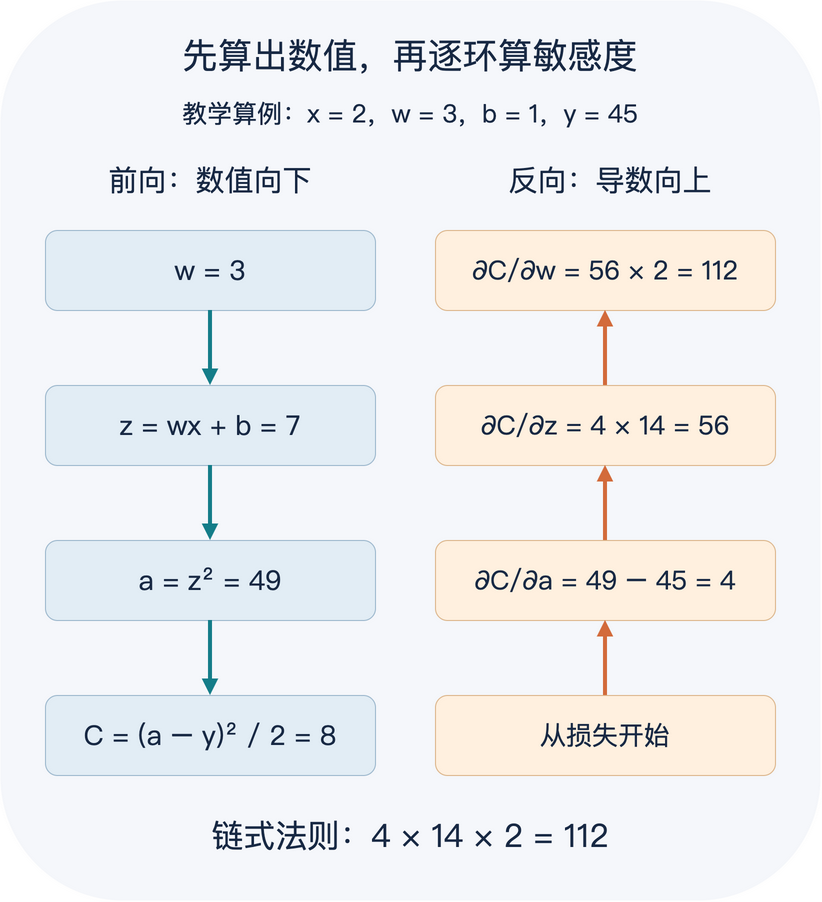
下面是一组为了讲清原理构造的数字,不是模型训练实测。输入取 x=2,权重取 w=3,偏置取 b=1。先乘再加,得到中间值:
z = w × x + b = 3 × 2 + 1 = 7接着把它平方,当作这台教学小机器的非线性变换,得到输出 a=49。平方只是方便手算,不是在推荐真实网络都用平方当激活函数。假设这道题希望得到 y=45,把损失定义为误差平方的一半:
a = z² = 49
C = (a − y)² / 2 = (49 − 45)² / 2 = 8
这里有四种不同的东西:输入是题目给的,权重与偏置是可以训练的,输出是模型算的,损失是拿输出和目标比较后得到的分数。做完这几步,我们只知道损失等于八,还没有改过任何参数。
为什么要给中间值起名字?直接写一个大公式也能算,可一旦网络长起来,展开式会很难读。把计算拆开后,每个零件只需要管自己那一小段。乘法知道乘法怎么求导,平方知道平方怎么求导,整个网络就有了可以拼起来的积木。
一个权重动一下,要经过三次放大
现在只动权重,其他量暂时固定。w 增加一点,首先影响的是 z。因为输入等于二,权重每增加很小一份,中间值就增加两份。这一段的敏感程度是二。
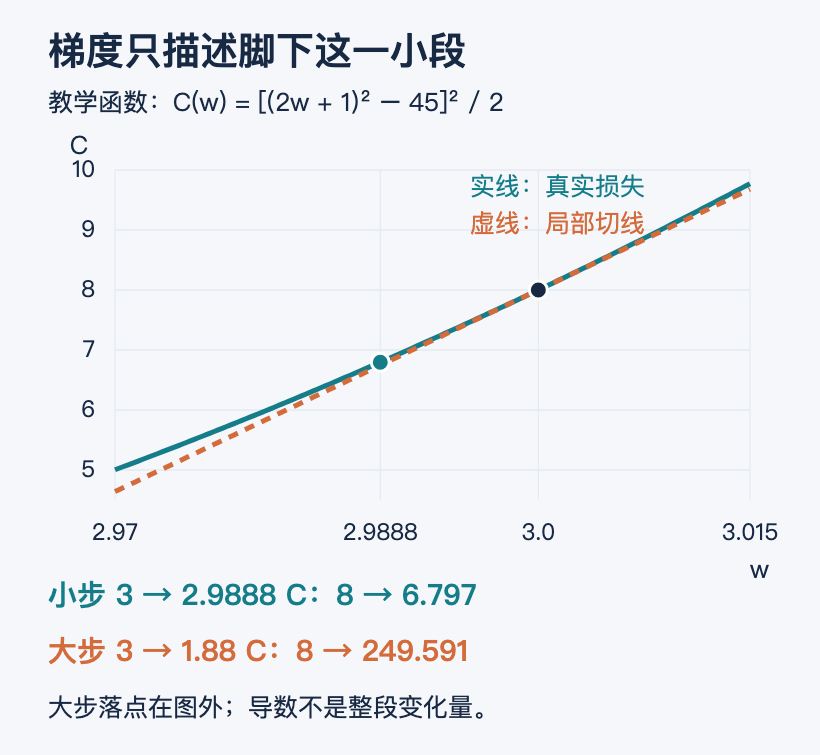
再往后,a=z²。在 z=7 的位置,平方函数的导数是十四。中间值增加很小一份,输出大约增加十四份。这里的“大约”很重要:导数说的是当前位置附近,不是把七直接换成八之后还能照着乘十四。
最后一段是损失。在输出四十九、目标四十五的位置,输出再增加很小一份,损失大约增加四份,因为平方误差的一半对输出的导数就是 a−y。
三个影响是接力发生的,所以乘起来:
权重 → 中间值:∂z/∂w = x = 2
中间值 → 输出:∂a/∂z = 2z = 14
输出 → 损失:∂C/∂a = a − y = 4

权重 → 损失:∂C/∂w = 4 × 14 × 2 = 112
这个像弯曲的 d 一样的符号叫偏导数,强调我们只改变其中一个量,其他独立输入保持不变。它不是一种新的神秘算法。这里的“一百一十二”也不是说权重应该减掉一百一十二,而是说在当前位置,权重增加很小一份,损失大约增加一百一十二份。
可以自己验一次。把权重从三改成三点零零零零零一,重新完整算一遍损失,再用损失的变化除以权重的变化,结果会很接近一百一十二。改动越小,越接近导数,但在计算机里也不能无限缩小,否则浮点数舍入会干扰相减。
这种把各环节的敏感程度相乘的规则,就是链式法则。3Blue1Brown 的反向传播微积分课用它解释一个权重如何影响最后的损失;我觉得先把几个具体数字算通,比先记住一长串符号更有帮助。
为什么要反着算?因为后半段可以共用
刚才我们从权重向后追影响,很符合直觉。但如果还要算偏置呢?偏置也影响同一个中间值,后面的平方和损失完全相同。把它们为每个参数重新计算一遍,就会重复劳动。
反过来做:先从损失出发,得到它对输出的敏感程度四;经过平方这一段,得到损失对中间值的敏感程度 4×14=56。这个五十六可以同时交给乘法和加法:偏置到中间值的导数是一,所以偏置的梯度是五十六;权重到中间值的导数是二,所以权重的梯度是一百一十二。
连输入也能算:输入到中间值的导数是权重三,因此损失对输入的导数是 56×3=168。不过这道题的输入是固定数据,我们通常不会为了把答案算对而偷偷修改题目。如果这个“输入”其实是上一层的输出,一百六十八就有用了:把它继续传回上一层,让上一层去算自己的权重与偏置。
所以,一层收到的不是“正确答案应该是四十五”,而是损失对本层输出的敏感程度。它拿这条信息做两件事:算本层参数的梯度;算本层输入的梯度,继续往前传。到更早的层,还是同一套办法。
这里也能看出为什么前向过程不能白走。反向计算需要刚才的输入二、中间值七等信息。换一道题、换一组权重,这些值就变了,局部导数也得重新算。反向传播并不是背下来一条永久有效的修改路线。
一条路乘起来,多条路加起来
真实网络不会一直像单行道。同一个数可能同时送去几个地方,最后又汇合。此时只沿一条路径算,会漏掉另一条影响。
换一个更短的教学例子:同一个权重走两条路,一条得到 u=2w,另一条得到 v=−w,最后 s=u+v。第一条路告诉我们,权重增加一点,总和会增加两份;第二条路告诉我们,总和会减少一份。两种变化同时发生,最后只增加一份。
s = 2w + (−w) = w
∂s/∂w = 2 + (−1) = 1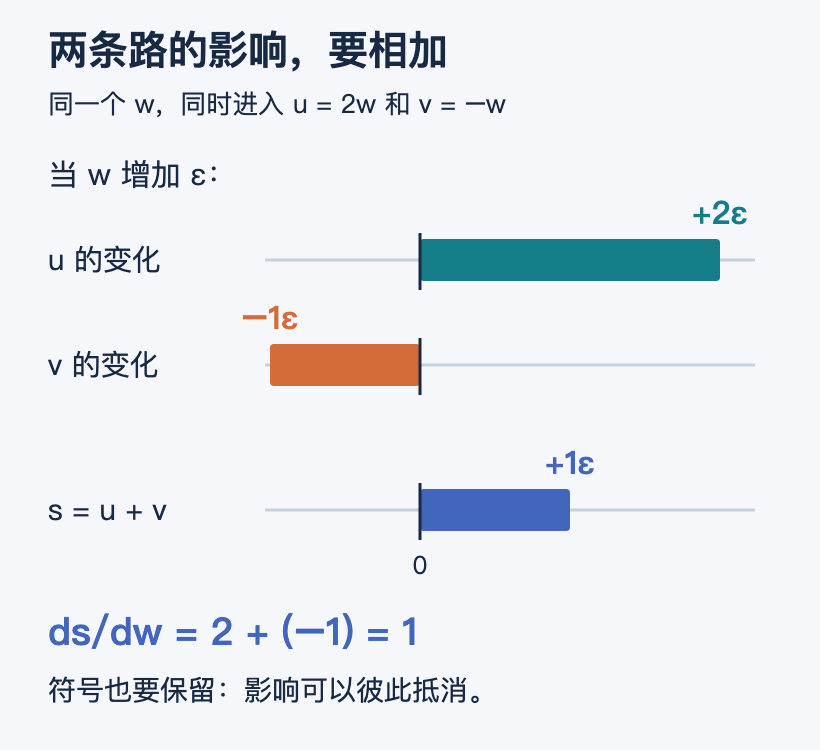
这不是投票,不能选绝对值更大的那一路,也不能把两路导数相乘。相乘描述的是前后接力,相加描述的是同一个变化通过不同路径带来的总影响。分叉再汇合的网络里,这个区别很容易被一张整齐的单链示意图藏起来。
一个直接的反例是把第二条路改成 v=−2w。此时两路各自都很敏感,合起来却完全抵消,总和一直为零。最终梯度为零,不代表每一条支路都没有活动,只代表这个量对最终结果的局部总影响为零。
Stanford CS231n 的反向传播讲义专门讨论了这种梯度流;micrograd 的实现也能看到,梯度是累加到变量上的。同一个变量被多次使用时,后到的贡献不能把先到的覆盖掉。
算出了梯度,参数还没有更新
回到第一台小机器。如果只训练权重、暂时固定偏置,最简单的梯度下降更新是:
新权重 = 旧权重 − 学习率 × 权重梯度学习率取零点零零零一,权重就从三变成二点九八八八。重新前向计算,损失约为六点八零,确实比八低。注意,这一步必须重新计算,不能只把“原损失减去一个估计值”当成新损失。
但把学习率放大到零点零一,权重一次降到一点八八,损失却约为二百四十九点五九。方向没有读反,问题是走得太远,越过了附近的低点。局部斜率没有承诺在一整段路上都成立。
这也是我不愿把梯度叫作“修改建议书”的原因。它告诉你当前位置的敏感程度,优化器再决定具体怎么走。学习率、动量等属于更新策略;反向传播负责高效计算梯度,两件事有关联,但不应该混成一个动作。
在 PyTorch 里,这个分工对应得很直观:loss.backward() 计算并累积梯度,通常由后面的 optimizer.step() 更新参数。官方自动求导教程解释了计算图和梯度累积。因此只看见程序执行了反向传播,还不能断言模型已经学了一步。
为什么不能把答案一路倒着算回去
还有一种看上去更直接的办法:既然想让输出等于四十五,那就给四十五开平方,再倒推权重,不就结束了?在这道只有一个可调权重的小题里,确实可以直接解方程。可这恰好说明了它为什么只是教学例子。
即使仍用平方,四十五就有正负两个平方根。再让权重和偏置一起变化,能给出同一输出的参数组合就更多了。到了真实训练,我们还要求同一套参数兼顾大量不同样本,不能为了让眼前一题精确对上,就随手挑一组解覆盖过去。
更麻烦的是,某些计算会丢信息。比如把负数全部截成零,看到零并不知道原来是负一还是负十。反向传播无需恢复那个被丢掉的输入;它用的是前向时实际走过的路径和当时保存的数值,计算当前位置的导数。把计算过程反向遍历,和求一个函数的反函数,是两回事。
也可以反过来想:既然能轻轻改一下权重、观察损失变化,为什么还要学反向传播?这种数值差分很适合检查小例子。如果有很多参数,逐个扰动、逐个重新运行整套前向计算,就会反复经过相同的后半段。反向传播把这些共享部分的结果留下,再分给需要它们的参数,省下的正是这种重复。
如果要自己检查这套计算,我会先固定所有输入和目标,只选一个权重做微小扰动,再把重新算出的损失变化与导数预测比较。接着换一个权重,或者换一道题,重复检查。这样能分清两类错误:前向公式本身写错了,还是反向求导漏掉一条路。不要一边改变权重,一边又换输入,否则两个变化混在一起,比较就失去了依据。
检查通过以后,再观察真正更新后的损失。前者回答“梯度算得对不对”,后者回答“这一步走得合不合适”。就像测量坡度的仪器没有坏,也不意味着我们可以闭着眼睛随便迈步。这两个问题分开,训练日志才比较容易读懂。
这并不意味着所有梯度“算一下就免费得到”。网络里的计算仍然要执行,中间数据需要存储或重新计算,数值精度也会影响结果。但它避免了为每个参数独立试探整台机器,才让大规模参数训练成为可操作的计算过程。
“误差分给每个权重”,这个说法也有边界
如果一个输入激活值很大,它连接的权重就一定该多改吗?在我们这个局部公式里,输入确实是权重梯度的一个乘数。但还要看后面的导数:非线性变换的导数可能很小,下游传来的梯度也可能为零。只盯着某个乘数,会把整条影响链的其他环节丢掉。
再比如,把目标从四十五换成五十三,其他数完全不动。输出还是四十九,但损失对输出的导数由四变成负四,权重梯度就从一百一十二变成负一百一十二。同一条连接、同样的输入强度,更新方向可以相反。决定方向的是整道题与整条计算链,不是连接自己“喜欢变大”。
还有一个容易混淆的地方:单个样本算出的梯度,只表达这一个样本的影响。另一道题可能希望同一个权重往反方向走。若训练目标是一批样本损失的平均值,那么梯度也按对应方式平均。我们追求的是选定训练目标的下降,不是保证每一道题在每一步都变好。
因此,梯度不是把总错误切成若干份、分给每个权重的责任比例。各个梯度没有必须加起来等于损失的要求,大小也会受变量尺度影响。把它们理解成一组“当前旋钮对仪表读数有多敏感”的测量值,会少掉很多误会。
我现在再看反向传播,最有用的不是记住箭头向左,而是记住三件事:每个小计算只管自己的局部导数;接力的影响相乘,分路的影响相加;算完以后,再决定参数怎么更新。模型没有突然学会反省,它只是把一笔很大的微积分账拆开,并且尽量只算一次。
评论