损失下降了,正确率为什么没涨?
用四张假想图片算清交叉熵和正确率的区别:概率一直在改善,答案却可以一个都没变;平均损失变好,也可能藏着更危险的错误。
假设你在训练一个分辨猫狗的小模型。第一轮训练完,四张固定评估图片答对三张;又练了十轮,还是答对三张。可另一条叫 loss 的曲线一直往下走。
这很容易让人犯嘀咕:到底是模型在进步,还是训练程序在自我安慰?如果正确率才是我们要的,为什么不直接盯着正确率训练?
我觉得理解这件事,最有用的办法是先别看那条漂亮的曲线。把模型每次交出的答案摊开,看看从“一组概率”变成“猫或狗”时,我们丢掉了什么。
同样答对,模型其实交了两份不同的答卷
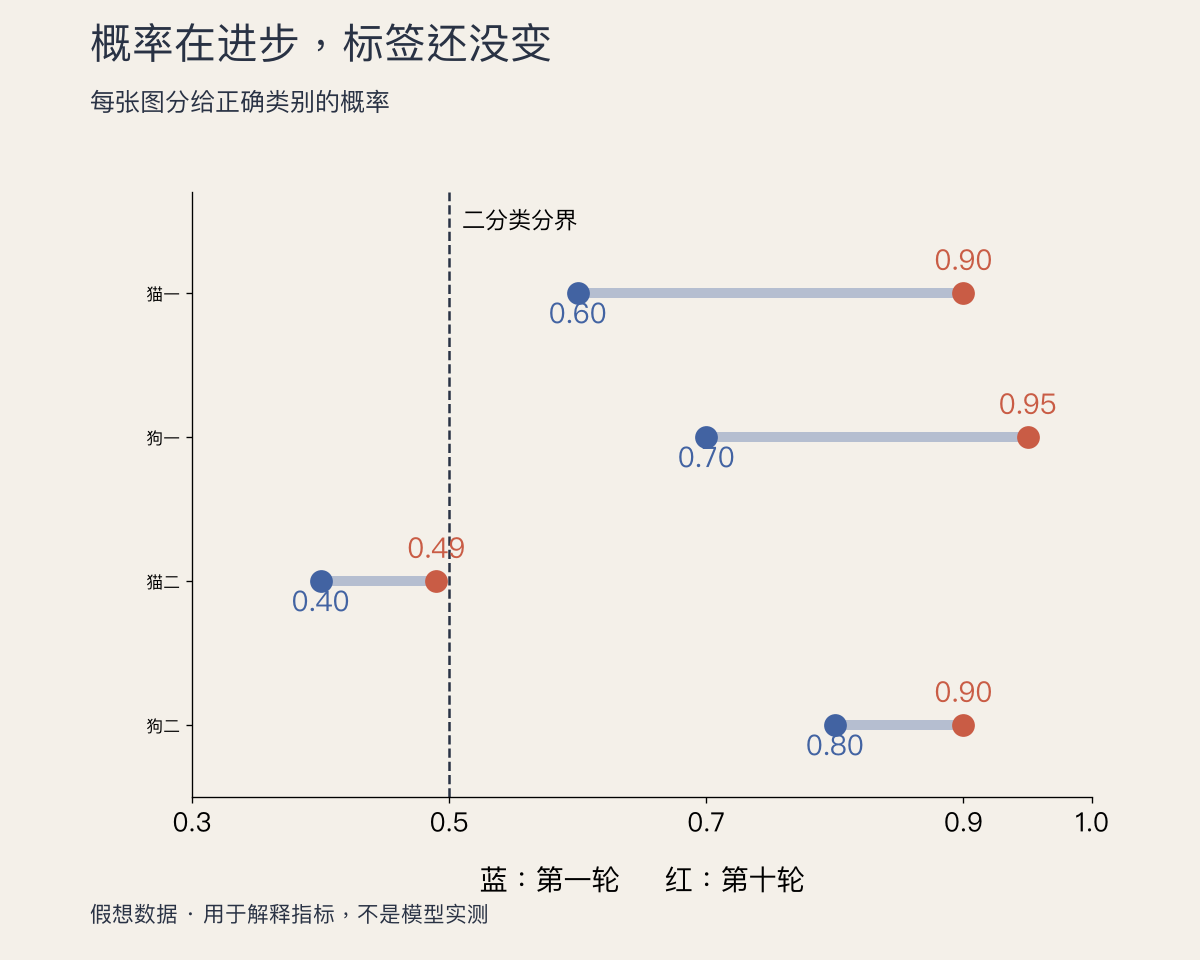
下面都是为了说明原理构造的数字,不是某个模型的实测结果。假设四张图片的真实类别依次是猫、狗、猫、狗。我们只记录模型分给正确类别的概率:
| 图片 | 第一轮 | 第十轮 | 最终分类变化 |
|---|---|---|---|
| 猫一 | 0.60 | 0.90 | 猫 → 猫 |
| 狗一 | 0.70 | 0.95 | 狗 → 狗 |
| 猫二 | 0.40 | 0.49 | 狗 → 狗 |
| 狗二 | 0.80 | 0.90 | 狗 → 狗 |
在这个只有两个互斥类别、选择较大概率的例子里,分给正确类别的概率超过一半,分类就对了。四张图始终只有第三张答错,正确率都是百分之七十五。
但两份答卷明显不一样。第一张图从有点犹豫变得相当确定,第三张图虽然还没翻盘,却已经从偏向错误答案走到了接近分界线的位置。正确率把这些变化全压成了零:只要最后选出来的标签没变,就不记这一笔。
这不是正确率算错了。它本来就在回答一个很具体的问题:按当前决策规则,最终有多少题选对。如果需求是自动把图片分到两个文件夹,这个数字当然有用;但想知道模型给各种可能性分配概率的方式有没有变化,它就太粗了。
这里还藏着一个容易漏掉的条件:一半这条线只适用于我们刚才设定的二分类规则。三个类别分别得到零点四、零点三五、零点二五时,第一类已经胜出,不需要超过一半。多分类通常比较谁最大,不能把二分类的直觉原样搬过去。
交叉熵看见了正确率扔掉的东西
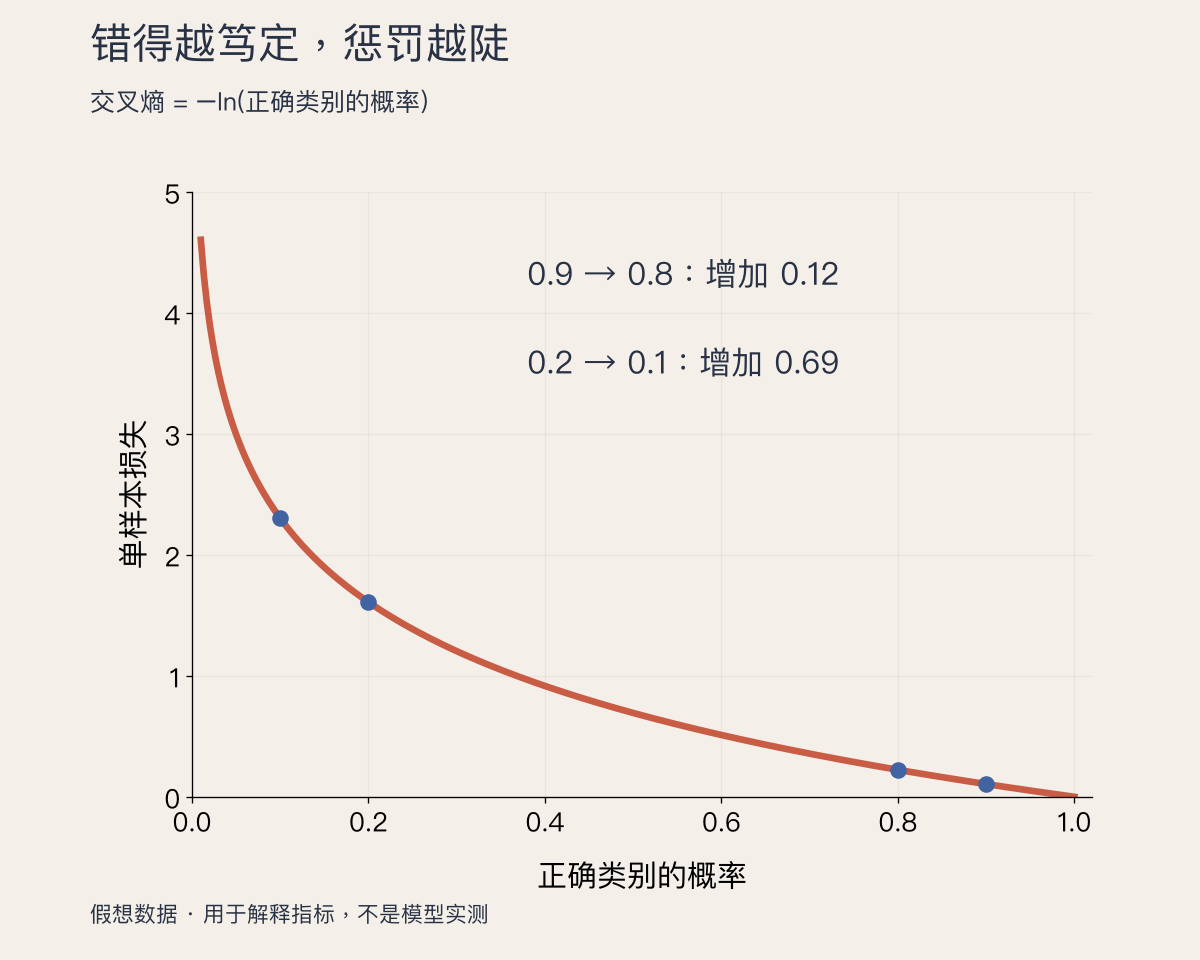
对一个有确定正确标签的分类样本,常见的交叉熵可以写得很短:损失等于正确类别概率的负自然对数,即 −ln(p)。正确类别拿到的概率越高,这一项损失越小。
这不是让模型自己说“我多有把握”,再照单全收。计算时我们拿着标准答案,专门检查概率有没有分给那个答案。给错误类别百分之九十九的概率,看起来很自信,但正确类别只剩百分之一,得到的惩罚反而很重。公式及其取平均的口径可以对照 scikit-learn 的 log loss 定义。
把前面四张图代进去,第一轮四项损失大约是零点五一一、零点三五七、零点九一六、零点二二三,平均零点五零二。第十轮则约为零点一零五、零点零五一、零点七一三、零点一零五,平均零点二四四。
正确率没动,损失下降一半左右,完全可以同时成立。因为交叉熵保留了概率变化,正确率只保留了分类结果。前者看见第三张图离翻盘近了一点,后者要等它真正翻盘才会记分。
为什么要取对数,而不直接用“一减去正确概率”?一个直观区别是,它很在意那种错得离谱还特别笃定的预测。正确类别的概率从零点九降到零点八,损失增加约零点一二;从零点二降到零点一,增加约零点六九。概率都少了零点一,代价并不一样。
不要把这理解成任意一种错误都必须无限放大。真实训练还可能使用类别权重、标签平滑等设计,损失也可能包含正则项。这里刻意只算普通的、没有加权的分类交叉熵,避免把不同问题揉成一条公式。
为什么不直接拿正确率来训练
想象你只给一个学生两种反馈:“对了”和“错了”。他把错误答案从很离谱改得接近正确,你仍然只说“错了”。作为最终考试评分,这没什么问题;作为一步一步修改的依据,信息就不够用了。
在刚才第三张图上,把正确类别的概率从零点四调到零点四一,最后标签还是错的。再调到零点四二,仍然错。只要没跨过边界,基于最终标签算出来的正确率就一直不动。对于依赖梯度的普通训练方法,这种大片平坦、在边界处突然跳变的目标,不适合直接提供细致的调整方向。
交叉熵则允许我们在最后选项不变时,仍然分辨哪次概率分配更好。模型先输出连续的分数,再通过适当的概率变换计算损失,反向传播把损失对参数的变化率传回去,优化器据此更新参数。最后挑最大类别,是评价或使用模型时的另一件事。
于是训练目标和验收指标可以不相同。训练目标要能给出有用的调整信号,验收指标要能回答使用者关心的问题。它们应当相关,但不必逐步同步;也不能因为一个方便训练,就把另一个从验收里删掉。
比如第三张图的正确概率从零点四升到零点四九时,训练信号可以一直改善,而文件夹里的分类结果毫无变化。再往前一点,达到零点五一,分类才突然翻转。读训练进度时保留概率,验收分类效果时检查标签,两份记录并排放着,就不必强迫一条曲线解释所有变化。
更反直觉:损失下降,正确率还可能变差
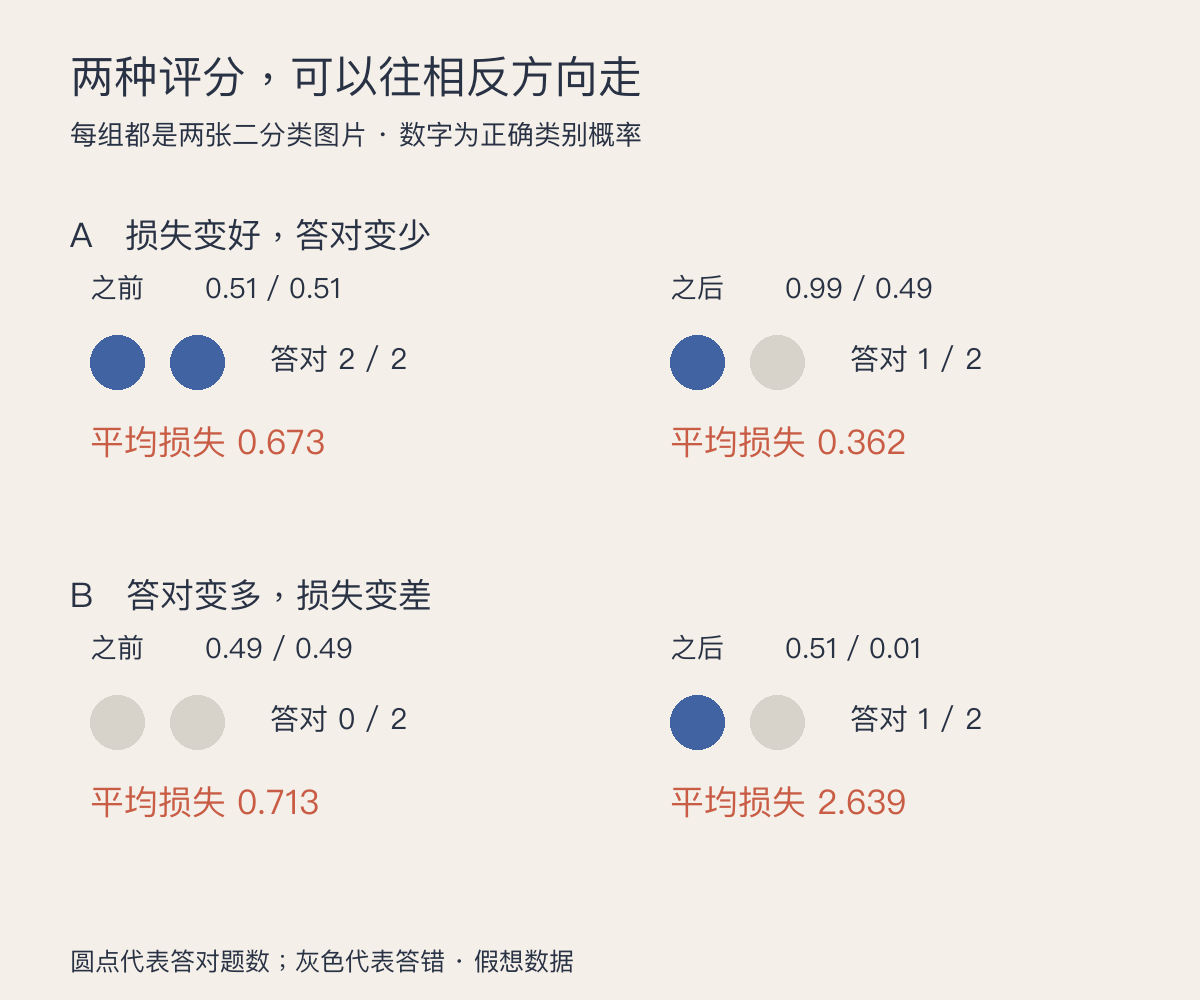
前面的例子只是两条指标不同步。再做一个更尖锐的假设:两张二分类图片,第一次分给正确类别的概率是零点五一、零点五一,两张都答对,平均损失约零点六七三。
第二次变成零点九九、零点四九。第一张大幅变好,第二张刚好跌到错误一边。正确率从百分之百掉到百分之五十,平均损失却降到了约零点三六二。
没有任何数学矛盾。平均交叉熵允许不同样本的改善和恶化相互抵消;第一张改善的幅度,超过了第二张恶化的幅度。而正确率把第一张的巨大改善记作没有变化,把第二张轻微跨线记作整整一道错题。
反方向也成立:分类答对得更多,平均损失仍可能上升。假设两张图原先正确类别概率是零点四九、零点四九,后来变为零点五一、零点零一。你终于答对一题,却在另一题上变得极端错误。平均损失会从约零点七一三升到约二点六三九。
这两个例子还提醒我:只看平均数不够。一个模型可以在容易的样本上持续进步,同时在某个小类别上退步。总体数字会把这件事藏起来。评估时挑几种有意义的样本分组,检查谁改善、谁变差,往往比争论哪条曲线更“真实”更有帮助。
概率变高,不等于概率说得准
还要把一个词分开:我们说模型“更确定”,描述的是输出概率;说它“更可靠”,则需要额外的证据。
如果把大量预测为八成可能的样本放在一起,最终确实大约八成属于那个类别,这才是概率校准所关心的对应关系。单看某一题从零点六变成零点九,并不能说明整个模型的概率已经可信。题目本身可能有歧义,也可能存在标注错误;一味把每个训练样本都推到接近百分之百,未必是我们最终想要的东西。
这也解释了为什么“损失更低”和“校准更好”不能直接画等号。概率评分同时受多方面因素影响。要专门检查概率准不准,还要把预测按概率分段,对照每段实际发生的比例,而不是拿一项平均损失包办所有结论。scikit-learn 的概率校准说明专门提醒了这个区别。
如果产品会根据概率决定是否交给人复核,这个区别就很实际。分类标签相同的两个模型,一个经常不确定,一个处处拍胸脯,它们进入复核流程的行为可能完全不同。那时需要验收的是概率和决策规则共同产生的结果,不能只报一个总正确率。
真正看到两条曲线分叉时,我会先查什么
第一件事是确认它们是不是在同一批题上算出来的。训练损失下降、验证正确率停住,和同一验证集上损失下降、正确率停住,是两种情况。前者可能只是越来越熟悉练习题,还不能据此判断面对没见过的图片有无进步。
接着看计算口径。损失有没有类别权重,是否混了正则项?正确率按样本平均,还是先按类别算再平均?阈值和预处理是否保持一致?口径不同的数字摆在同一张图上,很容易被误读成模型行为的冲突。
然后把最终标签和预测概率一起保存,找一小批前后对照。多少样本只变了概率、没有换标签?哪些题刚好跨过边界?损失的主要改善来自大多数题的小幅进步,还是少数题的大幅变化?这些问题都能用具体样本回答,不用猜曲线的心情。
还要看类别分布。假设一百张图里九十五张是猫,全部猜猫就能得到很高的总体正确率,却不会识别狗。这时每类召回率、混淆矩阵比一句“正确率很高”更能说明问题。决定采用哪个指标,要回到漏掉哪种错误会影响实际用途。
还有一个很容易误操作的地方:改变分类阈值,可以在模型参数完全不动时改变正确率。比如把“判为狗”的门槛从一半提高到七成,一些原先判狗的图片会被改判为猫。这个动作没有让模型重新学习,却会改变哪类错误更多。不能把调阈值得到的指标变化,误记成模型本身的训练进步。
阈值当然可以调,只是要有独立的验证数据和明确目标。若需求特别怕把猫错放进狗的文件夹,就检查这个错误是否减少,同时检查漏掉多少真正的狗。反复盯着同一份最终测试集挑阈值,会把它也变成调参用的练习题;最后仍需要留一份未参与选择的数据检验结果。
最后才决定要不要继续训练。验证损失仍在下降,可以是值得继续观察的信号;但如果最关心的任务指标长期没有改善,就要检查数据、目标和使用规则是否对齐。不要因为曲线好看就无限延长训练,也不要因为正确率暂时没跳一个台阶,就马上判定所有更新都白做了。
大模型训练也有类似距离:预测下一个词的损失更低,不自动等于一整道题回答正确,更不等于一次工具任务已经做成。词的概率、完整答案和最终任务结果,处在不同的评估层次。
我现在更愿意把训练曲线当成两种各有用途的读数。损失告诉我,模型正在怎样重新分配可能性;正确率告诉我,按约定规则落下的那些决定对了多少。看懂它们各自漏掉什么,才知道下一步该检查哪份答卷。
评论