明明沿着下坡走,损失怎么越走越高:学习率讲人话
用一个只有单个参数的模型手算四种学习率,再拆开小批次波动与验证集退步:梯度告诉你附近朝哪走,却没有承诺一步跨多远都安全。
“训练就是沿着负梯度,让损失越来越小。”这句话很顺,顺到让人以为训练曲线应该一直向下。可真正看日志,经常是下一步比上一步更高,甚至越训越离谱。
方向都算出来了,怎么还能走错?我觉得这里最容易漏掉的,是“附近”两个字。梯度描述当前位置附近的变化,学习率决定我们把这个判断用到多远。方向没错,不代表迈出去的那一步合适。
先不碰几百亿参数。拿一个只有一个旋钮的模型,算几步就能把这件事看清楚。
一个旋钮,一张成绩单
假设有个极简模型,无论输入什么,它都输出参数 w。现在只有一道练习题,目标答案是三。我们用预测值与三的差的平方打分,分数越低越好:L(w) = (w - 3)²。
这是为了讲原理构造的玩具问题,不是某次真实模型训练。w 等于零,损失是九;w 等于一,损失是四;w 等于三,损失就是零。把这些点画出来,是一个底部在三的碗。
训练时,题目和目标暂时不动,我们调整的是 w。损失因此成了“参数取什么值,会得到多差的成绩”这张成绩单。换成神经网络,不过是旋钮变成许多权重和偏置,最后仍要汇总成一个用于优化的数。
这里有两个常被混淆的动作。前向计算是把当前参数代进去,看看答成什么样;参数更新才是改旋钮。模型刚做完一道题,不代表已经从这道题里学到了东西。只有后续计算并应用更新,参数才真的变化。
为了决定往哪改,我们求损失对 w 的导数:L′(w) = 2(w - 3)。在 w 等于零时,导数是负六,意思是当前位置往右挪一点,损失会往下降。它并不是说“损失现在是负六”,也不是说“一定要把参数加六”。损失的高度和曲线的斜率是两种数字。
最朴素的更新规则是 新 w = 旧 w - 学习率 × 当前导数。导数负责提供局部信息,学习率负责缩放更新。两者相乘,才是这次真正移动的距离。
同一个下坡方向,四种结局
从 w 等于零出发,把学习率设为零点一。第一步算出来是 0 - 0.1 × (-6) = 0.6,损失从九降到五点七六。
走到零点六以后,不能继续拿负六当路标。这里的新导数是负四点八,第二步因此走到一点零八,损失变成三点六八六四。再往后,每次都重新看脚下的坡度,逐渐靠近三。学习率虽然不变,实际步幅却在变小,因为靠近谷底时梯度也变小了。
现在把学习率改成零点五。同样从零出发,第一步恰好到三,一步结束。看起来像发现了神奇参数,其实只是这条特殊二次曲线刚好配合。换一个碗的陡峭程度,这个数字就不灵了。
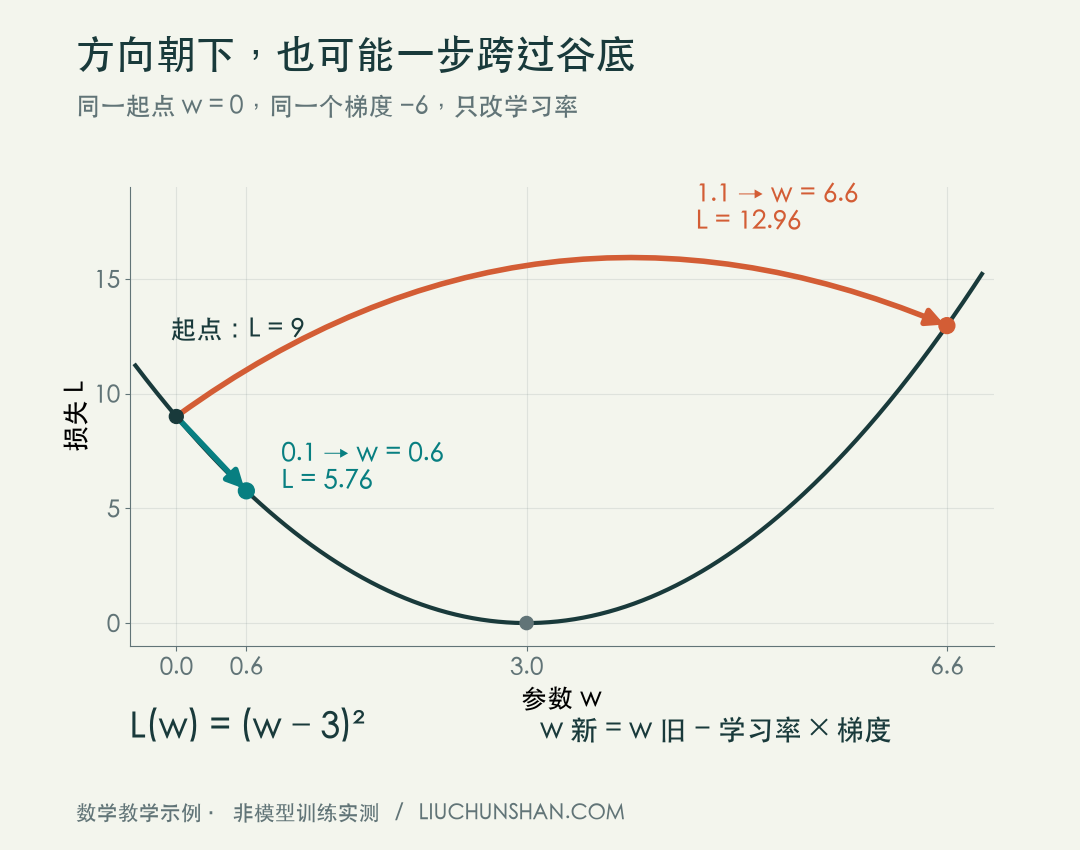
再改成一。第一步从零走到六,损失仍然是九;六处的导数是正六,下一步又从六退回零。它每一步都朝着当前的下坡方向出发,却恰好越过谷底,落到对面同样高的位置。零和六来回跳,训练没有进展。
学习率继续加到一点一,第一步落在六点六,损失变成十二点九六;第二步退到负一点三二,损失继续升高。它不是不肯改,而是每次改得过头,下一次又用更大的幅度纠偏,越纠越远。
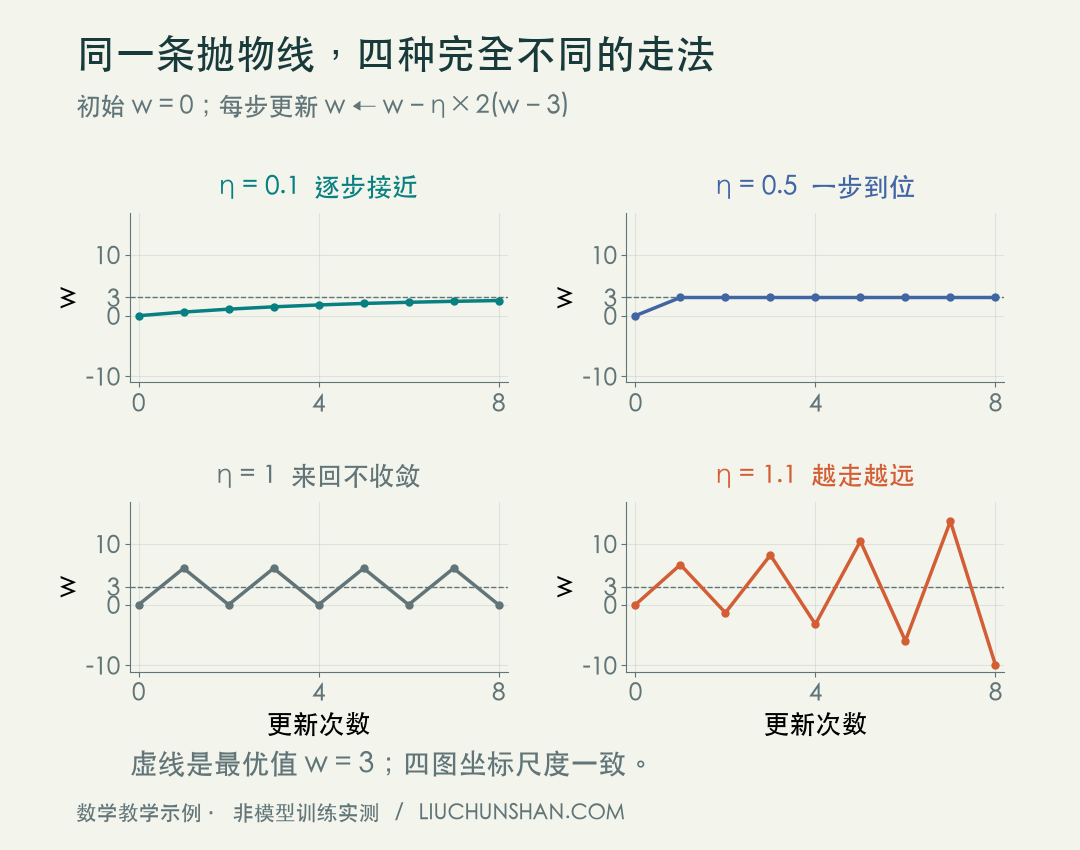
这几个数还可以压成一条精确关系:更新后离三的有符号距离,等于更新前的距离乘以 1 - 2 × 学习率。零点一对应零点八,每次距离缩成八成;零点五对应零,直接到达;一对应负一,只翻转方向;一点一对应负一点二,翻过去还多出两成。
负号本身不是失败。比如学习率零点七五,对应负零点五,也会在两侧来回换边,但距离每次减半,仍然收敛。真正该看的,是离目标越来越近还是越来越远,不能见到“越过谷底”四个字就判定训练坏了。
这套推导只针对我们自己写下的碗。真实网络没有一个通用的“学习率小于一就安全”的门槛。《动手学深度学习》的梯度下降章节说明了小范围近似与步长过大的关系;具体门槛必须连着目标函数一起看。
为什么方向正确,还得限制距离
想象在山坡上铺一小块直木板。木板能贴近脚下的坡面,却不能保证整座山都沿这个倾斜方向延伸。走出去一小步,木板是不错的提示;按它的斜度一路冲下去,可能早已跨过山谷,冲上另一侧。
数学里的局部近似就是这块木板。对于足够平滑的函数,在梯度不为零的地方,沿负梯度移动足够小的距离,可以让函数值下降。关键限定是当前位置、足够小、足够平滑,不能删掉限定,只留下“负梯度保证下降”。
也可以直接检查我们的碗。在零处,曲线的切线会预测:往右越远,损失越低。可真实损失还有弯曲的部分。走到六时,切线仍觉得赚到了,曲线却已经绕过谷底,回到原来的高度。
多参数问题里,每个参数各有一个局部变化率,把它们装进一个向量,就是梯度。它不需要真的把每个旋钮挨个试一遍;反向传播利用计算关系,把损失的变化往回传,得到这些导数。但“算得高效”和“看得很远”仍是两回事。
梯度也不提供整张地形图。某个位置坡度接近零,可能靠近谷底,也可能在平坦地带,或处于某些方向向上、另一些方向向下的鞍点附近。仅凭“梯度小了”,不能推出“已经找到最好的模型”。
换个刻度,同一个学习率就变了味
再做一个小改动:题目完全不变,只把成绩单乘一百,写成 J(w) = 100(w - 3)²。最好的参数仍然是三,模型能表达的答案也没变。
但是导数变成 200(w - 3)。从零开始,刚才显得温和的零点一学习率,这次会把参数直接送到六十。若想得到原来从零到零点六的那一步,学习率得改成零点零零一,也就是原来的百分之一。
这解释了为什么不能孤零零地问“零点一算大吗”。学习率是乘在梯度上的,梯度的尺度变了,同一个数字的含义就变了。把批次损失求和改成求平均,在其他条件相同的普通梯度下降里,也会改变梯度大小。
如果一个批次有十六条样本,求和的梯度就是求平均的十六倍。原样搬学习率,就等于悄悄把更新放大十六倍。实际训练还可能有正则项、梯度裁剪和自适应优化器,不能用这条比例包打天下,但比较配置前先核对损失怎么汇总,通常比背一个推荐值更有用。
再想一个有两个旋钮的假设目标:Q(u, v) = u² + 100v²。最优点在原点,两个方向却不一样陡。若都从一开始,学习率取零点一,u 会变成零点八,v 却会变成负十九。一个方向走得很稳,另一个方向早已冲出去了。
把统一学习率缩小到千分之一,v 可以稳稳走到零点八,u 却只挪到零点九九八。这就是有些训练“放大就炸,缩小又慢”的一个可手算原因:几个方向需要的尺度不同。它并不是所有训练困难的解释,但足以说明,调一个全局旋钮不总能让每个参数都舒服。
诸如自适应优化器这样的办法,会进一步改变各个方向实际使用的更新幅度。此时不能拿最朴素梯度下降的学习率,和另一个优化器的同名数字直接比较大小。若没有把更新规则一起说明,单独贴一个学习率,往往还不足以复现别人的训练。
因此,学习率更像一个需要连着仪表刻度读取的旋钮。换模型、换损失定义、换优化方法后,要重新确认它控制的实际变化,而不是把旧数字当成经验护身符。
曲线抖一下,也可能只是换了一批题
前面一直盯着同一个固定目标。真实训练常常每次只抽一小批样本,计算这一批的平均损失和梯度,这叫小批次随机梯度下降。计算量因此更容易控制,也便于批量运算。
不同批次对参数的意见不完全一样。在均匀随机抽样等条件下,批次梯度可以估计整体梯度,但某一次不等于整体。相关定义可看随机梯度下降与小批次章节。
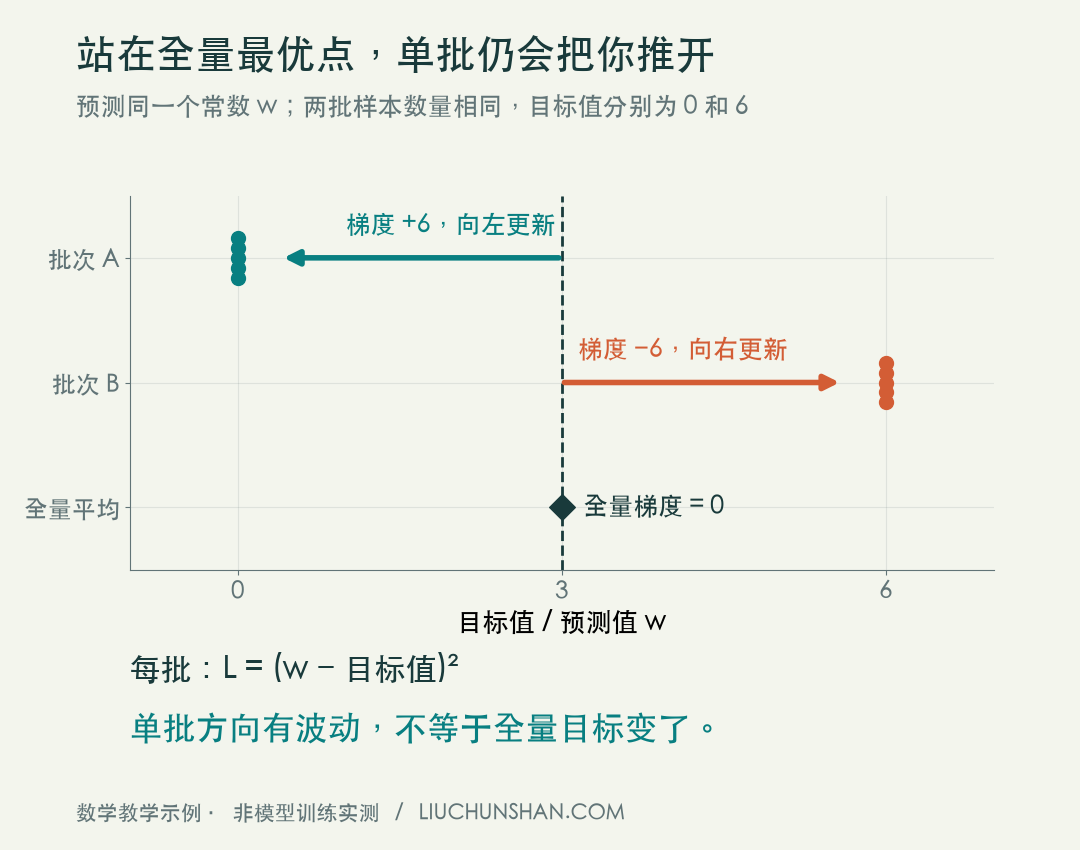
仍用单参数模型,改成两道题:一道目标是零,另一道目标是六。完整损失是两道平方误差的平均,整理后为 (w - 3)² + 9,最好的折中仍然是三。
如果已经站在三,完整梯度为零。但只抽到目标零的题,梯度是六;用零点一的学习率更新,就走到二点四。刚抽到的这道题答得更好了,整体损失却从九升到九点三六。即使更新幅度不夸张,小批次的一次进步也可能是总体的一次退步。
还有一个更简单的错觉:日志上一行是容易的一批题,下一行是难的一批题。两行损失不是在同一张试卷上量的,后者更高,不能直接证明参数更新失败。
我会先确认图上画的究竟是什么:当前批次损失、固定训练子集上的损失,还是验证集损失。给曲线做平滑,能让趋势更好读,却不会把不同试卷变成同一张,也不能证明每一步都变好了。
训练分数下降,为什么还要看另一张卷子
到这里,即使我们真的让固定训练集损失稳定下降,也只说明模型越来越适合这批训练题。模型要拿去回答新问题,还得用没有参与参数更新的数据检查。
这也解释了“同样训到很低的损失,两个模型效果仍然不同”为什么不矛盾。练习题可能容许多套参数都拿高分,但这些参数在题目之外怎样延伸,并没有被训练成绩唯一规定。训练损失是必要的观察窗口,却不是模型能力的完整说明书。
假设训练数字识别器,训练图片总是笔画居中,验证图片却有一些写得偏右。模型可能越来越善于记住训练题的布局,对偏右图片却没有改善。这个例子只是说明两种评价可以分离,并不是说出现差距就一定由位置引起。
训练目标和泛化表现需要分开看,验证集长期不再改善时,也可以按预定规则停止训练。相关背景见深度学习中的泛化。别把单次验证波动当结论,更别反复拿最终测试集挑参数,最后再把同一份成绩当成未见数据的验收。
回到最开始那条上蹿下跳的曲线,我会依次问:比较的是不是同一批题?损失的平均方式有没有变?同一设置缩小学习率后,固定数据上的走势是否更稳定?训练集在改善时,验证集发生了什么?
如果怀疑步幅过大,就固定初始参数、数据顺序和其余条件,比较几档学习率的短程结果。若只是换了批次造成抖动,强行把曲线调得很顺,未必值得;若验证集持续退步,只盯着训练损失加速下降,也可能是在朝错误的目标努力。
训练后期逐步减小学习率,是给更新留出细调空间的一种办法,但怎么减、何时减仍要看任务。学习率调度章节讨论了这种取舍。不要把“越小越稳”再误读成“越小越好”:在有限时间里,步子小到几乎不动,同样完不成训练。
我更愿意把梯度理解成一张只在脚下有效的路标。它回答附近朝哪边走,学习率决定这次走多远,而走到之后究竟有没有更接近目标,还得重新量。
评论