神经网络叠了一百层,为什么还可能只是一条直线?
从权重、偏置和激活值的区别出发,用四个点与几条折线手算一个小网络:为什么只有乘加的深度能被合并,激活函数又给模型增加了什么能力。
看神经网络的示意图,很容易被一排排圆点和密密麻麻的连线镇住。输入经过一层,再经过一层,最后认出一张图片。直觉会说:既然每层都在加工信息,多叠几层,总该多学会一点东西。
但有个条件经常藏在那些连线之间。如果每层只做“乘一个数,再加一个数”,那么叠两层、十层,甚至一百层,最终仍然可以合并成一次同类运算。计算绕了很远,能表达的关系却没变得更曲折。
我觉得这是理解神经网络很好的入口。先不用背层数和参数规模,拿纸算几个数,就能看出激活函数为什么不能只是图上的一个装饰。
圆点里的数,和线上的数不是一回事
先想象一个简化的手写数字识别器。图片由许多像素组成,每个像素的明暗可以用一个数表示。为了方便,我们把黑色记作零,白色记作一,中间的灰色放在两者之间。这些数字是本次输入,不是模型学到的知识。
网络中的一个小单元会从上一层接收若干数字。它先给每个数字乘上一个权重,再把结果加起来,最后加上一个偏置。假设只有两个输入,过程可以写成 z = w₁x₁ + w₂x₂ + b。这里的 z 是加工到一半的结果,还没有经过激活函数。
权重可以理解成每路输入在这一次加总里有多大影响。正数把结果往上推,负数往下拉,绝对值越大影响越强。但它并不是统计学里已经计算好的“相关系数”,也没有必须落在零到一之间的限制。偏置则给整个结果加一个固定偏移,允许这道判断挪动位置。
接着,激活函数接过 z,算出往下一层传的值。这个输出叫激活值。换一张图片,激活值通常也会变;在模型固定的前提下,权重和偏置不会跟着每张图片重新设置。前者像正在流过仪表的读数,后两者像仪表里已经调好的旋钮。
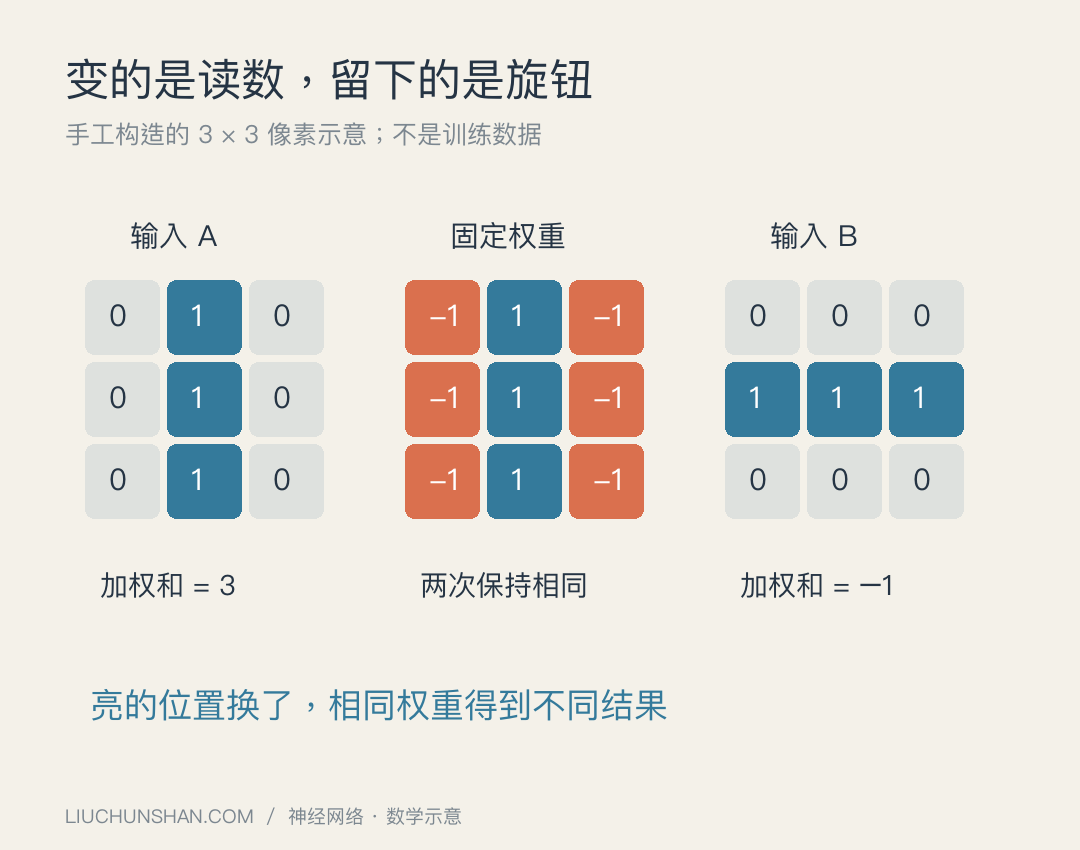
所以,“一个神经元里装着零到一之间的数字”只适合某些入门模型的画法。例如 sigmoid 会把输出压进零到一之间;ReLU 的输出可以大于一。不要把某种演示用的数值范围,当成所有神经网络的身份证。
3Blue1Brown 的神经网络入门课用像素、权重和激活值解释这套计算。看图时把这三种数字分清,后面就不容易把“模型参数”和“模型此刻算出来的东西”混为一谈。
两层计算,为什么能缩成一层
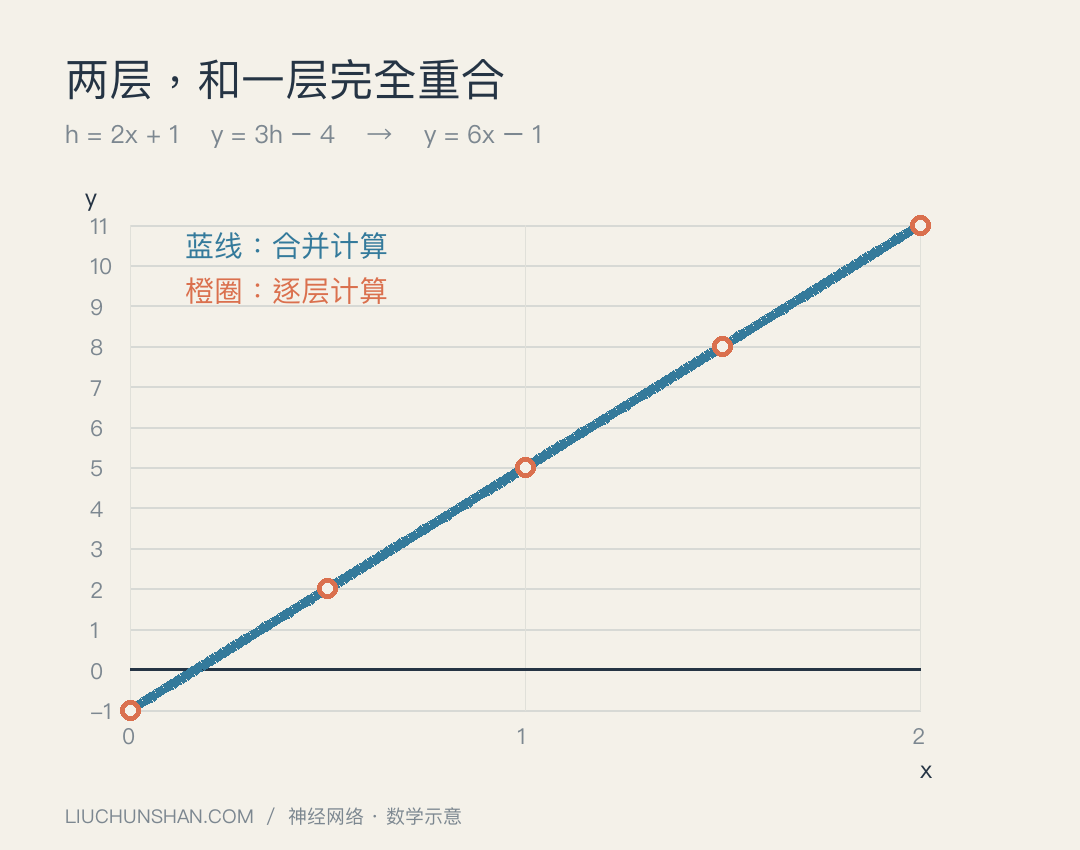
现在暂时拿掉激活函数,只留乘加。第一层做 h = 2x + 1,第二层做 y = 3h - 4。把 h 代进去,得到 y = 3(2x + 1) - 4 = 6x - 1。
第一次放大两倍,第二次再放大三倍,总共就是六倍。第一次加的一也会被后面的三倍放大,再和减去的四合并,最后只剩负一。两道工序完全可以写在一张新配方上,输入输出关系没有任何变化。
继续在后面加一层 q = 5y + 7,也只是得到 q = 30x + 2。系数变了,仍然是直线。严格说,包含偏置的这种变换叫“仿射变换”;日常讲神经网络时,常把承担这项计算的模块叫线性层。PyTorch 的 Linear 文档也明确写的是仿射变换。
输入不止一个数字,结论也不变。把一串数字写成向量,把所有权重排成矩阵,两层就是 h = W₁x + b₁、y = W₂h + b₂。展开后得到 y = (W₂W₁)x + (W₂b₁ + b₂):仍然是一份新权重加一份新偏置。
这里“只是一条直线”是拿单输入、单输出作直观比喻。在高维空间里,它可以是更一般的仿射映射;如果用这种输出做二分类,固定阈值对应的是一个平面或超平面。不是说所有维度都挤到了一条线上,而是没有凭空得到能弯折的判断边界。
这也不等于“深层线性网络毫无研究价值”。把同一个映射拆成多组参数,可能改变优化的过程,隐藏层太窄还可能限制矩阵的秩。这里说的是表达形式:只靠仿射层的串联,不能把本来不属于仿射关系的目标变成可表达的关系。
四个点,就能难住一把直尺
来看一个完全假设的小游戏:两个开关状态都只能是零或一,恰好一个开关打开时输出一;两个都关、两个都开时输出零。这就是异或,通常写作 XOR。
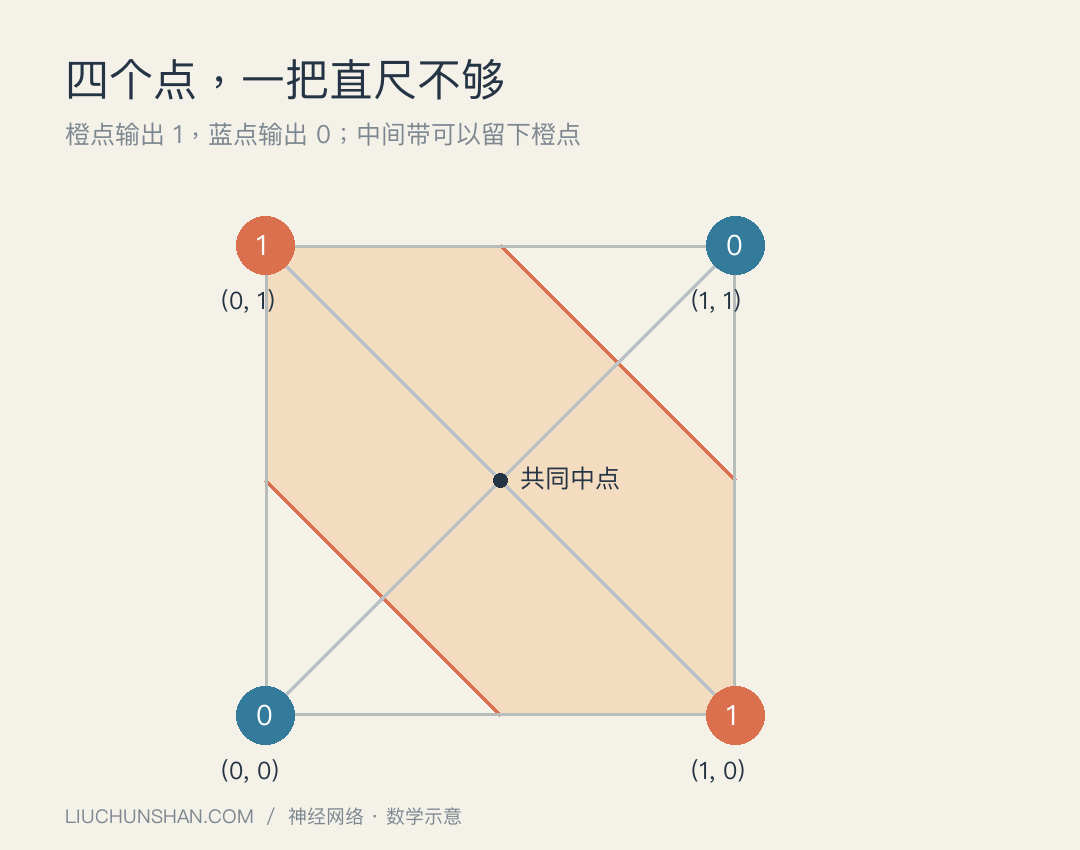
把第一个开关放在横轴,第二个放在纵轴,就得到正方形的四个角。左下和右上属于一类,左上和右下属于另一类。现在给你一把无限长的直尺,要求一侧放所有输出一的点,另一侧放所有输出零的点。怎么旋转和平移,都不能把这两对对角点一次分开。
一个简单的证明是看正方形中心。两颗输出一的点连起来,其中点是中心;两颗输出零的点连起来,中点也是中心。若某条直线能把两组点严格放在不同侧,那么各自线段的中点也必须在不同侧。同一个中心不可能同时待在两边。
这个例子小,却能解释一些“大网络为什么还是学不会”的困惑。假如模型表达能力被限制成一条直线,多给它训练时间,只是在尝试更多斜率和位置;多喂重复样本,只是在更确定地告诉它那四个点在哪里。问题不是它没看清题目,而是工具里根本没有需要的形状。
实际任务当然不会只剩四个点。我们也不能看到错误就断定缺了非线性,数据质量、优化方法、标签和任务定义都可能出问题。但在这个小例子里,表达能力的限制可以被明确证明,不必把失败归咎于“参数还不够多”。
激活函数给直线加了一道折痕
最容易手算的一种激活函数叫 ReLU。规则只有一句:输入大于零时原样通过,否则输出零。用公式写是 ReLU(z) = max(0, z)。它并不复杂,却让一条直线在零的位置折了一下。
把偏置放进去,ReLU(x - 1) 的折点就移到了 x 等于一的位置。改变权重可以调整斜率和朝向,改变偏置可以移动折点。把几条这样的折线按不同系数相加,就能拼出一条只有一段凸起来的曲线。
例如 f(s) = ReLU(s) - 2ReLU(s - 1) + ReLU(s - 2)。不要急着把它当成难懂的公式,分别代入零、一、二即可:三个输出恰好是零、一、零。它在零到一之间向上走,在一到二之间向下走,之后回到零。
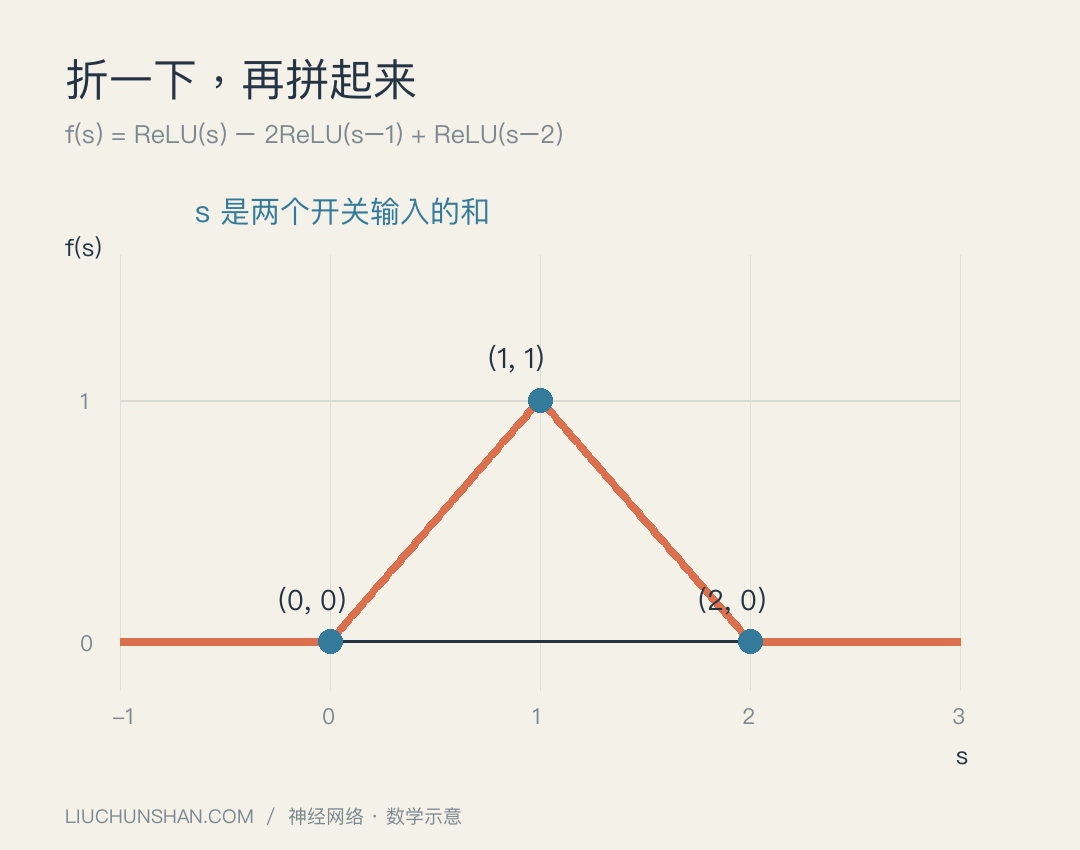
再让 s = x₁ + x₂,刚才那四种开关组合就解决了。两个都关,和是零;恰好一个打开,和是一;两个都开,和是二。把这个和送进帐篷形函数,得到的正好是异或结果。
这其实已经构造出了一个小型前馈网络:三个隐藏单元分别计算三项 ReLU,输出层用一、负二、一把它们合起来。这里的系数是我们为了演示手工挑的,没有进行训练,也不是在展示某次实验的准确率。对四个输入逐一代入,就能验证答案。
这个变化比“给输出压一个范围”更根本。原本一路乘加,不同输入都遵循同一份直线配方;加入 ReLU 后,有些单元在某些区域输出零,在另一些区域传递变化,不同区域能够采用不同的配方。局部看仍像直线,拼起来却已经会转弯。
Dive into Deep Learning 的多层感知机章节讨论了隐藏层、非线性激活和这种表达能力的区别。ReLU 的精确定义也可以直接查 PyTorch 文档。上面的折线和四个点,是按定义手工构造的示例,不需要借用某个模型的宣传数字。
先数参数,再看它们能做什么
有了这个小网络,还可以顺手拆掉另一个误会:圆点的数量并不是参数的数量。刚才三个隐藏单元,每个都接收两个输入,所以每个需要两个权重和一个偏置,一共九个参数。输出单元接收三个隐藏值,再加自己的偏置,又有四个。这个全连接写法总共十三个参数。
我们写公式时让某些权重相同、某些偏置等于零,只是把参数挑成了特定数值。如果代码里并没有额外设置共享或冻结,它们仍然是各自独立的位置。训练过程可以把它们改成不同的数。参数的含义是可调整的自由度,不能只数最终打印出来有多少个不同数字。
再想一个反例:同样给你十三个参数,却全部安排在纯仿射层里。它们可以组合出不同的斜率和偏移,仍然跨不过异或那条边界。于是“参数多一点”和“拥有合适的运算”不能互相替代。比较模型时只看参数总量,容易漏掉这层差别。
也别把刚才的手算网络误认成万能的开关理解器。我们只证明了四个角上的输出。输入如果变成零点二、零点八,是否应该输出一,取决于任务对连续输入的定义;仅凭四个训练点,不能自动决定整个平面上什么答案才正确。网络在未见位置怎么延伸,是另一道需要数据和假设来约束的问题。
这个区分在实际学习里很有用。验证一个小模型时,可以先把已知样本逐一算对,再试样本之间的位置,最后试离它们很远的位置。前一步检查是否表达得出来,后两步提醒我们:一条经过训练点的曲线,未必就是世界真正遵循的规律。
有了折痕,为什么不保证学得好
激活函数让网络有机会表达更复杂的关系,但“存在一组参数能做到”和“训练能找到那组参数”,是两件事。刚才我们知道异或答案,才精确摆好了折点;真实任务只能通过样本和损失函数不断调整参数,过程未必顺利。
ReLU 也不是免费获得能力。一个单元如果在训练样本上长期落在负半轴,它的输出总是零;标准 ReLU 在这段的导数也是零,从这条路径传回的梯度就可能无法推动它恢复。这是理解所谓“死亡 ReLU”的入口,但不能据此说每个暂时输出零的单元都坏了。对某些输入关闭,原本就是它的工作方式。
sigmoid 又是另一种形状。它是平滑的 S 曲线,适合需要把数压进零到一之间的地方;但在两端饱和区,输入变化很多,输出变化很少,对应导数也小。选择激活函数不只是挑一个好看的曲线,还会影响训练时误差信号怎样传回去。
这里还有一个容易误会的补救办法:隐藏层都只做乘加,在最后加一个 sigmoid,是否就什么都能学了?对于刚才的二分类问题,答案仍是否定的。sigmoid 单调递增,把输出和固定阈值比较,等价于把前面的仿射分数和另一个固定阈值比较,边界依然是直线。它能改变分数的刻度,没有给中间表示加上所需的折痕。
反过来,最后一层没有激活函数,也不必然是漏写。若要预测一个可以取任意实数的数值,输出端直接保留线性结果很常见;前面的隐藏层已经完成了非线性加工。判断一个网络有没有非线性,要沿着完整计算看,不能只盯着最后一行的名字。
我再看那些密密麻麻的网络图时,会先问两个问题:哪些数字是学出来后固定的参数,哪些是随输入变化的读数;又是哪个操作,让原本能合并的乘加开始不能合并。层数告诉我计算走了多远,第二个问题才告诉我,它为什么可能走出一条不同的路。
评论