两张显卡,不会自动变成一张大显卡
模型一张卡装不下,再加一张就行吗?用拆账本和接力的例子,讲清张量并行、流水线并行与多副本的区别,以及为什么显存总量够、GPU 数量多,都不等于模型一定跑得快。
看到一个模型装不进显存,我很自然会想:那就再加一张卡。两张卡的显存加起来够,总能放下吧?
容量这笔账没算错,但中间省略了一件事:谁来把模型拆开,又让拆开的部分一起算?
两张显卡各有自己的显存。即使硬件之间有高速连接,推理程序也需要明确的分工,才能把一个模型放到多张卡上。否则它仍可能只往一张卡里装,另一张在旁边闲着。
我觉得理解多卡推理,先不用记一堆缩写。只要分清:是把同一层拆开算,把不同层分开算,还是每张卡各跑一份完整模型。
先算容量,但别只算权重
设一个便于心算的例子:某个稠密模型有 300 亿个参数,每个参数用两个字节保存,权重本身大约需要 600 亿字节,也就是十进制的 60 GB。
这不是某个模型的实测部署要求,只是一笔简化账。
如果手头有两张标称 48 GB 的卡,单张装不下这份权重,两张合起来看似绰绰有余。但实际运行还要给 KV cache、临时计算结果、通信缓冲等留位置;显示工具使用的容量单位也可能不同。把 60 除以 2 得到 30,并不意味着每张卡最终只占 30 GB。
更要紧的是,60 GB 不是一袋可以随意倒进两个桶里的沙子。里面是模型各层的矩阵,计算有先后,也有维度上的要求。怎么拆,决定了之后每一步要怎样交换数据。
TP:同一层,几张卡一起算
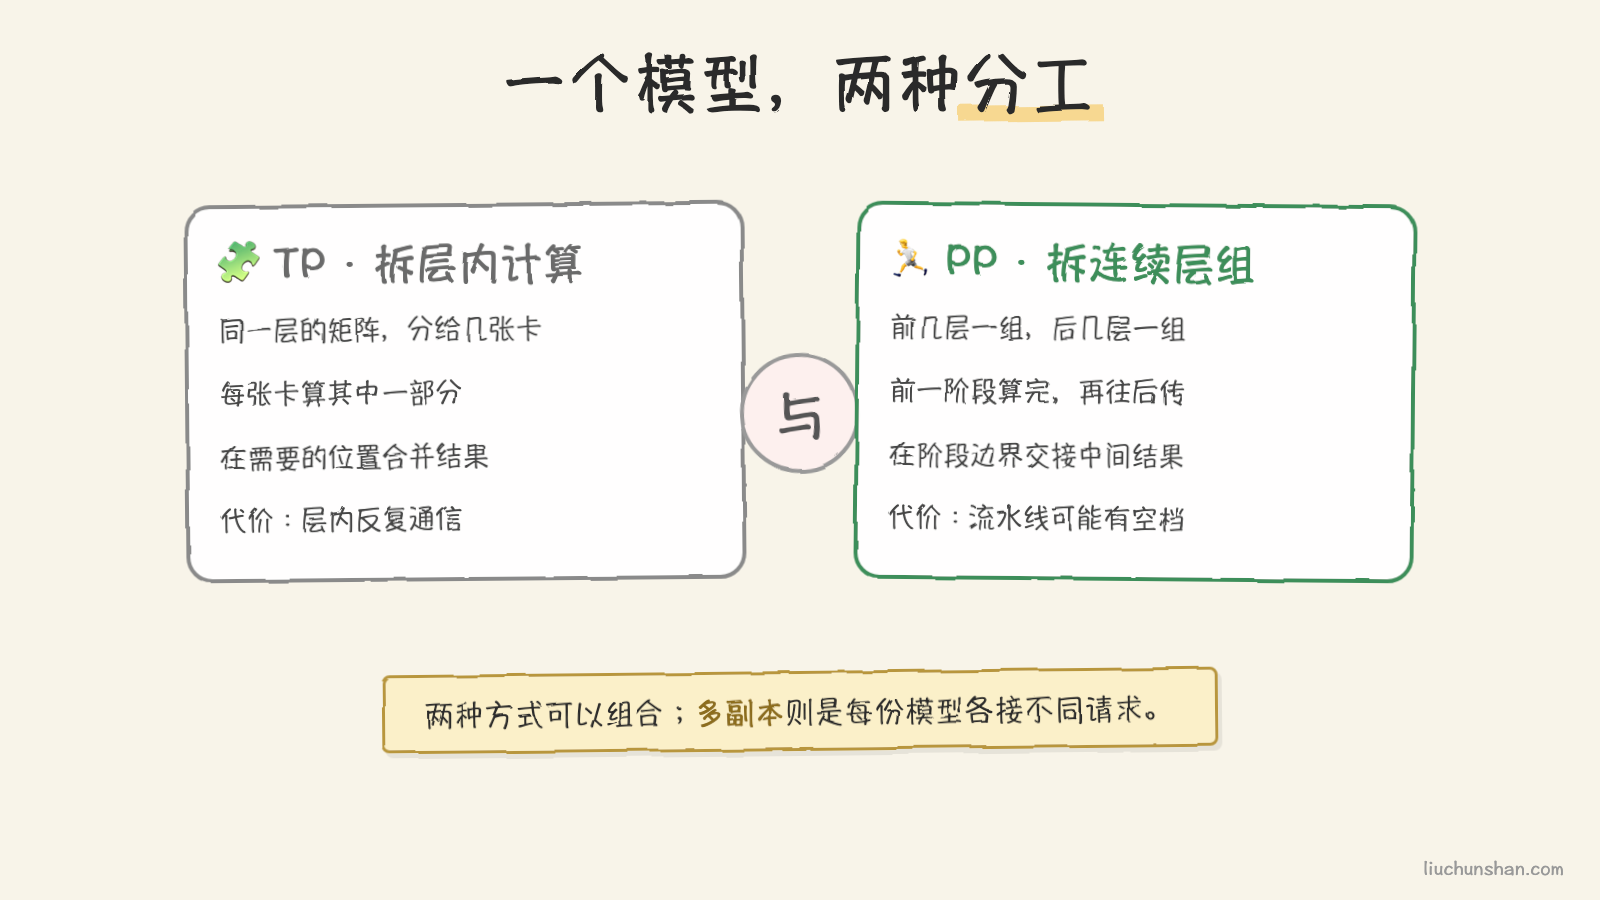
张量并行,英文是 Tensor Parallelism,常缩写成 TP。这里的“张量”,可以先把它理解为模型计算中的多维数字表。
假设有一张很宽的权重表。输入要和它做矩阵乘法,得到一排结果。我们可以把表按列切开:第一张卡算左半边输出,第二张卡算右半边输出。两张卡做的是同一层里的不同部分。
另一种切法是按行拆。每张卡算出一份部分结果,之后需要把它们相加,才得到完整结果。真实模型会把这些切法配合起来,尽量让相邻计算直接消费本地结果,减少不必要的搬运。
这就是为什么 TP 既能分摊权重,也能分摊一部分计算,却不能免掉通信。NVIDIA 的 Megatron-LM 原理介绍 展示了这种行列搭配,以及在特定位置合并结果的做法。
可以把它想成两个人核对同一本账:每人负责一部分,但到了需要总数的地方,必须对一下账,才能往下走。
这种合作会在模型的很多层反复发生。卡算得很快、彼此传数据却很慢时,节省下来的计算时间就可能被等待吃掉。因此,“有几张卡”之外,还得问“这些卡之间怎么连”。
PP:你算前几层,我接着算后几层
流水线并行,Pipeline Parallelism,简称 PP,切的是另一个方向。
假设一个示意模型有 40 层。第一张卡负责前 20 层,第二张卡负责后 20 层。输入先过前半段,得到中间结果,再交给后半段。这里的 20 加 20 只是教学划分,实际还要看每层的计算量、显存占用,以及输入输出层等额外负担。
它像接力:每一段只保管自己负责的那部分模型,在阶段交界处把中间结果传下去。相比 TP 在层内协作,它改变了通信发生的位置和频率。
不过,接力有一个容易被“并行”二字掩盖的问题:后半段不能凭空先跑。
如果只有一份工作,前半段在忙时,后半段可能在等;轮到后半段,前半段又可能空下来。这些空档通常被叫作流水线气泡。
让多份工作交错进入,可以填掉一部分空档:第二张卡处理第一份工作时,第一张卡开始处理第二份。训练中的 GPipe 就利用了把批次拆小、交错推进的思路。但训练论文里的加速效果,不能直接当成聊天推理的承诺。
聊天还有自回归依赖:对同一个请求,后一个 token 通常要等前一个生成出来。把模型切成两段,不会让这段依赖自动消失。在线服务能填多少空档,还取决于请求量、批处理和推理引擎的调度。
两张卡各放一份,是另一件事
现在换个条件:模型已经能完整装进一张卡,只是同时来的人太多。
这时可以让两张卡各跑一个完整副本,把不同请求分给不同副本。在普通稠密模型的推理场景里,这是理解数据并行的一种直观方式。
像开了两个独立柜台,而不是两个人共同处理一位顾客。同一份请求仍由其中一个副本完成。
因此,多副本主要解决的是同时接待多少请求。它不能帮助一张卡装下原本装不下的模型,也不保证单个请求的出字速度翻倍。原来排队很长时,多开柜台可能缩短等待;没有排队时,效果就不同。
这三个问题最好分开问:模型能不能装下?一个人等多久?很多人同时来能接住多少?同样叫“加卡”,答案可能完全不同。
八张卡,也未必八张一起做 TP
TP 和 PP 可以组合。比如两台机器、每台四张卡,可以在每台内部用四卡 TP,再让两台分别承担一个流水线阶段。这样一个模型副本总共用八张卡。
这个例子想表达的是:把需要频繁协作的部分安排在连接更快的一组卡里,把阶段之间的交接放到另一层连接上。
vLLM 的并行部署文档 给出了类似的组合思路,也提醒没有 NVLink 的机器可以考虑 PP。它不是通用最优解:网络、模型结构、引擎支持情况和实际请求负载,都会改变结果。
也别把容器当成硬件分界。一个容器可以看到多张卡,多个容器也可以参与同一个分布式任务。容器里放了几个进程,与 GPU 之间有没有快速通道,是相关但不同的事情。把容器数调成二,不会自动得到两卡模型并行。
我会先确认这四件事
如果只是想把模型跑起来,我会先核对完整显存预算和模型支持的切分方式。不是所有模型、所有卡数、所有引擎版本,都能任意组合;矩阵维度、注意力结构和实现限制需要一起看。
如果希望更快,我会把“快”说具体:是更快看到第一个字,后续出字更快,还是一秒服务更多请求?测试时固定输入长度、输出长度和并发量,否则几组漂亮数字可能比较的根本不是同一件事。
然后看通信:同机不代表一定有高速互联,跨机也不代表一定很慢。要查真实连接方式,不能只看机器和卡的数量。
最后才决定用多少卡、如何组合。如果小模型本来一张卡就够,强行切到更多卡,新增的通信和调度开销反而可能让它变慢。
我现在看到“八卡运行”这样的描述,会多追问一句:八张卡各自在干什么?这个问题回答清楚了,显存够不够、速度为什么上不去,才有了可以继续分析的起点。
评论