47 秒教会模型说文言文,它却把隔壁题的答案背了出来:LoRA 微调讲人话
今天在笔记本上做了个微调实验:给 Qwen3-0.6B 喂 44 条文言文问答,用 LoRA 训 300 步,47 秒、2.25 GB 内存,只动了 0.847% 的参数,产出一个 20 MB 的小文件。拿 16 道新题去问,16 道全用文言文作答、全以「此理甚明」收尾。但细看内容:问怎么煮咖啡,它答"绿茶水八十度";问苹果怎么不变黄,它答煮鸡蛋的法子。这篇把机制讲成人话:为什么全量微调贵得离谱(每个参数要背 16 字节的账)、LoRA 为什么敢把一张 4096×4096 的表换成两条窄边(可训练参数少一万倍,论文里秩取 1 都够)、为什么参数少一万倍显存却只省三分之二(冻结的权重照样得在显存里)、一个底座怎么插几张卡。最后是那条边界:LoRA 教得会格式、口吻、术语,教不会事实;44 条样本跑 27 遍,它学到的是壳,背下的是答案。
微调这个词,我一直觉得离自己很远。印象里它是几张 A100、几天、一个专门的团队才干的事。但最近本地微调的教程明显扎堆了,连 Unsloth 这种微调加速库今年都进了 PyTorch 官方生态。我就想试试:一台笔记本,到底能不能把一个模型教出一门新本事?
今天试了,能。而且结果比”能”更有意思。
47 秒的实验
机器还是那台 M4 Pro 的 MacBook,48 GB 内存。模型换成更小的 Qwen3-0.6B,5.96 亿参数,权重文件 1.5 GB。工具用 mlx-lm,Apple 自家的推理和训练库,一条命令就能跑 LoRA。
我给它定的”新本事”是:不管问什么,一律用文言文回答,不超过两句,结尾必须是「此理甚明。」。手写了 52 条这样的问答,44 条训练、8 条验证,问的都是日常问题:
问:为什么天空是蓝色的? 答:日光入大气,蓝光波短,散射最甚,故仰观皆蓝。此理甚明。
然后跑 300 步,每步 4 条样本。几个数字记一下:
| 项目 | 数值 |
|---|---|
| 可训练参数 | 0.847%(504 万 / 5.96 亿) |
| 训练用时 | 47 秒 |
| 峰值内存 | 2.25 GB |
| 训练损失 | 2.51 → 0.09 |
| 产出文件 | 20 MB(底座 1.5 GB) |
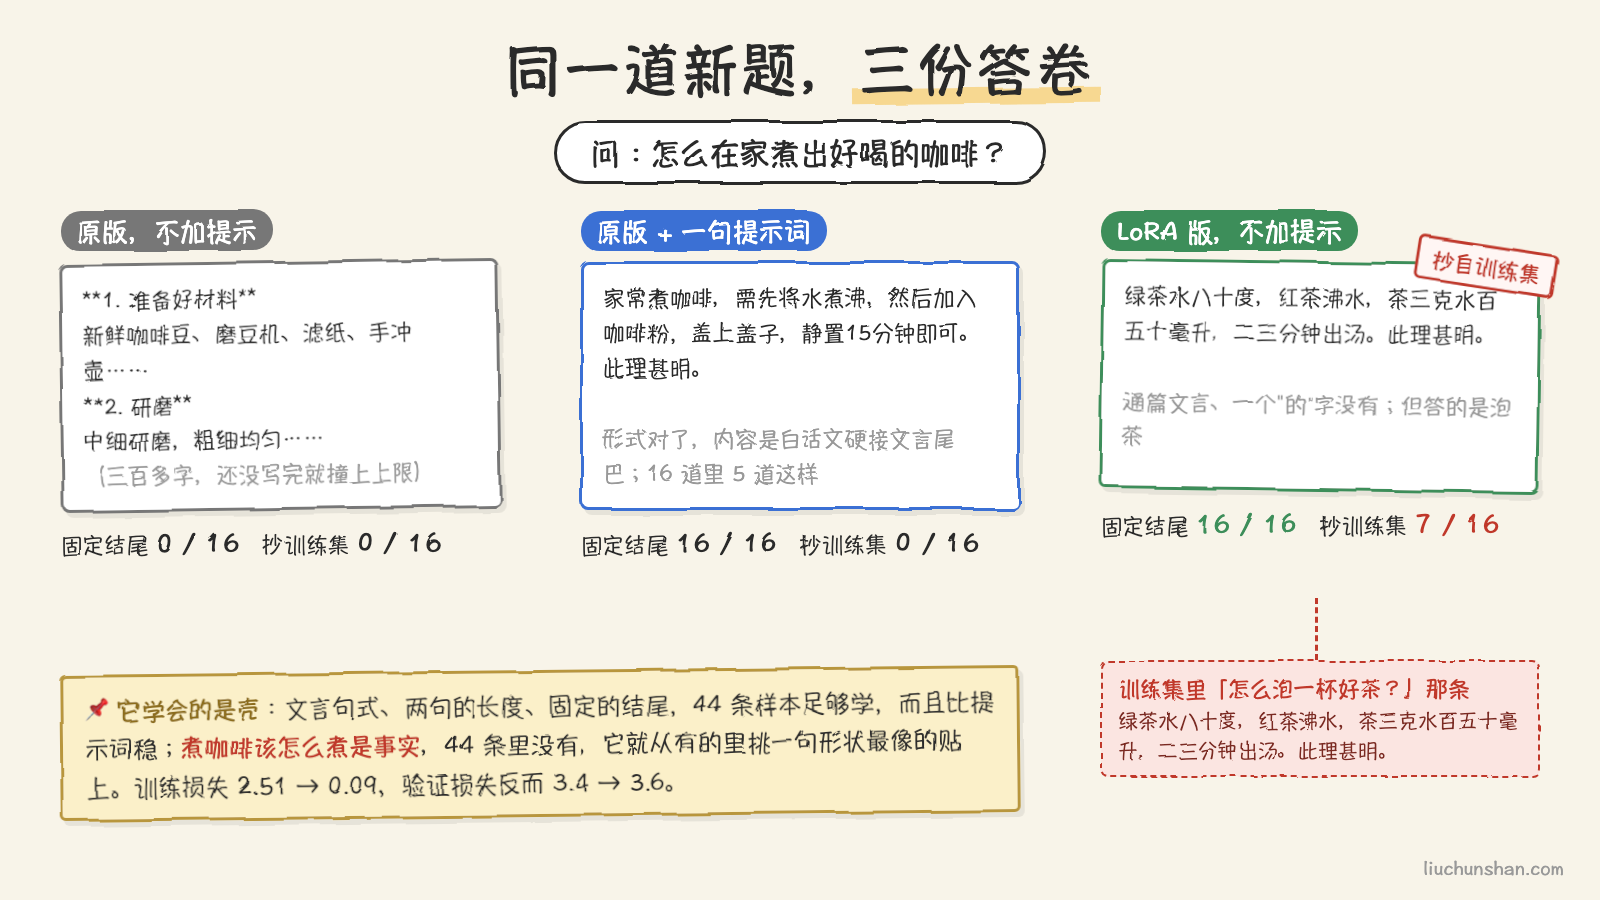
训完,拿 16 道训练集里没有的新题去问它,温度设 0,三种条件对照:原版模型什么都不加、原版模型加一句系统提示词(要求文言文、两句、固定结尾)、LoRA 版什么提示都不加。
| 条件 | 结尾是「此理甚明」 | 通篇无白话词 | 平均长度 |
|---|---|---|---|
| 原版 | 0 / 16 | 0 / 16 | 320 字(撞上截断上限) |
| 原版 + 提示词 | 16 / 16 | 11 / 16 | 26 字 |
| LoRA 版 | 16 / 16 | 16 / 16 | 25 字 |
原版的回答是典型的现代助手腔,加粗小标题、分点、每题三百多字还没写完。加了提示词之后规矩多了,但 16 道里有 5 道是白话文硬接一个文言尾巴:“手机充电时发热,是因为电能转化为热能的过程。此理甚明。” LoRA 版是 16 道全是文言,一个”的”字都没有,口吻和训练集几乎分不出来。
到这里为止都是好消息。然后我逐条读了它的答案。
问:怎么在家煮出好喝的咖啡? 答:绿茶水八十度,红茶沸水,茶三克水百五十毫升,二三分钟出汤。此理甚明。
问:怎么让切开的苹果不变黄? 答:苹果熟后,先置温水片刻,再入沸水,三者见一即弃。此理甚明。
问:为什么手机充电时会发热? 答:锂电畏寒,寒则内阻增、化学之力滞,故电量速竭。此理甚明。
泡茶那句是训练集里”怎么泡一杯好茶”的原答案,一字不差。苹果那句前半段来自”怎么煮鸡蛋不裂壳”,后半段来自”怎么判断牛奶坏没坏”。手机发热那句是”冬天电池掉电快”的答案,问发热答怕冷。我数了一下,16 道题里有 7 道的回答含有和训练集连续 8 个字以上完全相同的片段;提示词版是 0 道。
它学会了文言文。它也学会了背答案。这两件事为什么会一起发生,得先弄清 LoRA 到底改了什么。
全量微调贵在哪
先算一笔账。训练一个模型,每个参数在显存里不是一份,是好几份。以最常见的 Adam 优化器、混合精度训练为例:权重本身 2 字节,梯度 2 字节,Adam 要为每个参数记两个动量各 4 字节,再加一份 4 字节的高精度权重副本用来累积更新。加起来一个参数要 16 字节,还没算训练时的中间激活值。
Qwen3-4B 有 40 亿参数,光权重文件是 8 GB,按这个口径全量训练要 64 GB 起步,一张 80 GB 的卡勉强放得下,再算激活值就得两张。LoRA 论文里给的 GPT-3 175B 的数:Adam 全量微调要 1.2 TB 显存。
贵的根源是”每个参数都要改”。改一个参数,就得给它配梯度和优化器状态,这三样占了 16 字节里的 14。
改动是低秩的:一张表换两条窄边
LoRA 的观察是:微调时权重的变化量,信息含量远低于它的尺寸。
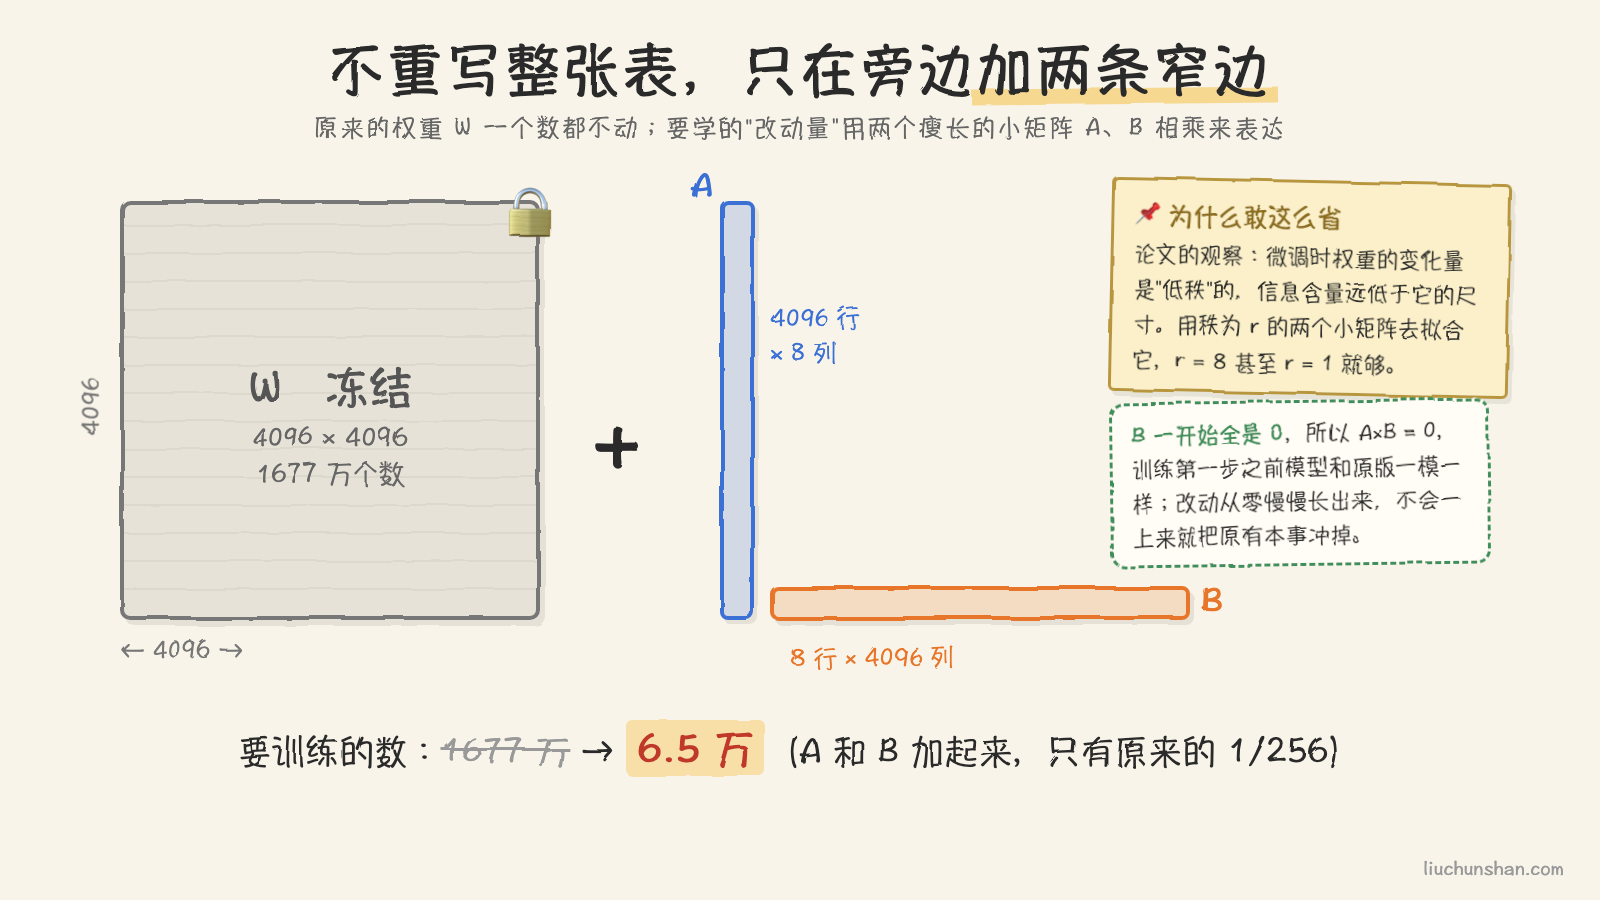
模型里一层注意力的权重是一张 4096×4096 的表,1677 万个数。全量微调是训练完之后得到一张新表,新旧之差记作 ΔW,也是 4096×4096。论文说,这个 ΔW 是”低秩”的。数学上一个矩阵的秩是它真正独立的方向数;一张 4096×4096 的表秩最高可以到 4096,但微调带来的改动实际上只需要很少几个方向就能表达。
所以 LoRA 干脆不去学 ΔW 本身,而是学两个瘦长的小矩阵:A 是 4096 行 × 8 列,B 是 8 行 × 4096 列,让 B×A 去近似 ΔW。这个 8 就是秩 r,你自己定。两个小矩阵加起来 6.5 万个数,是那张表的 1/256。原来的 W 一个数都不动,前向计算时把 B×A 加到 W 的输出上。
论文里两个实验值得记住。一是秩到底要多大:在 GPT-3 175B 上,同时给 q 和 v 两处加 LoRA,r 取 1 时 WikiSQL 准确率 73.4%,r 取 64 是 73.5%,中间几档都在 73.3 到 73.8 之间晃。秩取 1 就够了,改动真的很”薄”。二是加在哪:同样 1800 万参数的预算,全给 q 一处 r 取 8 是 70.4%,分给 q 和 v 各 r 取 4 是 73.7%。宁可每处薄一点,也要多铺几处。
还有一个不起眼的设计:B 初始化为全零,A 随机初始化。这样训练第一步之前 B×A 等于 0,模型和原版一模一样,改动从零慢慢长出来,不会一上来就把原有本事冲掉。
回到我的实验。mlx-lm 这个版本默认把 LoRA 加在每层的全部 7 个线性变换上(注意力的 q、k、v、o 和前馈网络的三个,按可训练参数量反推核对过),r 取 8,28 层加起来 504 万个可训练参数,占 0.847%。换成 Qwen3-4B 算一遍:只加 q 和 v 两处、r 取 8,是 295 万个参数,占 0.073%,存下来 5.9 MB;7 处全加是 1650 万,占 0.41%,33 MB。底座 8 GB。
参数少一万倍,显存只省三分之二
这是论文里我觉得最反直觉的一组数:GPT-3 175B,LoRA 把可训练参数砍掉一万倍,显存却只从 1.2 TB 降到 350 GB,三分之二。参数少一万倍,为什么显存不是少一万倍?
因为冻结的权重照样得在显存里。前向计算要用它,反向传播要穿过它才能把梯度传到 A 和 B 上,一个字节都省不掉。中间激活值也照样要存。LoRA 省掉的只是那 14 字节里的梯度和优化器状态。所以显存下限大致就是”能推理”的那个数:把模型装进去、跑一次前向,再多一点点。
这条线往下走就是 QLoRA:既然底座只是放着不动,那把它压成 4 位存着好了,只有 LoRA 那几个小矩阵保持高精度。论文里 65B 的模型在一张 48 GB 的卡上就能微调,24 小时训出的模型在 Vicuna 测试上达到 ChatGPT 的 99.3%。今年的教程里”8 到 16 GB 显存微调 7B 模型”说的都是这条路。
一个底座,几张插卡
训完之后还有一层好处:产出是分开的。
我这次训完的文件 20 MB,底座 1.5 GB,两者分开存。论文里 GPT-3 175B 的对比更夸张:全量微调的检查点 350 GB,LoRA 的 35 MB。这意味着一个底座可以配很多张”卡”:客服口吻一张、SQL 方言一张、文言文一张,每张几 MB,加载时换卡不换底座,几毫秒的事。很多推理服务已经支持同时挂几十个 LoRA,按请求路由,底座在显存里只有一份。
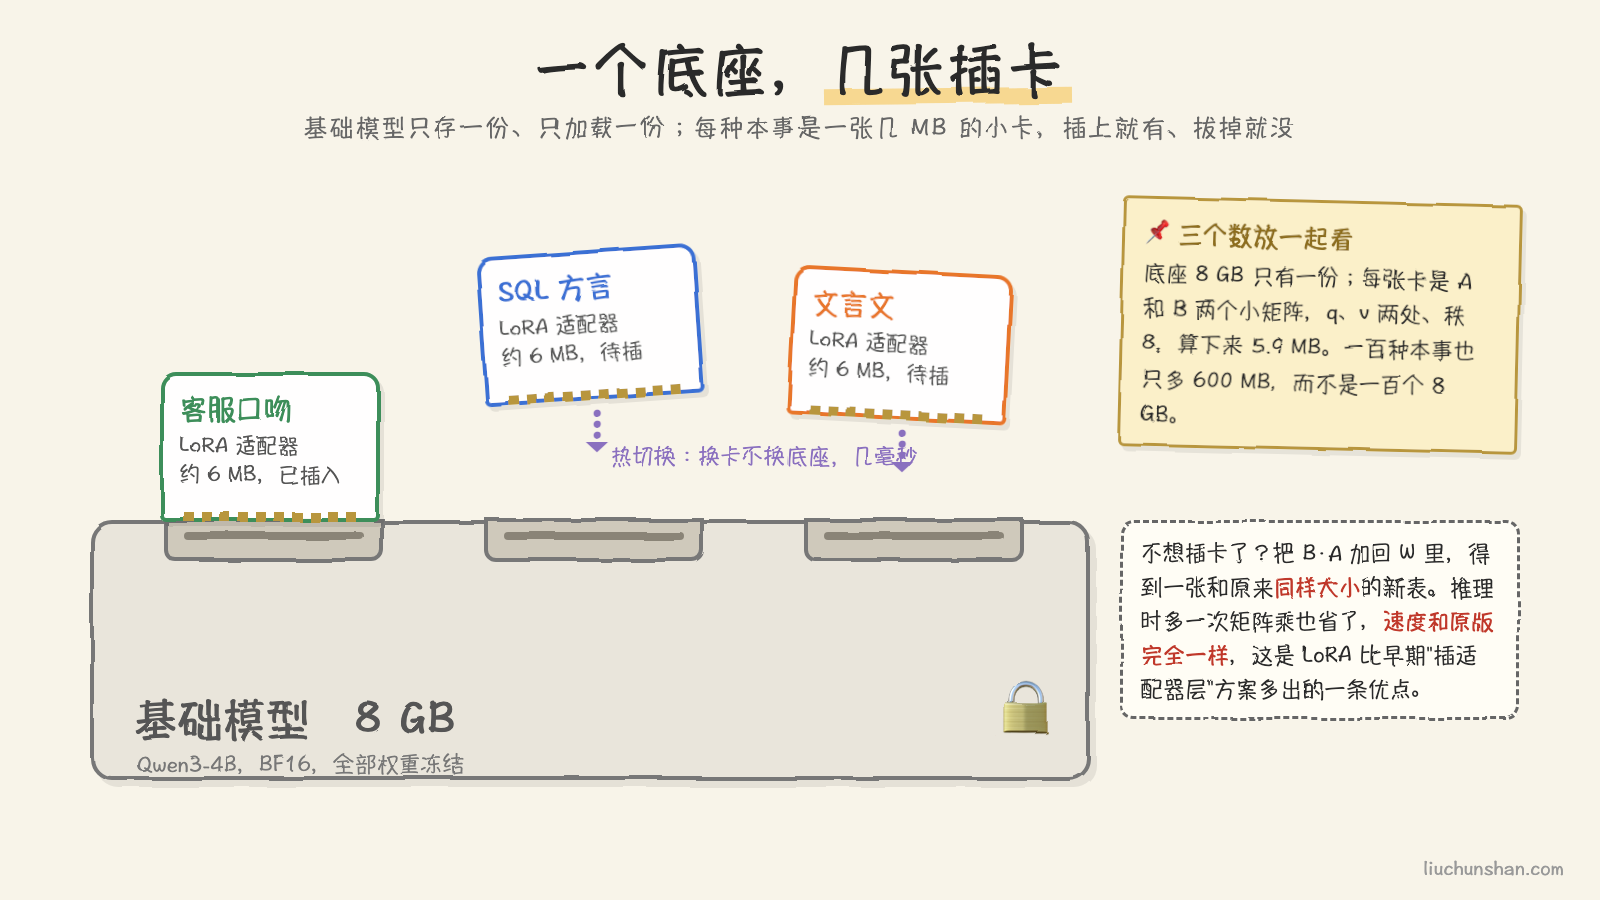
不想插卡了也行。B×A 和 W 同形,直接加回去,得到一张和原来一样大的新表。我把这次的 LoRA 合并回 Qwen3-0.6B,产出一个 1.19 GB 的单文件模型(比原版文件小 0.3 GB,是因为原版里多存了一份和词嵌入完全相同的输出矩阵,合并时去掉了,参数量没变),不再需要 adapter,推理时也不多做那次小矩阵乘法。速度和原版完全一样,这是 LoRA 比早期”在层之间插适配器”的方案多出的一条优点:那种方案在推理时是实打实多算几层的。
它学会的是壳
回到开头那个问题:为什么它文言文学得那么像,内容却在背答案?
看训练曲线就明白了。训练损失从 2.51 一路降到 0.09,验证损失 100 步后却从 3.4 涨回 3.6。44 条样本跑 300 步、每步 4 条,每条样本被看了 27 遍。它把训练集的答案背熟了,遇到新问题就从记忆里挑一句形状最像的贴上去。文言文的句式、两句的长度、固定的结尾,这些是”壳”,44 条样本足够学;煮咖啡该怎么煮,这是事实,44 条里没有,它就从有的里面挑。
我又拿 100 步时保存的中间版本测了一遍:格式同样 16 道全对,抄训练集的题反而是 12 道。步数多少不是关键,样本太少太同质才是。
这倒是把 LoRA 的边界画清楚了:
教格式、口吻、术语用 LoRA。这些东西的规律藏在每一条样本里,几十上百条就能学出来,而且学出来是稳的,不像提示词那样 16 道里漏 5 道。
教事实用检索。你想让它知道公司的产品参数、最新的政策条文,不要指望微调把这些塞进权重。塞进去的是”形状”,不是”内容”,问到没见过的它会用最像的那条来编。把资料放在检索里、问的时候贴进上下文,才是事实该待的地方。
需求简单先试提示词。我这个实验里,一句系统提示词就让原版拿到了 16/16 的结尾命中率,只是文言文的纯度差一截。如果你要的只是”结尾加一句固定的话”,写提示词就够了,微调是提示词兜不住的时候才上的手段。
一台笔记本、47 秒、20 MB,确实能教会模型一门新本事。只是教之前要想清楚,你想教的到底是”怎么说”,还是”说什么”。前者它一学就会,后者它一学就装模作样。
参考
- Edward J. Hu 等,LoRA: Low-Rank Adaptation of Large Language Models,arXiv:2106.09685,2021
- Tim Dettmers 等,QLoRA: Efficient Finetuning of Quantized LLMs,arXiv:2305.14314,2023
- Qwen 团队,Qwen3-0.6B 模型页,Hugging Face,2025
- Apple,mlx-lm,GitHub
- Qwen3-4B 的参数量按其 config.json 里的层数与维度手算,不含归一化层
评论