JSON 一个字都没写错,算术却从 92 分掉到 35 分:约束解码讲人话
今天在自己电脑上做了个小实验:让 Qwen3-4B 从一句话里抽三个字段输出 JSON,跑 20 次,20 次都先写了一行 ```json 围栏,直接喂给解析器 0 次能过;给它挂上 JSON schema 约束再跑 20 次,20 次都以 { 开头、全部能解析。翻开它对第一个字的打分才发现:模型 99.15% 想写 ```,{" 只有 0.83%,约束解码没让模型变乖,只是把那 99% 划掉了。这篇把机制讲成人话:每生成一个字,先照常给十五万个候选打分,再按语法把此刻不合法的清零,从剩下的里抽;所以格式是 100% 合法而不是大概率。然后讲代价:同一个模型做 60 道小学算术题,自由作答 91.7% 正确,schema 只留一个 answer 字段就掉到 35%,把 reasoning 字段放到 answer 前面又回到 91.7%;一篇论文里 Claude 3 Haiku 在同样的坑里从 86.5 掉到 23.4。闸门只会删,不会加,推理要么留在 JSON 外面、要么排在答案前面。
月初写 tool calling 那篇 的时候说过一句,模型”调工具”其实只是写了一段 JSON。当时有个问题没展开:模型写的 JSON 凭什么一定合法?它是个概率模型,逗号漏一个、引号多一个,都是正常发挥。提示词里写”请务必只输出 JSON、不要任何多余文字”,大家都写过,也都被坑过。
今天在自己电脑上把这件事拆开看了一遍,结果比我预想的更能说明问题。
20 次里 20 次先写围栏
机器还是 M4 Pro 的 MacBook,模型还是昨天那个 Qwen3-4B 的 Q4 版本,用 llama.cpp 起了个本地服务,关掉思考模式。题目很简单:
从下面这句话里抽取 name、city、age 三个字段,输出 JSON。句子:老王上个月刚过完 52 岁生日,现在在成都开了家面馆。
温度 0.7,跑 20 次。20 次它都答对了,三个字段一个不差。但 20 次它都是这么写的:
```json
{
  "name": "老王",
  "city": "成都",
  "age": 52
}
```
前后各一行 Markdown 围栏。对人来说这是贴心,对程序来说这是垃圾:把这段直接交给 JSON 解析器,20 次里 0 次能过。你可以在代码里把围栏剥掉,但明天它可能换成”好的,以下是提取结果:“开头,后天可能在末尾加一句”如需其他格式请告诉我”。每一种都要再写一个补丁。
然后我给这个请求加了一个 JSON schema(一份描述”合法输出长什么样”的规则:对象、三个键、age 必须是整数、不许有别的键)。llama.cpp 会把它编译成一份语法,生成的时候按语法约束。再跑 20 次,20 次都直接以 { 开头、以 } 结束,全部能解析。
不是 19 次,不是”基本都行”,是 20 次。这个”必然”是从哪来的,得看模型写第一个字的时候在想什么。
第一个字:它 99% 想写 ```
llama.cpp 可以把每一步的候选和概率吐出来。不加约束的时候,模型对第一个字的打分是这样的(只列前几名):
| 候选 | 概率 |
|---|---|
``` | 99.15% |
{" | 0.83% |
{\n | 0.014% |
"{ | 0.00002% |
" | 0.000005% |
它想写围栏的意愿是压倒性的,99.15%。提示词里”输出 JSON”它听懂了,围栏是它的习惯,而且几乎是本能。
加了 schema 之后再看同一步:模型的打分一模一样,``` 还是 99.15%。但实际写下的第一个字是 {",那个原本只有 0.83% 机会的候选。
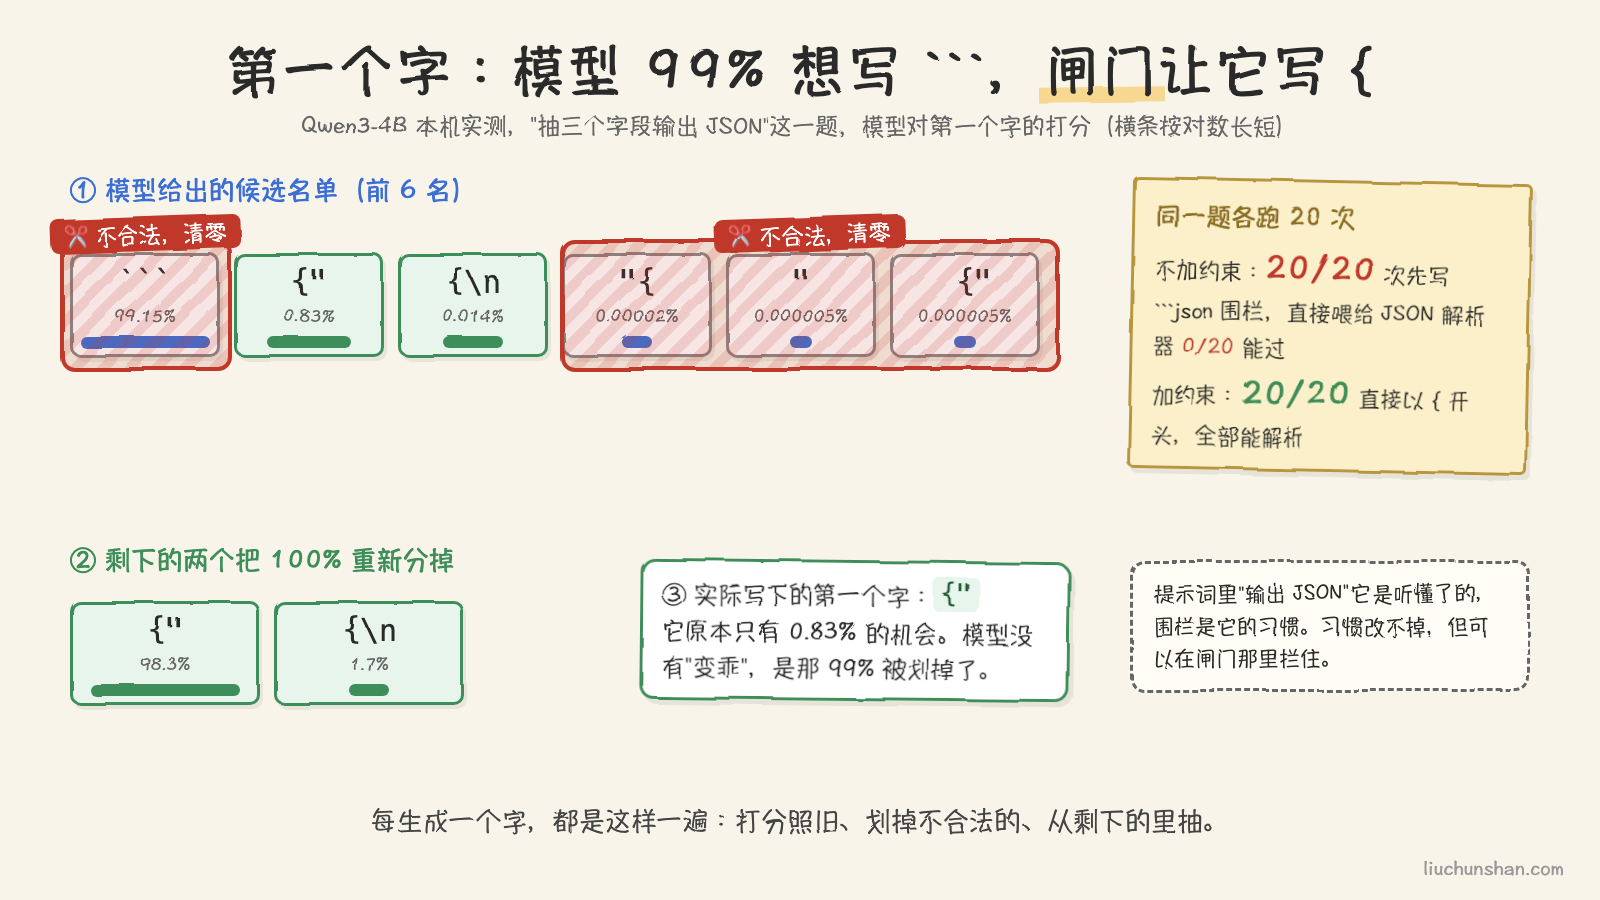
这就是约束解码(constrained decoding)全部的秘密:它不改模型的打分,它改的是名单。语法说此刻只能是一个 JSON 对象的开头,那么所有不以 { 开头的候选,概率直接清零。``` 没了,“好的”没了,“以下是”没了。剩下 {" 和 {\n 两个,把 100% 重新分掉,98.3% 对 1.7%,再照常抽签。
模型没有”变乖”。它心里想写的还是围栏,只是那个选项从来没有机会被抽中。
每一个字,过一道闸
把这件事放回大模型生成文本的过程里看。前面几篇讲过,模型是一个字一个字往外吐的,每吐一个字都要做一次完整的打分:词表里的每个候选(Qwen3 的词表有 151,936 个)各给一个概率,然后从里面抽一个。约束解码在”打分”和”抽签”之间加了一道闸。
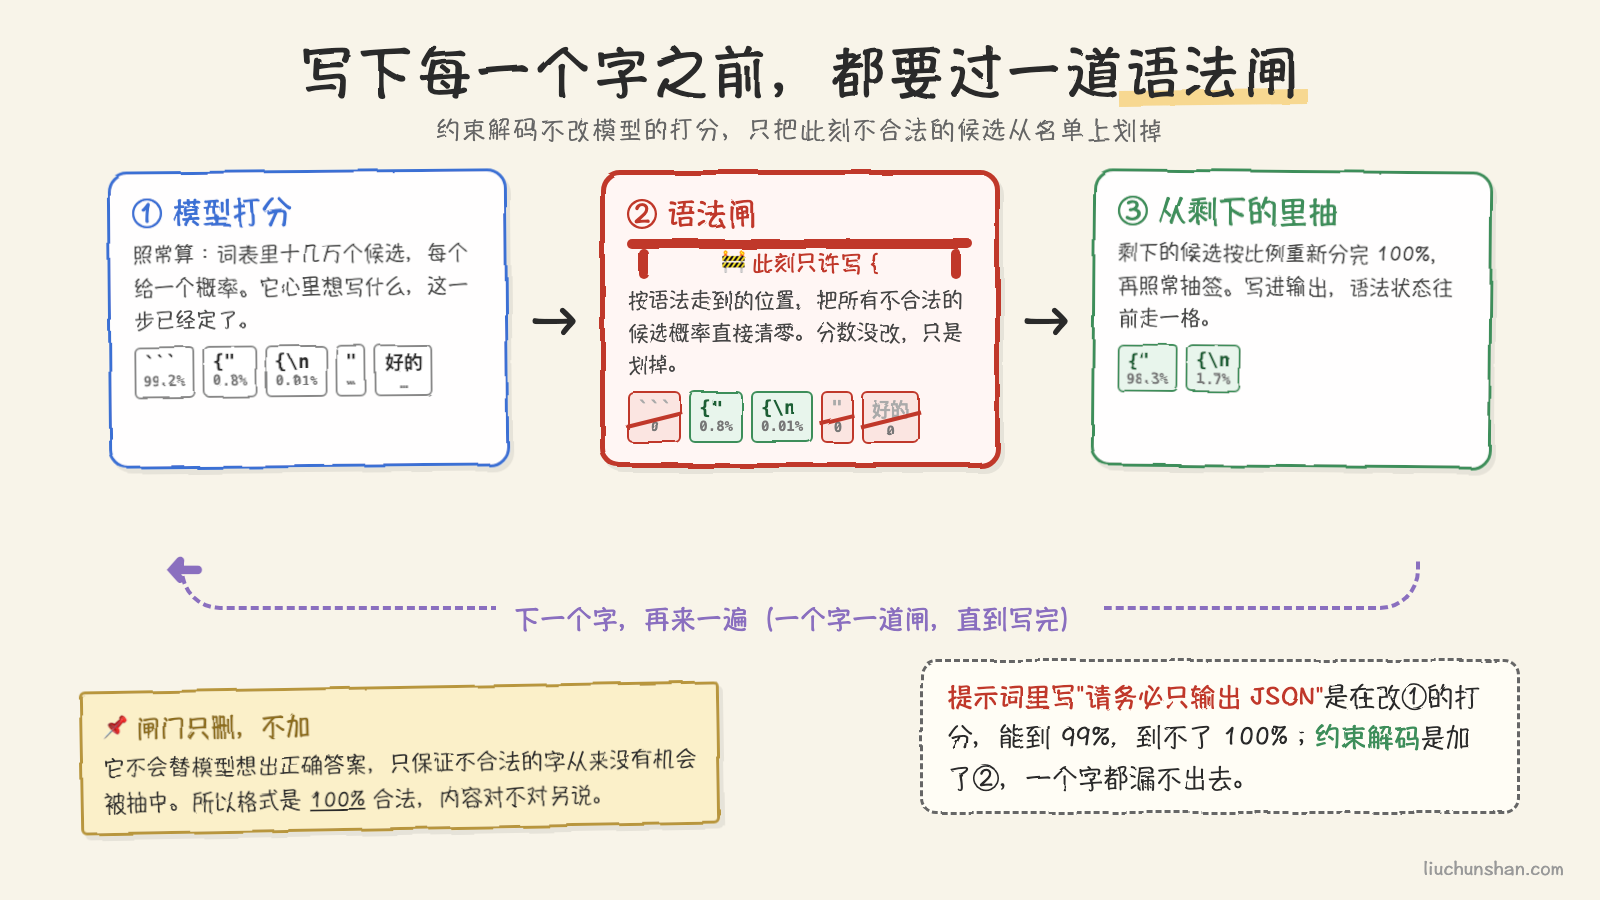
闸门的规则来自语法。JSON schema 先被翻译成一份形式语法(llama.cpp 用的是自家的 GBNF 格式,其他引擎用正则或有限状态机,思路一样),语法可以回答一个问题:已经写到这里了,下一个字允许是什么。把老王那道题从头走一遍:
| 已经写下的 | 语法此刻允许的 | 被划掉的典型候选 |
|---|---|---|
| (空) | { | ```、“好的”、“以下是” |
{"name": " | 任意字符串内容 | (几乎不划) |
{"name": "老王", | 空白或 "city" | "age"(顺序不对)、"phone"(不在 schema 里) |
… "age": | 数字 | "(age 不许是字符串)、五十二 |
… "age": 52} | 结束 | 换行、“如需其他格式请告诉我” |
注意第二行:写字符串内容的时候,闸门几乎什么都不管,老王叫什么、住哪,全凭模型自己。闸门管的是骨架,不是血肉。第三行也值得看一眼,schema 里三个键是必填的、不许有别的键,所以模型连”多热心地补一个电话字段”的机会都没有。
有个细节值得说一下:模型的”字”不是字符,是 token。上面那张表里赢的候选是 {",两个字符捆在一个 token 里。语法是按字符定义的,闸门要按 token 判断,所以它得逐个检查”这个 token 的这几个字符,从当前状态出发能不能一路走通”。十五万个候选,每生成一个字都要查一遍,这就是早期约束解码慢的原因。后来的做法是把大部分检查提前算好:Outlines 那篇论文的思路是把语法编成有限状态机,每个状态下哪些 token 合法预先算出一张表,生成时查表就行;XGrammar 更进一步,把词表分成”不看上下文就能判定合不合法”和”要看语法栈才知道”的两类,前者离线算好、后者运行时只查一小撮,论文说比之前的方案快最多 100 倍,接入推理引擎后几乎测不出开销。vLLM、SGLang 这些推理引擎现在默认挂的就是它。
OpenAI 的 Structured Outputs 也是这个机制。2024 年 8 月它发布的时候给了一组数:gpt-4o-2024-08-06 开 Structured Outputs,在复杂 schema 跟随测试上拿到 100%;gpt-4-0613 靠提示词,不到 40%。文档里还有一句很诚实的话:“用一个新 schema 发的第一个请求会多一点延迟,因为我们要处理这个 schema,之后相同 schema 的请求就不会了”。那点延迟就是在编语法、算那张表。
顺便把两个容易混的东西分开:OpenAI 早先的”JSON mode”只保证输出是合法 JSON,不保证符合你的 schema;Structured Outputs 才保证 schema。文档原话是”只有 Structured Outputs 保证 schema 一致”,并且建议能用后者就别用前者。
这也回答了开头那个问题。tool calling 那篇说模型”调工具”只是写一段 JSON 参数,OpenAI 在函数定义里加 strict: true,Claude 的接口也有同名的开关,背后就是把工具的参数 schema 编成语法挂到闸门上。工具名必须是注册过的那几个之一,参数类型必须对得上,缺一个必填参数就走不到结束符。所谓”工具调用可靠了”,很大程度上是这道闸门的功劳,不是模型突然学会了写 JSON。
为什么提示词到不了 100%
回头看”请务必只输出 JSON”这句话在做什么。它在改第一步的打分。写得好,能把 ``` 从 99% 压到 5%,把 { 抬到 95%。但 5% 就是 5%,跑一百次会有五次翻车,而且你不知道是哪五次。它是在劝模型,闸门是在拦模型。劝到 99% 是能力,拦到 100% 是结构。
这也是为什么”格式合法”这件事,我现在倾向于不再靠提示词。凡是有 schema 约束能力的地方(OpenAI、Claude 和 Gemini 的接口都有了,本地 vLLM 和 llama.cpp 也有),格式交给闸门,提示词省下来说正事。
但闸门只会删,不会加
到这里为止约束解码看起来只有好处。接着做的第二个实验让我收回一半。
同一个模型,我从 GSM8K(一套小学应用题,每题一个整数答案)里取了前 60 道,换几种方式让它答:
| 作答方式 | 正确率 | 平均输出长度 |
|---|---|---|
| 自由作答,最后写 Answer: 数字 | 55/60,91.7% | 216 token |
schema 只有 answer 一个字段 | 21/60,35.0% | 15 token |
| 同上,提示词里加”请一步一步思考” | 19/60,31.7% | 16 token |
schema 两个字段,reasoning 在前、answer 在后 | 51/60,85.0% | 143 token |
| 同上,提示词里加”请一步一步思考” | 55/60,91.7% | 143 token |
schema 两个字段,answer 在前、reasoning 在后 | 19/60,31.7% | 170 token |
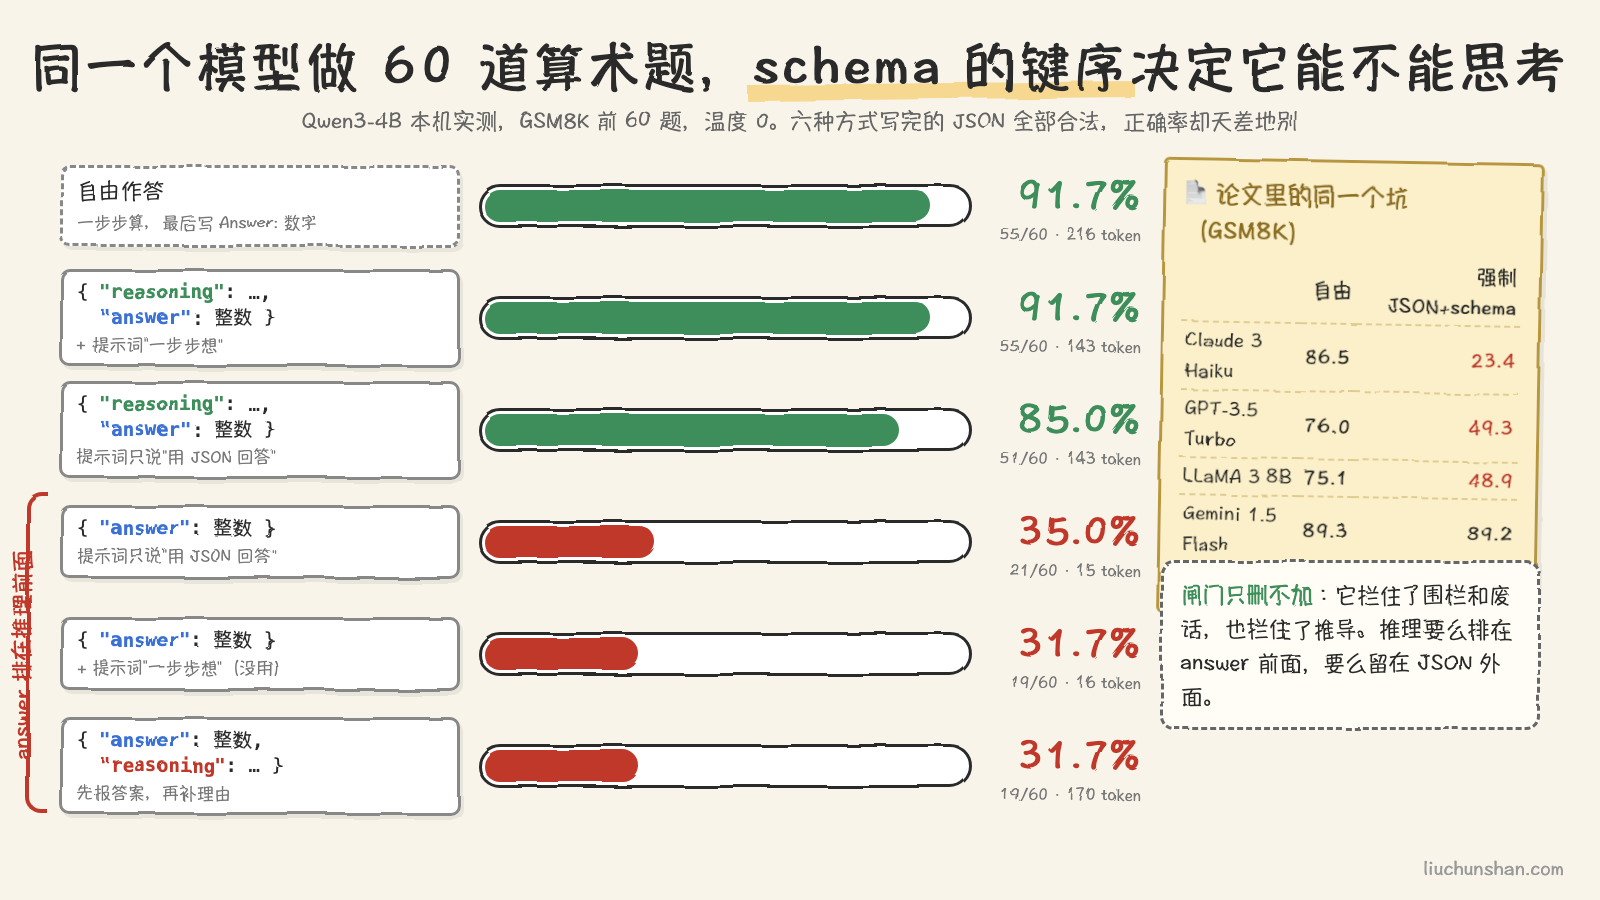
第一行是自由作答:让它一步一步算,最后一行写”Answer: 数字”,我用正则把数字抠出来。60 题对 55 题,91.7%。
第二行是把 schema 定成只有一个 answer 字段。格式当然是 100% 合法的,60 次全部解析成功。但正确率掉到 35%。它没有算错,它是没有算。闸门规定第一个字必须是 {,第二个字必须是 "answer",接下来必须是数字。模型被逼着在写下任何推导之前先报答案,而报答案这一步,它心里的概率分布是根据”一眼看上去像多少”给的。前面写 thinking 那篇说过,模型的推理是写在纸上的,纸被没收了,推理就没有了。
第三行是我在提示词里加回”请一步一步思考”,schema 不变。31.7%,比不加还低两分。这是最能说明问题的一组数:你怎么劝没有用,schema 决定了它能不能思考。它想一步一步算,可闸门在 {"answer": 后面只放行数字。
第四行把 schema 改成两个字段,reasoning 在前、answer 在后。85%,回来了。再叠上”一步一步思考”,91.7%,和自由作答一个水平,而且每次输出还比自由作答短三分之一(143 个 token 对 216 个),因为不用寒暄。
最后一行是我觉得最有意思的:两个字段都有,只是把 answer 放到 reasoning 前面。31.7%,和没有 reasoning 字段一样差,而且每次还多花了 150 多个 token 写理由。看几条原始输出就明白它在干什么。第一题,鸭子每天下 16 个蛋,吃 3 个、烤 4 个,剩下的每个 2 块钱卖掉,问一天卖多少钱。它写的是:
{
  "answer": 24,
  "reasoning": "……she uses 3 + 4 = 7 eggs. This leaves 16 - 7 = 9 eggs.
    She sells these 9 eggs at $2 each, so she makes 9 × 2 = $24 per day."
}
前面每一步都对,9 个蛋,2 块一个,到最后一步硬算出 9 乘 2 等于 24。因为 24 已经写在前面了,后面的”理由”是给这个答案找补的。第二题它先报 25,理由里老老实实算出 3,末尾加一句”所以总数是 3”,自己和自己打架。答案先落笔,推理就从”推导”变成了”辩护”。这和 thinking 那篇里”想了 30 秒又把对的改错”是一个家族的现象,只不过这次是 schema 逼的。
顺带一个小坑:六种方式里有 5 次输出被我设的 600 token 上限截断,JSON 没写完,自然也解析不了。闸门保证的是”写出来的每个字都合法”,不保证”写得完”。上限给足,或者检查一下结束原因,不然这种失败会被当成模型的锅。
论文里的同一个坑
这个现象有人系统地测过。2024 年那篇《Let Me Speak Freely?》拿 GSM8K 和另外几个推理任务测了四个模型,比较自由作答和各家接口的强制 JSON 模式加 schema 约束。GSM8K 上的数字:
| 模型 | 自由作答 | 强制 JSON + schema |
|---|---|---|
| Claude 3 Haiku | 86.5 | 23.4 |
| GPT-3.5 Turbo | 76.0 | 49.3 |
| LLaMA 3 8B | 75.1 | 48.9 |
| Gemini 1.5 Flash | 89.3 | 89.2 |
Claude 3 Haiku 掉了 63 分。论文没有逐个模型去查原因,但对 GPT-3.5 做过诊断,和我上面撞到的一样:在 Last Letter 那个任务上,它的 JSON 模式输出 100% 把 answer 键排在了 reason 键前面,于是所有题都变成了不带推导的直接作答。Haiku 那 63 分论文没单独拆,但从掉分幅度看,大概率是同一个坑。Gemini 那一行没怎么掉,说明这不是约束解码的必然,是”schema 有没有给推理留位置”的区别。
同一篇论文还有另一半结论,我觉得同样重要:在分类任务上(比如给一段文字定类别、给一组症状选诊断),强制 JSON 反而普遍更准,有的数据集提升明显。道理也简单:分类的答案空间本来就是有限的几个选项,闸门把候选限死在这几个里,等于顺手删掉了”模型答非所问”这一类错误。推理任务怕闸门,选择任务爱闸门。
论文最后还补测了 OpenAI 当时刚出的 Structured Outputs(也就是真正的 schema 约束解码,而不是早期的 JSON mode):gpt-4o-mini 在 GSM8K 上,自由作答 94.6,旧的 JSON mode 87.0,Structured Outputs 91.7。schema 设计得当,差距能收回大半,但没有全收回。
怎么用
我自己现在的用法归成三条。
推理放在答案前面,或者放在 JSON 外面。schema 里如果有 answer,前面一定有一个 reasoning(或者 steps)字段,键的顺序就是模型思考的顺序。OpenAI 文档里的链式思考示例也是 steps 在前、final_answer 在后,这不是巧合。更稳的做法是两段式:第一次请求让它自由写,第二次请求把它的自由文本转成 JSON,第二次开约束。多花一次调用,换来推理和格式各归各位。论文里管这叫 NL-to-Format,测下来和自由作答几乎一样准。第二次调用可以用便宜得多的小模型,因为”把一段已经写好的话抄成 JSON”不需要推理,只需要格式,而格式正好是闸门最擅长的。
推理模型(开了 thinking 的那种)是这条规则的天然解法:思考发生在 <think> 标签里,闸门只管标签外面的正文,推理和格式天生就分在两处。这也是为什么我做第二个实验时特意把思考模式关掉,不关的话六种方式会拉不开差距,看不到闸门本身的影响。
分类、抽取、路由这类任务,放心开约束。答案空间有限的,闸门只会帮忙。schema 里用 enum 把选项列死,模型连拼错类别名的机会都没有。
约束保证的是”合法”,不是”正确”。age 必须是整数,闸门能保证你拿到的是整数;老王到底多少岁,闸门管不着。schema 越细,语法就越紧,模型的表达空间就越小。要求 city 必须匹配一个正则、要求数组长度正好是 5,这些都做得到,但每加一条就是多没收一张纸,加之前想一下这一条是格式要求还是内容要求。格式要求交给闸门,内容要求留给模型。
一个具体的例子:让模型从一封邮件里抽”发件人意图”,schema 里把意图定成 enum,只许是”询价、投诉、退货、其他”四个之一。这是好约束,答案空间本来就这么大。但如果再加一条”置信度必须是 0 到 1 之间保留两位小数的数字”,闸门能保证你拿到 0.87 这样的数,却保证不了这个数有任何意义,模型从来没有真的”算”过置信度,它只是在被允许的数字里挑了一个看起来顺眼的。前者是用闸门删掉不可能的答案,后者是用闸门逼模型编一个数,长得一样,性质完全不同。
带走的一个判断
我从这两个实验里拿走的心智模型是:约束解码是一道只做删除的闸门。它保证模型说不出不合法的话,不保证模型说得出正确的话。
它彻底解决了”输出解析不了”这一类问题,代价是把模型的一部分表达空间关掉了。关掉的那部分里如果有推理,答案就跟着没了。所以设计 schema 的时候,我会先问一句:这个任务需要模型想吗?需要,就给它留一个先写的字段,或者干脆分两步。不需要,那就把闸门关到最紧,让它连废话的机会都没有。
参考:
- Tam 等,Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models,arXiv 2408.02442,2024
- Willard 与 Louf,Efficient Guided Generation for Large Language Models,arXiv 2307.09702,2023
- Dong 等,XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models,arXiv 2411.15100,2024
- OpenAI,Introducing Structured Outputs in the API,2024
- OpenAI,Structured model outputs,开发者文档,2026 年 9 月查阅
- llama.cpp,GBNF Guide,语法约束文档
- 本机实验:llama.cpp(Homebrew 安装的 llama-server),模型 Qwen/Qwen3-4B-GGUF 的 Q4_K_M,关闭思考模式;算术题取自 GSM8K 测试集前 60 道,温度 0;M4 Pro 48G,2026 年 9 月 28 日
评论