模型文件缩到三分之一,出字快 2.7 倍,读题反而慢了:GPU 的瓶颈是搬数据不是算数
今天在 M4 Pro 的笔记本上跑了个实验:同一个 Qwen3-4B,BF16、Q8、Q4 三个文件,出字速度从每秒 29.9 个 token 涨到 79.7 个,2.7 倍;读题速度却从 886 掉到 840,反而慢了 5%。同一个模型、同一台机器,只因为每个数字用几个字节存,一项翻倍一项不动。这篇把背后的机制讲成人话:显卡里有一座工厂(算力)和一座仓库(显存),A100 每秒能算 312 万亿次却只能搬进 1 万亿个数,每个数要被用够 300 次流水线才不闲着;出字时每个权重只用 2 次所以卡在搬、读题时 512 个 token 共用一次搬运所以卡在算;A100 到 H100 算力涨 3.2 倍带宽只涨 1.64 倍,越来越多的操作掉进等仓库的那一侧。然后讲 FlashAttention 为什么不建那张 n×n 的表、为什么反向传播宁可重算也不回读、计算量更多反而更快;最后说清一条边界:它帮的是读题和训练,对本机出字帮助有限(实测开关只差 7%),以及一条选硬件的判断:先看带宽,再看算力。
写量化那篇的时候我说过一句”4 位模型出字更快,是因为少搬了字节”,当时没有给数字。今天在自己的笔记本上补了这个实验,结果比我预想的更能说明问题:同一个模型的三个文件,出字速度变成了 2.7 倍,读题速度不但没快,还慢了一点。
一边动,一边不动
机器是 M4 Pro 的 MacBook,48G 内存。模型用 Qwen3-4B,从 Hugging Face 拉了三个 GGUF 文件(llama.cpp 用的模型格式):BF16 是没压缩的原版,Q8_0 每个参数压到 8 位,Q4_K_M 压到 4 位出头。跑的是 llama.cpp 自带的 llama-bench,它一条命令给两个数:pp512 是”读题”的速度,把 512 个 token(大模型处理文本的基本单位)的提示词一口气吃进去,每秒处理多少个;tg128 是”出字”的速度,逐个生成 128 个 token,每秒出多少个。每档跑 5 遍取平均,文件大小按 1 GB 等于 10 亿字节算,和带宽的单位一致。
| 文件 | 大小 | 读题 pp512(token/s) | 出字 tg128(token/s) |
|---|---|---|---|
| BF16 | 8.05 GB | 886.5 | 29.9 |
| Q8_0 | 4.28 GB | 878.9 | 52.5 |
| Q4_K_M | 2.50 GB | 839.5 | 79.7 |
出字那一列,文件从 8.05 GB 缩到 2.50 GB,3.2 倍;速度从 29.9 涨到 79.7,2.7 倍。文件缩几倍,速度就涨几倍,略打一点折。读题那一列,三档几乎是同一个数,Q4 甚至还慢了 5%。
同一个模型,同一台机器,同一次运算量,就因为文件里每个数字用几个字节存,一项变成 2.7 倍,另一项纹丝不动。要解释这件事,得先说清楚显卡在跑模型的时候到底在干什么。它不是一直在算。
显卡里有一座工厂和一座仓库
把 GPU 想成一座工厂:算力是流水线,每秒能做多少次运算(一次乘或一次加算一次);显存是仓库,权重和中间结果都堆在里面;两者之间是一条运输通道,它的宽度叫显存带宽,每秒能搬多少字节。
三个数字放一起看就有意思了。A100 的半精度算力是每秒 312 万亿次,显存带宽是每秒 2 TB。半精度一个数占 2 字节,所以通道每秒最多送进来 1 万亿个数。流水线每秒能做 312 万亿次运算,通道每秒只能送 1 万亿个数:每个搬进来的数,平均要被用上 300 次,流水线才不会闲着。用得不够 300 次,流水线就得停下来等原料。
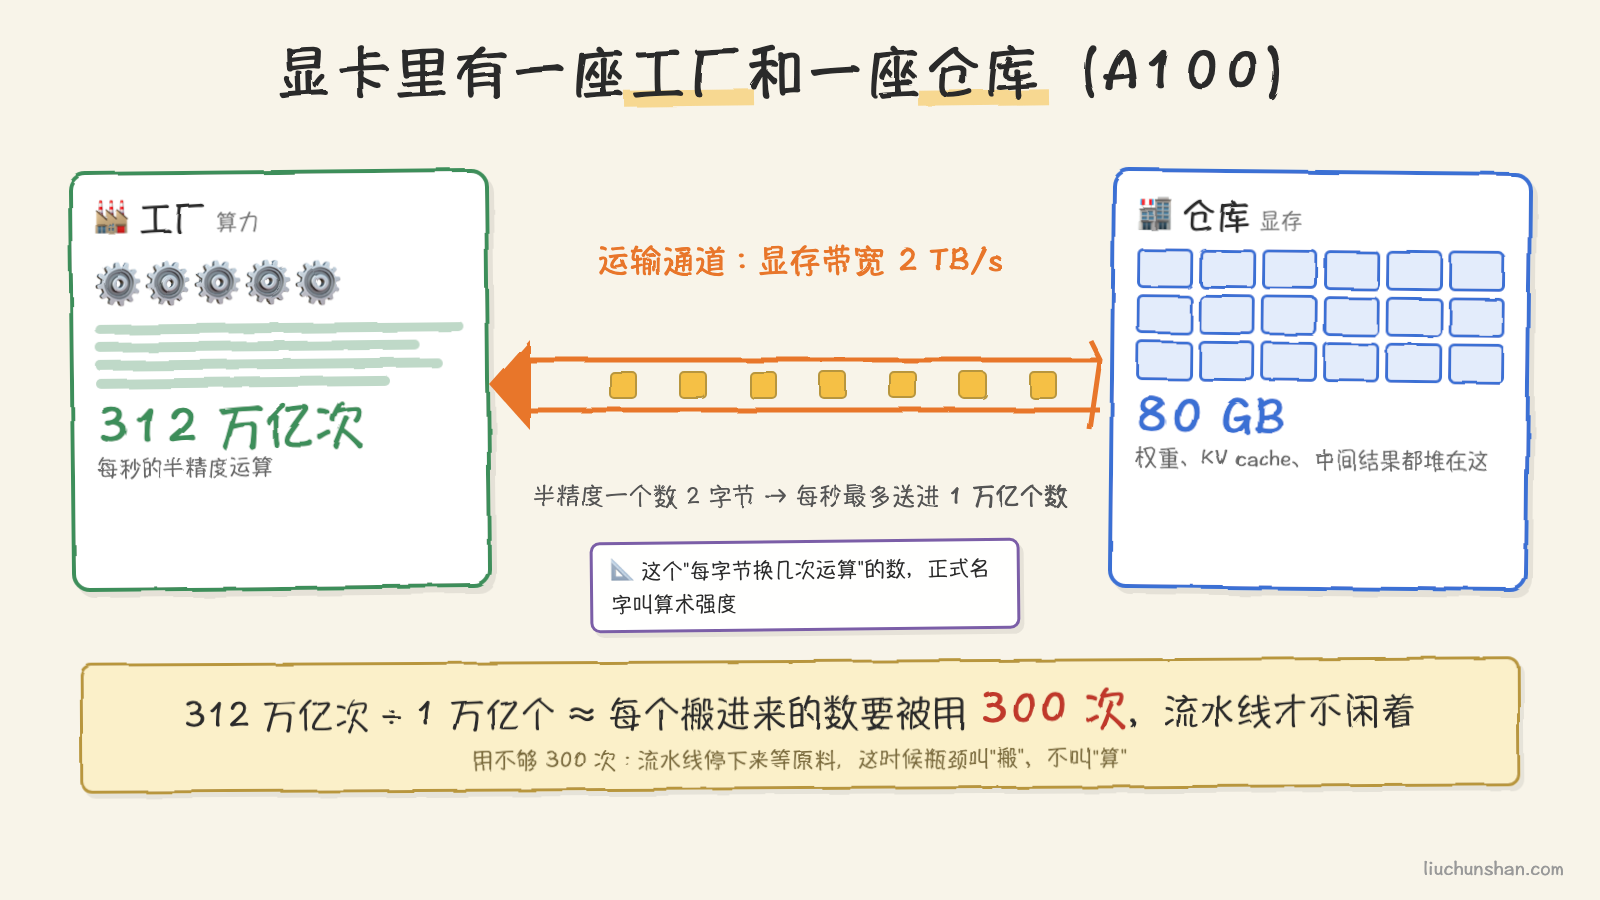
这个”每个字节能换来几次运算”的数,正式名字叫算术强度。它决定了一段计算是卡在”算”上还是卡在”搬”上。矩阵乘法是算术强度的优等生,两个 4096 乘 4096 的矩阵相乘,连结果一起搬进搬出 5 千万个数,要做 1370 亿次运算,每个数摊到两千七百多次,流水线满负荷。而逐个元素的操作,比如把一整个矩阵每个数都过一遍激活函数,搬一个数只算一次,通道跑满的时候流水线只用了三百分之一。
Horace He 有一篇讲这件事的文章叫《Making Deep Learning Go Brrrr From First Principles》,把训练慢的原因分成三类:算不过来、搬不过来、调度不过来。他的比喻是工厂和仓库,我上面借用了。他给的一个数字我印象很深:BERT 里所有非矩阵乘法的操作只占总运算量的 0.2%,却能吃掉可观的时间,因为它们每一个都要把数据从仓库搬出来又搬回去。
出字卡在搬,读题卡在算
回到开头的实验。为什么出字和读题,一个受文件大小影响、一个不受?
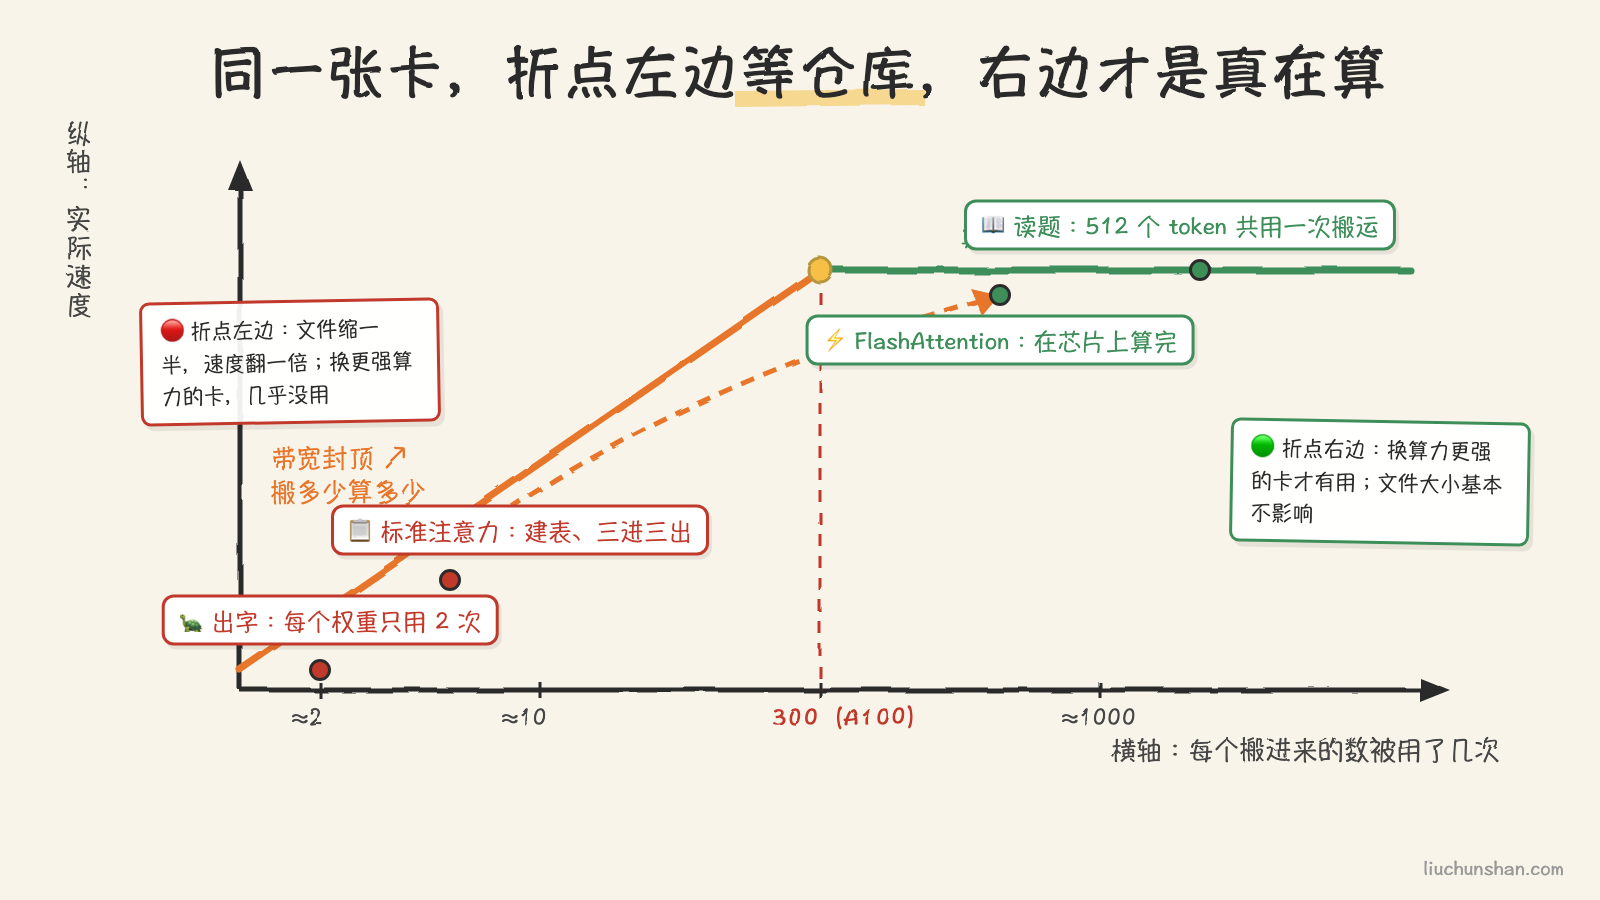
出字的时候,每个字都要把整个模型搬一遍。生成一个 token,要把 4B 模型的全部权重从内存读进计算单元,每个权重只参与 2 次运算(一次乘一次加),然后下一个 token 再来一遍。算术强度是个位数,离 300 差着两个数量级,流水线绝大部分时间在等仓库出货。所以出字的速度上限有个极简单的公式:带宽除以模型文件大小。M4 Pro 的内存带宽是每秒 273 GB,Q4 文件 2.50 GB,上限就是每秒 109 个 token;实测 79.7,跑到了上限的 73%。三档算下来:
| 文件 | 273 GB/s ÷ 文件大小 = 上限 | 实测 | 跑到几成 |
|---|---|---|---|
| BF16 | 34 | 29.9 | 88% |
| Q8_0 | 64 | 52.5 | 82% |
| Q4_K_M | 109 | 79.7 | 73% |
实测到不了上限(KV cache 也要读、量化还原要算、还有各种调度开销),但三档都落在上限的七到九成,说明瓶颈就是那条通道。压得越狠离上限越远,因为把 4 位数还原成 16 位要多算一步、KV cache 那部分读取也不跟着文件缩,可这些都是小头。文件小一半,出字差不多就快一倍,不是模型算得更快了,是仓库搬得少了。
读题的时候,512 个 token 共用一次搬运。提示词是一批进去的,权重搬进来一次,512 个 token 排着队都用它算,算术强度直接乘以 512,从个位数变成一千上下,翻过了 300 那条线,变成算力说了算。这时候文件大小就不重要了,Q4 反而还要多做一步”把 4 位还原成 16 位”的解压,所以它的读题速度反而比 BF16 慢了 5%。这正是量化那篇留下的那句话的另一半:decode 快、prefill 不快,两边是同一枚硬币。
顺便说一句,这也解释了为什么服务端给几百人同时用的时候要拼批:把很多人的请求凑成一批,就是把出字也变成”一次搬运多次使用”,硬把算术强度抬过那条线。
算力涨得比带宽快
这条线还在往上走。A100 到 H100,半精度稠密算力从每秒 312 万亿次涨到 989 万亿次,3.2 倍;显存带宽从 2 TB/s 涨到 3.35 TB/s,1.64 倍。流水线扩到 3.2 倍,通道只拓宽了六成,于是”每个数要被用够多少次才不亏”从 300 涨到了 590。原来刚好够格的操作,换到新卡上就掉回了等原料的那一侧。
FlashAttention 论文的引言里就有这句话:“在现代 GPU 上,计算速度已经跑赢了访存速度,Transformer 里的大多数操作都卡在访存上。“这句话是整篇论文的前提,也是理解它做了什么的钥匙。
FlashAttention:不建那张表
前面讲注意力的时候说过,每个词要去问过所有词,n 个词就要算一张 n 乘 n 的打分表。标准做法是老老实实把这张表建出来:算出打分表写进显存,读出来做 softmax(把一行打分变成加起来等于 1 的比例)再写回去,再读出来和值矩阵相乘。三进三出,每一趟都是 n 平方的量。
这张表有多大?4096 个 token,半精度,一个头的表是 4096 乘 4096 乘 2 字节,33 MB;32 个头就是 1 GB,还是一层、一条样本的量。而它的算术强度并不高:每个分数算出来,只被 softmax 和后面的乘法用那么几次,远够不上 300。于是注意力这一步在 A100 上是典型的”搬不过来”,算力晾在一边。
FlashAttention 的思路简单到有点不像论文:这张表别建了。把查询、键、值都切成小块,一次只把几块搬进芯片上的高速缓存(论文图 1 里标的数:SRAM 只有 20 MB,但带宽是每秒 19 TB,比显存快十几倍;显存在数据中心卡上叫 HBM),在里面把这几块的打分、softmax、乘值一口气做完,只把最终结果写回显存。那张 n 乘 n 的表从头到尾没有完整存在过,显存占用从 n 的平方降到 n 的一次方。
有个技术细节是这招能成立的关键。softmax 要先看完整行的最大值才能归一化,可分块的时候一次只能看到一行的一小段。论文用的是”在线 softmax”:一边看一边记住目前为止的最大值和累计和,来了新的一块就把之前的结果按比例修正。不需要看完整行,也能得到和一次算完一模一样的结果,所以它是精确注意力,不是近似。
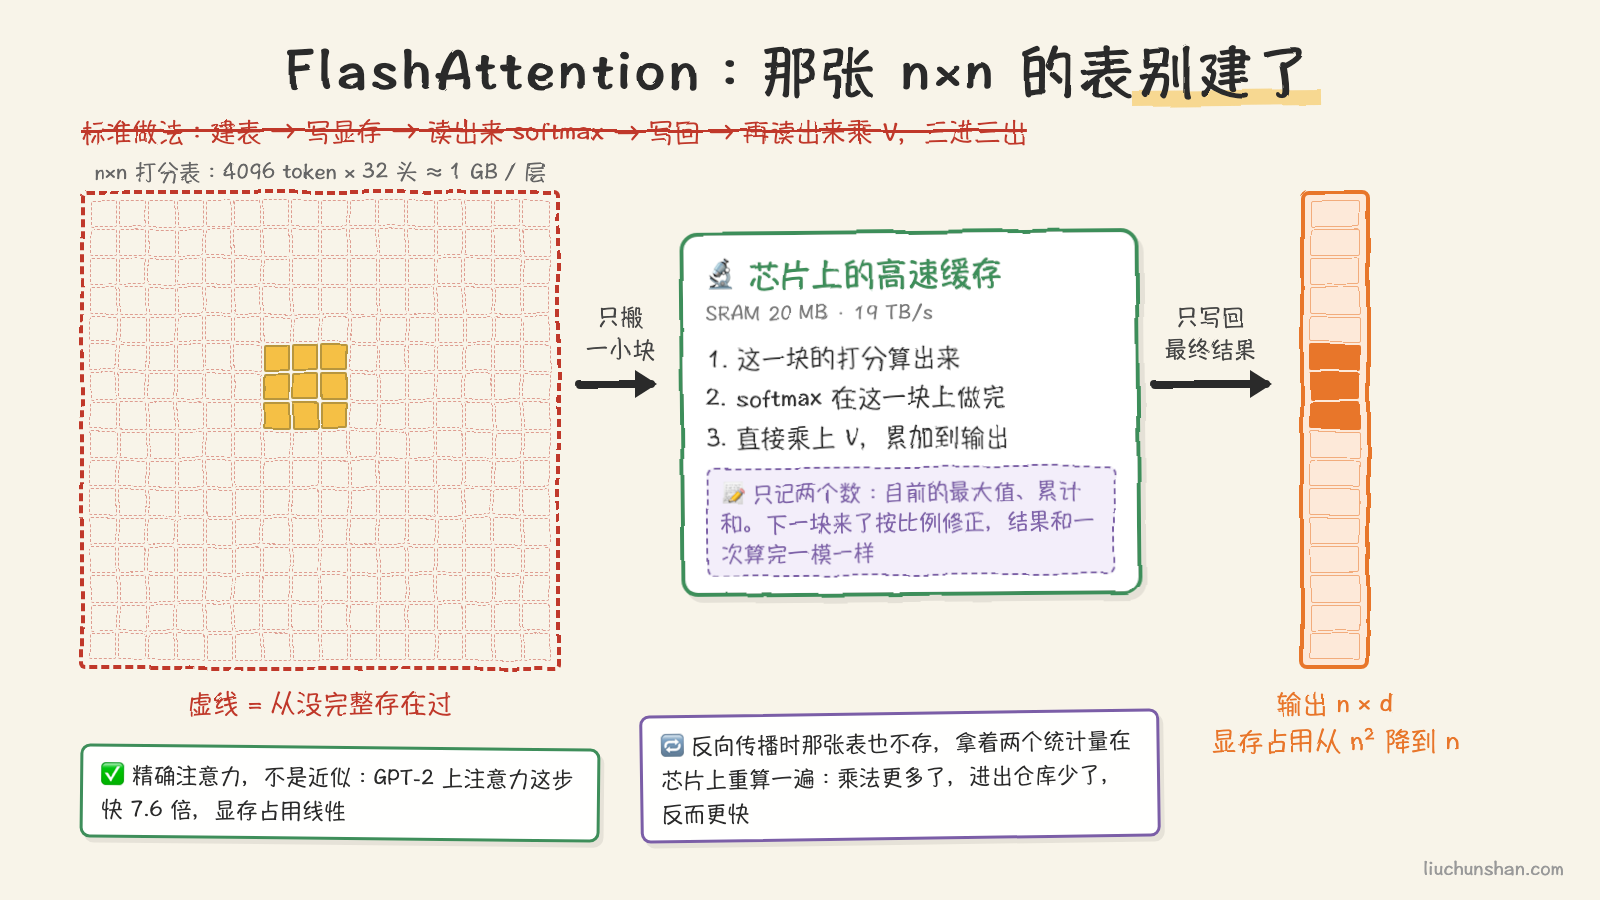
反向传播更反直觉:训练时要用到那张表来算梯度,标准做法是前向时把它存下来。FlashAttention 干脆不存,反向时拿着前向留下的两个归一化统计量,把表在芯片上重算一遍。计算量比标准做法还多了,但因为不用从显存读那张 1 GB 的表,反而更快。论文给的数字:GPT-2 上注意力这一步快了 7.6 倍,整个模型训练快 3 倍;BERT-large 的端到端训练比当时 MLPerf 1.1 的速度纪录还快 15%;序列越长赚得越多,长序列基准上快 2.4 倍。
它没有减少一次乘法,甚至多做了一些。它减少的只有一样东西:进出仓库的次数。这就是那句”少搬字节比少做乘法更值钱”的完整版本。
后面的故事是同一个思路在追硬件。FlashAttention-2 发现第一版只跑到了 A100 理论算力的 25% 到 40%,原因不在搬运而在流水线内部的分工,重新切分任务后再提速 2 倍,跑到 50% 到 73%。到了 H100,第二版又只剩 35%,因为新卡多了异步搬运和 FP8 这些新本事,FlashAttention-3 用上它们后半精度跑到了每秒 740 万亿次,75% 的利用率。每一代都是同一个问题:硬件变了,“搬”和”算”的平衡点又挪了,代码要重新对齐。
一条要说清楚的边界
写到这里得把一件事掰开,因为它是这个话题里最容易讲混的。
FlashAttention 省的是注意力那张 n 乘 n 表的进出,赚的是读题和训练的时间,序列越长越明显。它对本机逐字生成帮助有限:出字的瓶颈是每个 token 都要把全部权重搬一遍,那是权重的进出,不是打分表的进出。我在 llama-bench 里把 flash attention 开关各跑了一遍,提示词加长到 2048 个 token:读题快了 4%,出字快了 7%,都是小数,和换文件带来的 2.7 倍不是一个量级。所以”装了 FlashAttention 你的本地模型就快了”这句话,只在你贴长文档的时候成立一部分,对出字速度基本是错的。
反过来,对出字有用的是另一批手段,它们都在做同一件事:让每次搬运换来更多次运算。量化是把要搬的字节变少;拼批是一次搬运多个请求共用;投机解码是让大模型一趟搬运验收好几个草稿字,前面那篇讲过。这三样和 FlashAttention 是同一个原理的四个方向。
带走的一个判断
我自己从这个实验里拿走的心智模型是一句话:跑大模型,先问搬得动多少,再问算得动多少。
它直接影响买什么机器。本地跑模型,M4 Pro 的内存带宽是每秒 273 GB,M4 Max 是 546 GB,同一个模型放上去出字速度差不多就是两倍,而两者 CPU 核数的差距远没有这么大。数据中心里 H100 比 A100 贵那么多,对推理服务来说买到的主要是 HBM 从 2 TB/s 到 3.35 TB/s 的那一段,而不是 3.2 倍的算力。看显卡参数表,做推理的人应该先找”显存带宽”那一行,TFLOPS 排在它后面。
它也解释了过去两年推理优化几乎所有的方向:量化、GQA(几个注意力头共用一份键值)、KV cache 复用、算子融合、投机解码,没有一样是在减少乘法,全都是在减少搬运。想通这一点以后,再看到一个新的加速技术,我会先问一句:它省的是算,还是搬?答案几乎总是后者。
参考:
- Dao 等,FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,arXiv 2205.14135,2022
- Dao,FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning,arXiv 2307.08691,2023
- Shah 等,FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision,arXiv 2407.08608,2024
- Horace He,Making Deep Learning Go Brrrr From First Principles,2022
- A100 与 H100 的算力和带宽取自 NVIDIA 官方产品页 A100、H100(半精度算力取不带稀疏的稠密值),2026 年 9 月查阅
- M4 Pro 与 M4 Max 的内存带宽取自 Apple 新闻稿,2024
- 本机实验:llama.cpp(Homebrew 安装的 llama-bench),模型 Qwen/Qwen3-4B-GGUF 的 Q8_0、Q4_K_M 与 unsloth/Qwen3-4B-GGUF 的 BF16,M4 Pro 48G,2026 年 9 月 27 日
评论