"我不喜欢猫"更像"我喜欢猫",而不是"我喜欢狗":向量模型讲人话
今天在自己电脑上跑了一个小实验:把"我喜欢猫""我不喜欢猫""我喜欢狗"三句话交给一个常用的中文向量模型,算两两之间有多像。结果"我不喜欢猫"和"我喜欢猫"的相似度是 0.830,"我喜欢狗"只有 0.784。在它眼里,意思完全相反的那句,反而比换了个宠物的那句更接近。这不是这个模型的毛病。2023 年的 NevIR 测试让检索模型排两份只差一个"不"字的文档,随机乱排能拿 25 分,OpenAI 最大的向量模型拿 22.6 分,大多数模型不如抛硬币。这篇讲清楚为什么:一句话被压成一串数字时"不"字去了哪,为什么 RAG 要在向量模型后面再挂一个 reranker(同一道题它能从 39 分提到 65 分,但也就到 65),Sentence-BERT 那组 65 小时对 5 秒的数字为什么决定了两个模型缺一不可,以及部署向量模型时用聊天接口测它为什么会 404。最后是我的看法:带"不"的条件,别指望检索层替你把关。
前面写 RAG 那篇时,我把检索这一步一句话带过了:“把问题变成向量,找最近的几段文档”。昨天讲长上下文,又说”找到了也不一定用得好”。今天想补更前面的那一环:向量模型到底是怎么”找”的,以及它找不到什么。
起因是我今天在自己电脑上做的一个小实验。
一个反直觉的数字
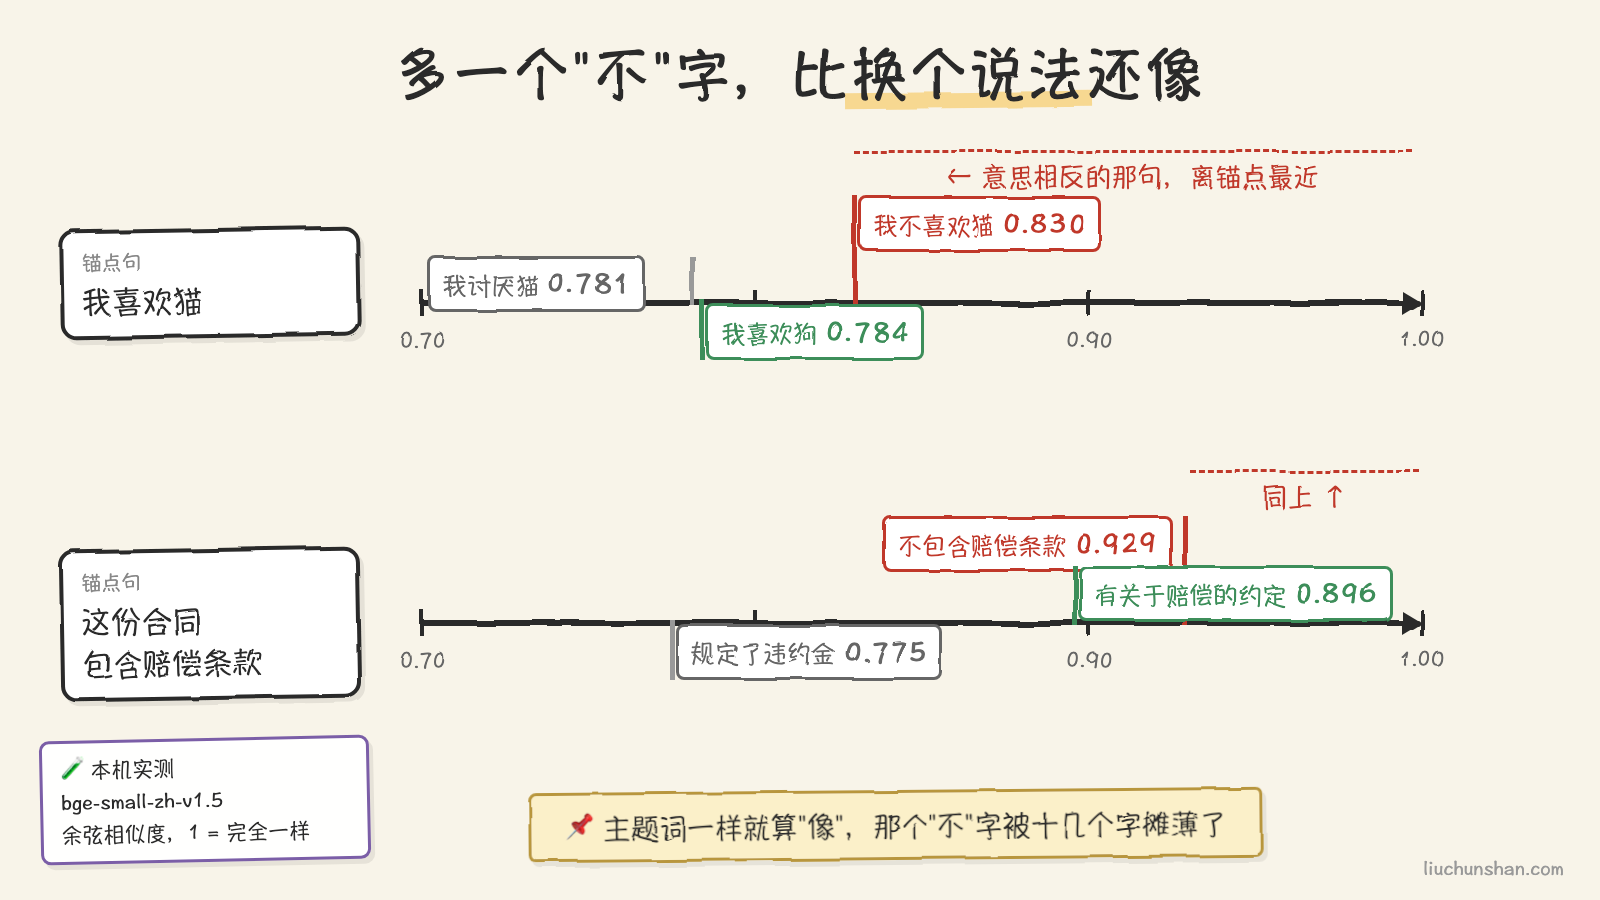
我装了 sentence-transformers,拉了一个很常用的中文向量模型 bge-small-zh-v1.5(智源开源的那个系列里最小的一档,5 亿参数不到,笔记本上秒出结果),把三句话交给它,算两两之间的余弦相似度(两个向量方向有多接近,1 是完全一样,0 是毫无关系):
| 拿”我喜欢猫”去比 | 相似度 |
|---|---|
| 我不喜欢猫 | 0.830 |
| 我讨厌猫 | 0.781 |
| 我喜欢狗 | 0.784 |
意思完全相反的”我不喜欢猫”,比只换了个宠物的”我喜欢狗”更像原句。“我讨厌猫”和”我喜欢狗”几乎打平。
换一组更像真实业务的句子,差距更夸张:
| 拿”这份合同包含赔偿条款”去比 | 相似度 |
|---|---|
| 这份合同不包含赔偿条款 | 0.929 |
| 这份合同里有关于赔偿的约定 | 0.896 |
| 这份合同规定了违约金 | 0.775 |
多一个”不”字,相似度 0.929;换个说法表达同一个意思,反而只有 0.896。在向量模型的眼里,“包含”和”不包含”是同一句话的两个近似写法,比同义改写还近。
第一反应是这个模型太小了。但往下查才发现,这是整个技术路线的通病,而且有人系统地测过。
大多数检索模型,不如抛硬币
2023 年约翰霍普金斯大学的几位研究者做了一个专门的测试集,叫 NevIR(Negation in Neural Information Retrieval,神经检索里的否定)。题目设计得很简单:给一对文档,两份只差一个否定,比如一份说”这种药能和酒一起吃”,另一份说”这种药不能和酒一起吃”;再给两个问题,各自对应其中一份。让检索模型给两个问题分别排序,两次都把正确的那份排在前面才算对。总共 2556 对。
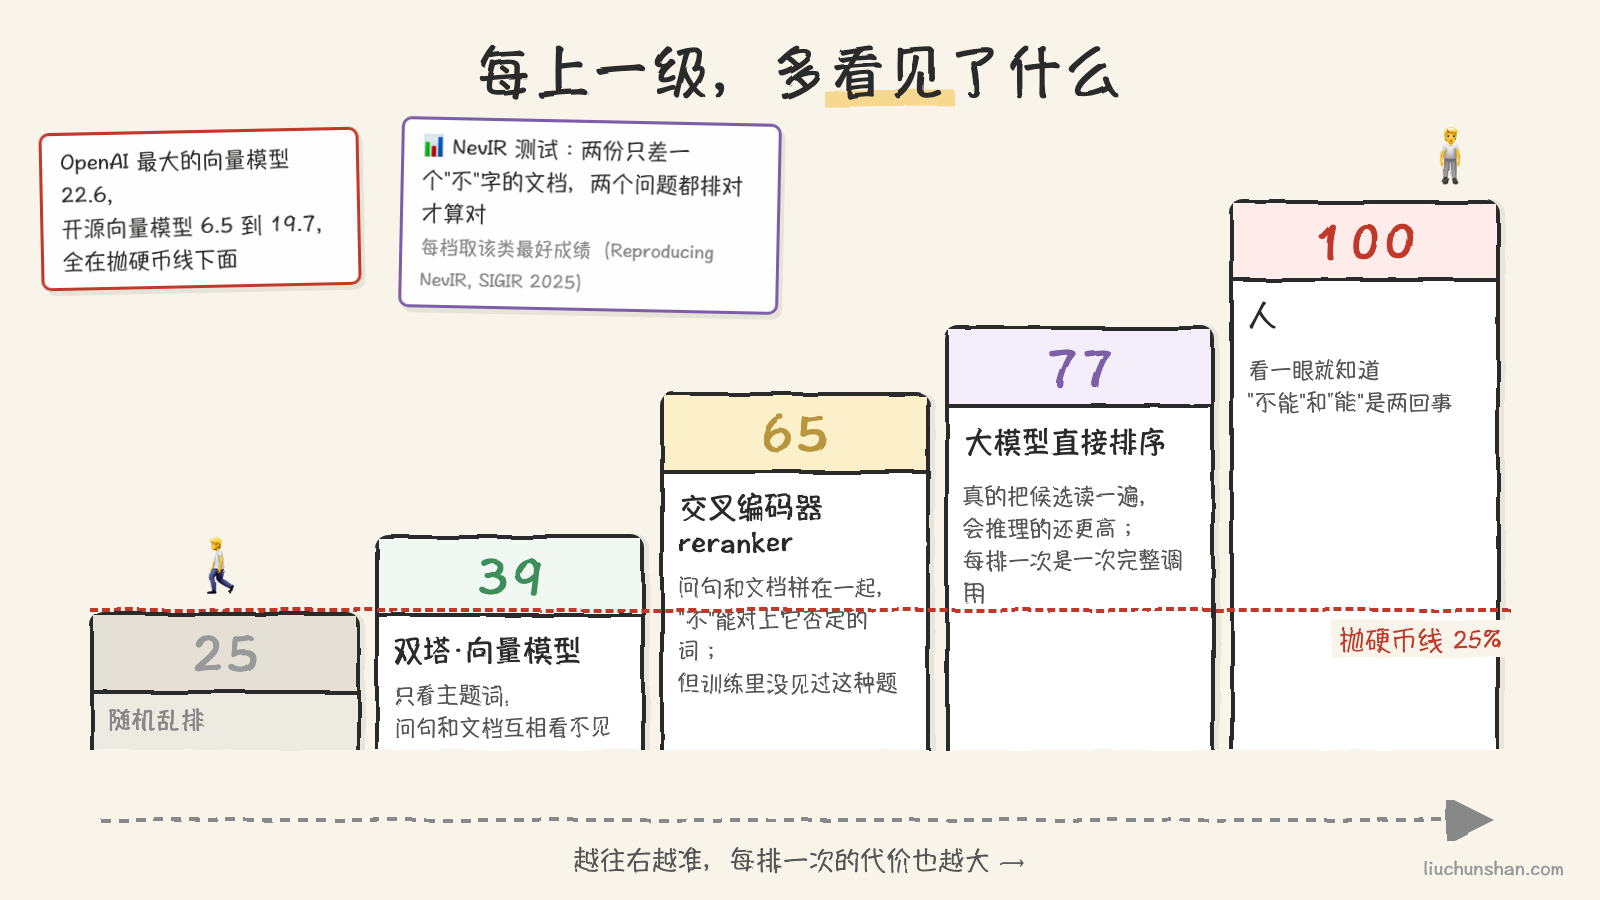
因为每次排对的概率是一半,两次都对是四分之一,所以随机乱排的基线是 25%。人做这道题是 100%。
2025 年阿姆斯特丹大学的团队把这套测试复现了一遍,还把两年间新出的模型都补进去测了。几个代表性的分数:
| 模型类型 | 代表模型 | 成绩 |
|---|---|---|
| 随机乱排 | 抛硬币 | 25% |
| 关键词匹配 | TF-IDF | 2.0% |
| 向量模型 | OpenAI text-embedding-3-large | 22.6% |
| 向量模型 | GritLM-7B(这一类里最好的) | 39.0% |
| 交叉编码器(reranker) | bge-reranker-v2-m3 | 43.5% |
| 交叉编码器(reranker) | jina-reranker-v2(这一类里最好的) | 65.2% |
| 大模型直接排序 | GPT-4o | 70.1% |
| 大模型直接排序 | o3-mini | 77.3% |
| 人 | 100% |
先看最惨的那行。TF-IDF 是最老派的关键词匹配,两份文档的词几乎全部一样,只多一个”不”,而”不”又是全语料里最常见的字之一,权重被压到几乎为零。它不是在猜,是稳定地把错的排前面,所以比随机还低得多。
向量模型那两行更值得看。OpenAI 最大的向量模型 22.6%,低于抛硬币。表里那一大串开源向量模型,从 6.5% 到 19.7%,全在 25% 以下。只有 GritLM 这个 70 亿参数、拿大语言模型底座改出来的向量模型过了随机线,也只有 39%。
“不”字去哪了
要理解这件事,得先说清楚向量模型在做什么。
它接收一句话,输出一串固定长度的数字,我用的这个模型是 512 个,大一点的模型是 1024 或者更多。这串数字就是这句话的”坐标”。训练目标只有一条:意思相近的句子,坐标要靠近;意思无关的,坐标要远离。训练数据是成对的”问题和它对应的答案段落”,比如 MS MARCO 这种从真实搜索日志里攒出来的几十万对。
问题就出在”意思相近”这四个字的定义上。训练时给模型看的负例(不该靠近的句子),绝大多数是随便从语料里抓的另一段话,主题都不一样。模型很快学会一件事:看主题词。“合同""赔偿""条款”这些词一致,就是相近;“猫”换成”狗”,就远一点。它从来没被逼着学”两句话主题词全一样,但意思相反”这种情况,因为训练集里几乎没有这样的负例。
于是一句话压成 512 个数的时候,主题词占了绝大部分权重,“不”这一个字的贡献被十几个字摊薄了。不是模型完全看不见”不”,是”不”的信号太弱,一被词面重合压过去就没了。
今年九月有一位做本地 RAG 的开发者专门测了这一点,他的设计很巧:问题说”备份没有完成”,两份文档一份说”备份失败了”、一份说”备份完成了”。当正确文档和问题用同样的词时,7 个向量模型平均答对 96%;当正确文档换了个说法、错误文档反而和问题共用原词时,平均只有 28%。同一批模型,同一个否定,只是换了措辞,成绩从接近满分掉到远低于抛硬币。他的结论我很认同:模型看的不是否定,是词面重合,否定信号只有在和词面重合方向一致时才显得有用。
为什么 RAG 要挂两个模型
那 reranker 是怎么从 22 分提到 65 分的?它和向量模型的差别,不在参数多少,在架构。
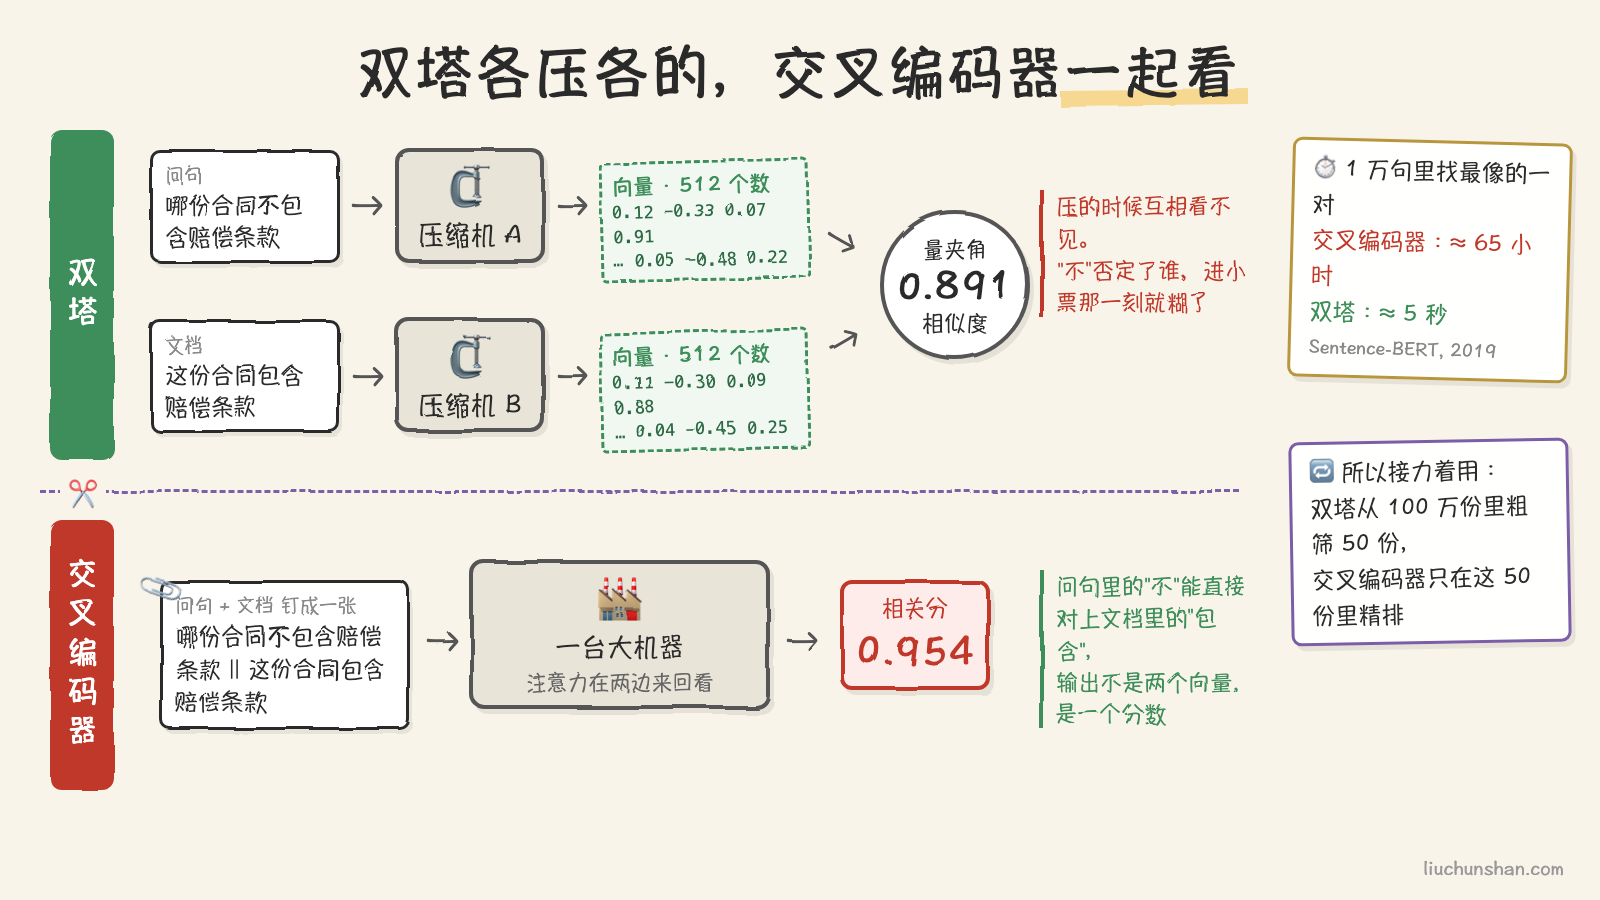
向量模型是”双塔”结构:问题走一座塔,文档走另一座塔,各自被压成一个向量,最后算两个向量的夹角。关键是,压的时候两边互相看不见。文档被压成向量的那一刻,它不知道会来什么问题;问题被压的时候,也不知道要比对什么文档。“不包含”里的”不”要修饰的是”包含”,但等它们被压进 512 个数之后,“不”到底否定了什么,这个信息已经糊掉了。
reranker 用的是”交叉编码器”:把问题和文档拼成一段,一起送进模型,让注意力机制在两边之间来回看。问题里的”不”能直接对上文档里的”包含”或”不包含”,输出的不是两个向量,是一个分数。它能看见的东西,双塔天生看不见。
既然 reranker 更准,为什么不全用它?
2019 年 Sentence-BERT 的论文开头就算过这笔账:要在 1 万个句子里找出最相似的一对,用交叉编码器要跑约 5000 万次推理,大约 65 小时;用双塔模型先把 1 万个句子各压成一个向量,再算向量间的距离,大约 5 秒。
道理很简单。双塔的文档向量可以提前算好存起来,来一个问题只需要压一次问题、算一次距离,文档库有多大都不怕。交叉编码器每来一个问题,都要把它和库里每一份文档拼起来重新过一遍模型,文档库 100 万份就是 100 万次推理。所以标准做法是两段接力:向量模型从 100 万份里粗筛出 50 份,reranker 只在这 50 份里精排。快的先跑一遍,准的只看头部。
这也解释了为什么 reranker 能到 65 分也只能到 65 分。它比双塔多看见了问题和文档之间的对应关系,但它的训练数据和向量模型是同一批,同样缺”只差一个不字”的负例。九月那位开发者测的 6 个 reranker,在换措辞的条件下平均 26%,比向量模型的 28% 还低一点。表里最好的 jina 到 65%,多数只有三四十分。
再往上一档是让大模型直接排序:把问题和候选文档都写进提示词,让它读完说哪个更相关。o3-mini 到了 77.3%。它是真的在”读”,有推理能力的模型还更高一些。代价也最大,每排一次都是一次完整的大模型调用。
自己跑一遍接力
我把上面那组合同的句子按检索的方式再跑了一遍:一个问题、三份候选文档,分别用向量模型和 bge-reranker-base 打分。
问题:“哪份合同不包含赔偿条款”。
| 候选文档 | 向量模型 | reranker |
|---|---|---|
| 这份合同不包含赔偿条款 | 0.947 | 0.999 |
| 这份合同包含赔偿条款 | 0.891 | 0.954 |
| 这份合同没有约定赔偿事项 | 0.835 | 0.973 |
两边都把字面一样的正确答案排第一,这不奇怪。差别在第二、三名:第三份文档意思和问题一致(没约定赔偿事项就是不包含赔偿条款),只是换了说法,向量模型把它排在了意思相反的第二份后面,而 reranker 把它提到了前面。这就是”多看见了对应关系”的效果。
再换一个更贴近日常的:问题”备份任务没有完成”。
| 候选文档 | 向量模型 | reranker |
|---|---|---|
| 备份任务失败了,没有跑完 | 0.888 | 0.996 |
| 备份任务已经完成 | 0.882 | 0.812 |
| 备份任务成功结束 | 0.864 | 0.975 |
向量模型给”失败了”和”已经完成”的分数只差 0.006,几乎是打平,换个模型、换个措辞就可能反过来。reranker 拉开到 0.18,很稳。但注意第三行:reranker 给”成功结束”打了 0.975,只比正确答案低一点。它认出了”已经完成”是反的,却没认出”成功结束”也是反的。这就是那 65 分的意思:比双塔强一档,但离靠谱还远。
顺带一个部署时的坑:向量模型没有聊天接口
去年我第一次在服务器上部署一个向量模型,起来之后习惯性地用聊天接口去测它,返回 404。我以为是服务没起好,折腾了好一阵,才反应过来这不是故障。
向量模型的输出是一串数字,不是下一个字。早期的向量模型是 BERT 那一族的编码器架构,压根没有”预测下一个词”的那个输出头,让它聊天,它从结构上就做不到。这两年流行的用大语言模型底座改的向量模型(比如 Qwen3-Embedding、上面表里的 GritLM),底座虽然会说话,但微调之后拿来当输出的是最后一层的隐藏状态,服务框架也只给它开向量接口。所以部署完只有 /v1/embeddings 这一个路径可用,去打 /v1/chat/completions 返回 404 是正常的。测它要传一段文本,看回来的是不是一串长度对得上的浮点数。
三合一模型是在补哪个短板
这两年做 RAG 的人常用 bge-m3,它一个模型同时出三种东西:稠密向量(上面讲的那种,一句话一串数)、稀疏向量(每个词一个权重,本质是学出来的关键词匹配)、多向量(每个词一个向量,问题的每个词去文档里找最像的词)。
三种各有各的用处。稠密向量会把”补丁”和”更新包”看成一回事,稀疏向量能保证型号、编号这种精确词面不被糊掉,多向量介于两者之间。所谓 hybrid 检索,就是把稠密和稀疏的分数合起来用。
但要说清楚一点:三合一补的是”精确词面”这个短板,不是否定。表里稀疏模型那几行(SPLADE 系列)在否定题上也只有 8% 到 10%,多向量的 ColBERT 是 13% 到 20%,都在随机线以下。否定不是”看不到词”的问题,是”看到了但不知道它否定了谁”的问题,换一种向量形式解决不了。
我的看法
说到这里,一个实用的结论就出来了:问题里带”不""没有""除了”这类条件的,别指望检索层替你把关。向量模型大概率看不见它,reranker 看见一半,就算到了大模型这一档也不是 100%。
我自己的做法是绕开它。能变成结构化条件的就变成结构化条件:“状态不等于已完成”是一个字段过滤,不该交给语义检索去猜。能改成正向表述的就改成正向:“没完成的备份”改成”失败或中断的备份”,词面重合反而站到你这边。剩下的,交给最后读全文的那个大模型去判断,把候选多召回几份,让它自己看。昨天那篇讲过,它也有”中间看不清”的毛病,但至少它是真的在读。
检索这一层的本事是快,不是懂。知道它不懂什么,比换一个更大的向量模型有用。
参考
- Orion Weller, Dawn Lawrie, Benjamin Van Durme,NevIR: Negation in Neural Information Retrieval,arXiv:2305.07614,2023(EACL 2024)
- Coen van den Elsen, Francien Barkhof, Thijmen Nijdam, Simon Lupart, Mohammad Aliannejadi,Reproducing NevIR: Negation in Neural Information Retrieval,arXiv:2502.13506,2025(SIGIR 2025)
- Nils Reimers, Iryna Gurevych,Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks,arXiv:1908.10084,2019
- Jianlv Chen 等,M3-Embedding: Multi-Linguality, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation,arXiv:2402.03216,2024
- Serdarcan Büyükdereli,Negation in RAG, Measured: Most Rerankers Do Worse Than a Coin Flip,2026-09-14
- 文中我自己的实测用的是 BAAI/bge-small-zh-v1.5 与 BAAI/bge-reranker-base,sentence-transformers 6.1.0,相似度为归一化后的余弦值
评论