答案埋在中间,AI 答得还不如一份文档都不给:长上下文讲人话
给模型 20 份文档,其中一份有答案。答案放第 1 份,GPT-3.5 答对 75.8%;放第 10 份,只剩 53.8%,比一份文档都不给、让它闭卷硬答的 56.1% 还低。窗口从 4K 涨到 100 万,"塞得进"早就不是问题,"用得好"才是。这篇接着位置编码往下讲:大海捞针测试为什么人人满分却说明不了什么,换一种不给字面线索的问法、GPT-4o 在 32K 就从 99.3% 掉到 69.7%;标称 128K 的模型,有效长度常常只有 32K;注意力为什么偏爱开头和结尾;以及长窗口到底该怎么用:文档放前、问题放后、先摘引再作答、能少塞就少塞。
前几天讲位置编码,结尾我留了个尾巴:位置编码决定了一段文字”能不能塞进去”,塞进去之后模型到底用不用得好,是另一回事。今天讲这另一回事。
先看一组数字,它是我读长上下文相关论文时印象最深的一组。
2023 年斯坦福等几家机构做过一个实验:给模型一个问题,再附上 20 份文档,其中只有 1 份包含答案,其余 19 份是相关但没用的。然后只改一件事:把有答案的那份文档挪到不同位置。GPT-3.5-Turbo 的成绩是这样的:
- 答案在第 1 份:答对 75.8%
- 答案在第 10 份:答对 53.8%
- 一份文档都不给,让它闭卷凭记忆硬答:56.1%
- 只给那 1 份有答案的文档:88.3%
答案放在中间,它的表现比什么都不给还差。你辛辛苦苦把资料喂进去,反而帮了倒忙。
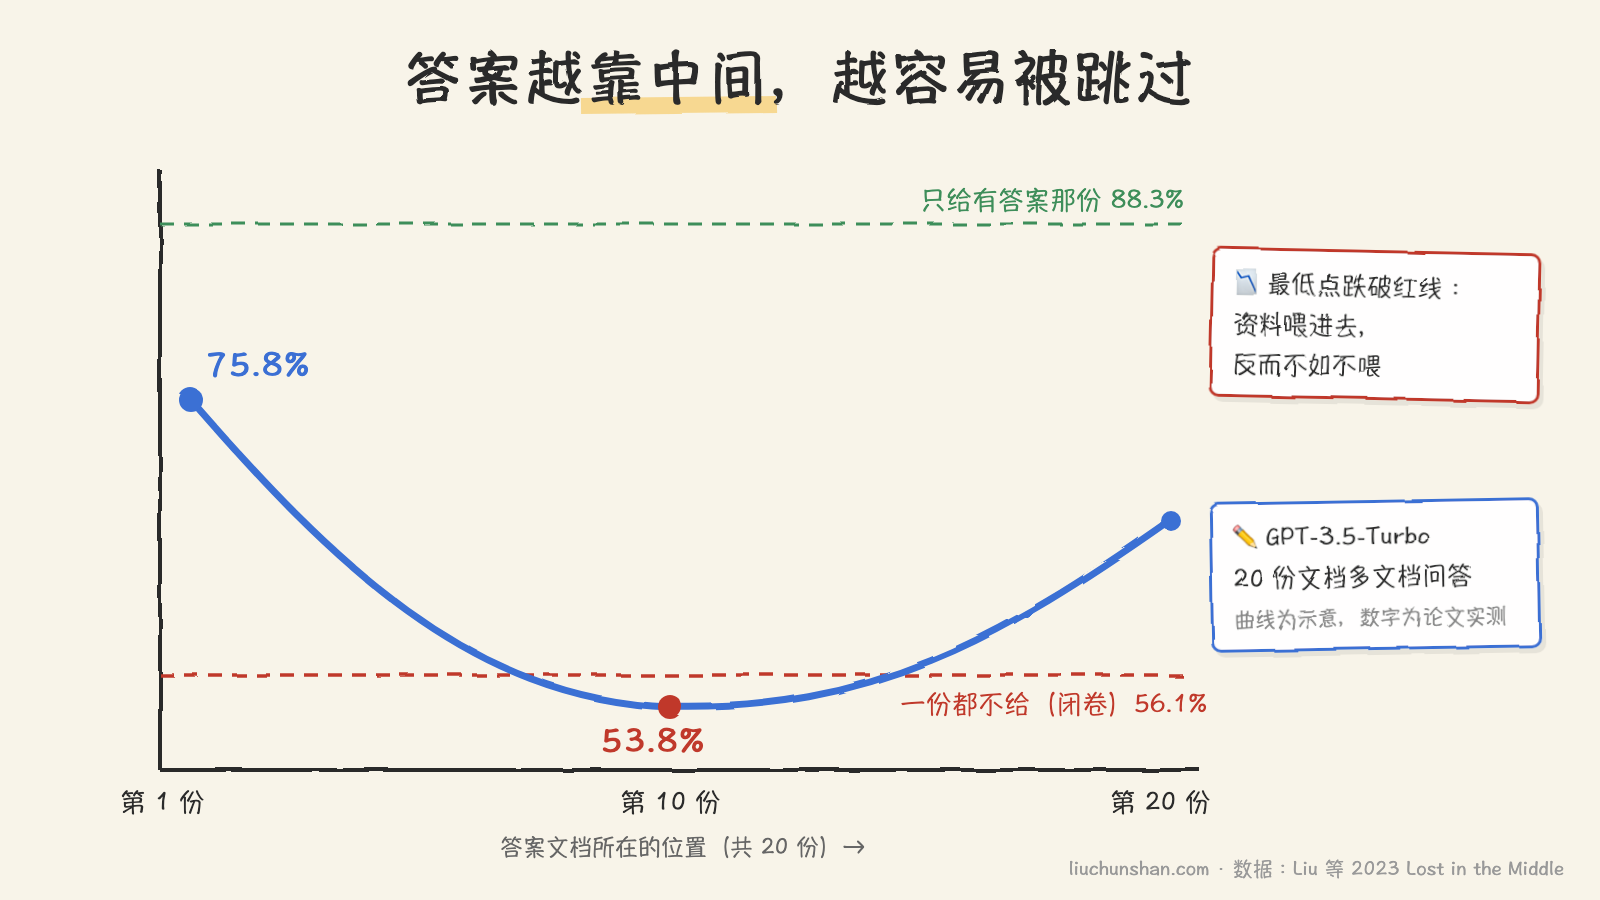
U 形曲线:开头和结尾记得牢,中间被扫过去
把 20 个位置的成绩连成线,是一条 U 形:两头高,中间塌。这篇论文的名字就叫 Lost in the Middle(迷失在中间)。他们换了好几个模型测,包括当时专门主打长上下文的版本,形状都差不多。
我之前在讲上下文窗口和 RAG 的两篇里都顺手提过这个现象,但都只是一句话带过。这次想把它展开,因为它背后是一个更大的问题:模型标的窗口越来越大,从 4K 到 128K 再到 100 万,但”能放进去多少”和”能用好多少”之间的差距,比大多数人以为的大得多。
大海捞针为什么人人满分
你可能见过一种很漂亮的热力图:横轴是上下文长度,纵轴是插入位置,格子全是绿的。这是”大海捞针”测试(needle in a haystack),2023 年一位开发者做的开源测试,后来几乎成了每家发布长上下文模型时的标配。
做法很简单:拿一堆文章当干草堆(原版用的是 Paul Graham 的散文),在某个位置插一句跟上下文无关的话当针,比如”在旧金山最好的事,是在阳光明媚的日子里吃个三明治、坐在多洛雷斯公园”,然后问模型”在旧金山最好的事是什么”。
这个测试有个问题:针和问题几乎用的是同一批词。问题里有”旧金山""最好的事”,针里也有。模型要做的更像是在文档里按 Ctrl+F,找到字面重合最高的那一句抄出来。注意力机制做这件事很拿手:问题里的词去比对全文所有词,字面一样的词向量很接近,分数自然最高,一下就被挑出来了。
所以大海捞针满分,说明的是”模型能在长文里找到一句和问题字面相似的话”,不是”模型读懂了这么长的东西”。
这里还有一个插曲很能说明问题。Claude 2.1 刚发布时,有人用这个测试跑出来的成绩不好看。Anthropic 后来发了一篇文章解释:模型其实找到了那句话,但它觉得这句话跟全文格格不入,像是被人硬塞进来的,所以不愿意拿它当答案。他们在提示里加了一句”以下是上下文中最相关的一句话:“,让模型的回答从这句开头,准确率从 27% 升到 98%。同一个模型、同一份上下文,只差一句引导。这说明测出来的分数里,混着不少”愿不愿意用”的成分,不全是”能不能找到”。
换一种问法,就露馅了
2025 年有一篇论文专门堵这个漏洞,叫 NoLiMa(No Literal Matching,没有字面匹配)。它把针和问题之间的共同词拿掉,逼模型多走一步联想。
论文里的例子是这样的。针是:“其实,Yuki 就住在森帕歌剧院旁边。“问题是:“哪个角色去过德累斯顿?”
问题里没有”森帕歌剧院”,针里没有”德累斯顿”。模型得自己知道森帕歌剧院在德累斯顿,才能把两句接上。这一步联想对模型来说毫不费力,短文本里它几乎全对。难的是在长文里:它没法再靠字面相似把那句话一下子挑出来了。
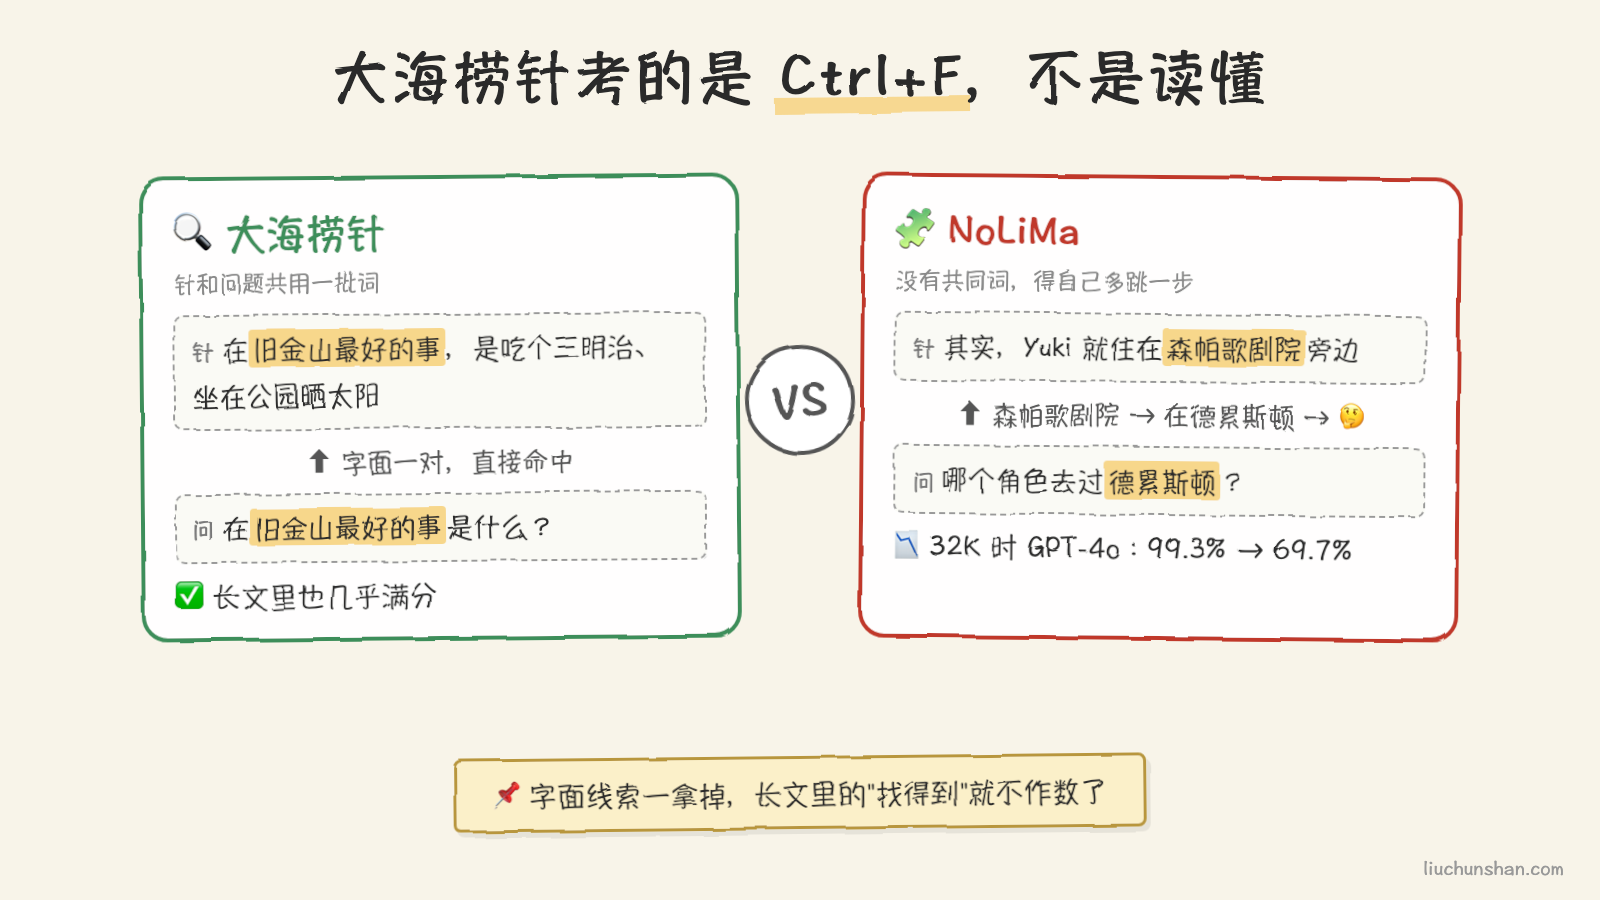
结果是这样的。他们测了 13 个主打长上下文的模型,到 32K 长度时,有 11 个的成绩掉到了自己短文本成绩的一半以下。表现最好的 GPT-4o,从 99.3% 掉到 69.7%;Llama 3.3 70B 从 97.3% 掉到 42.7%。32K 是什么概念?大约两三万个汉字,一份不算长的技术文档,离这些模型标称的 128K 还差得远。
标称长度和有效长度是两个数
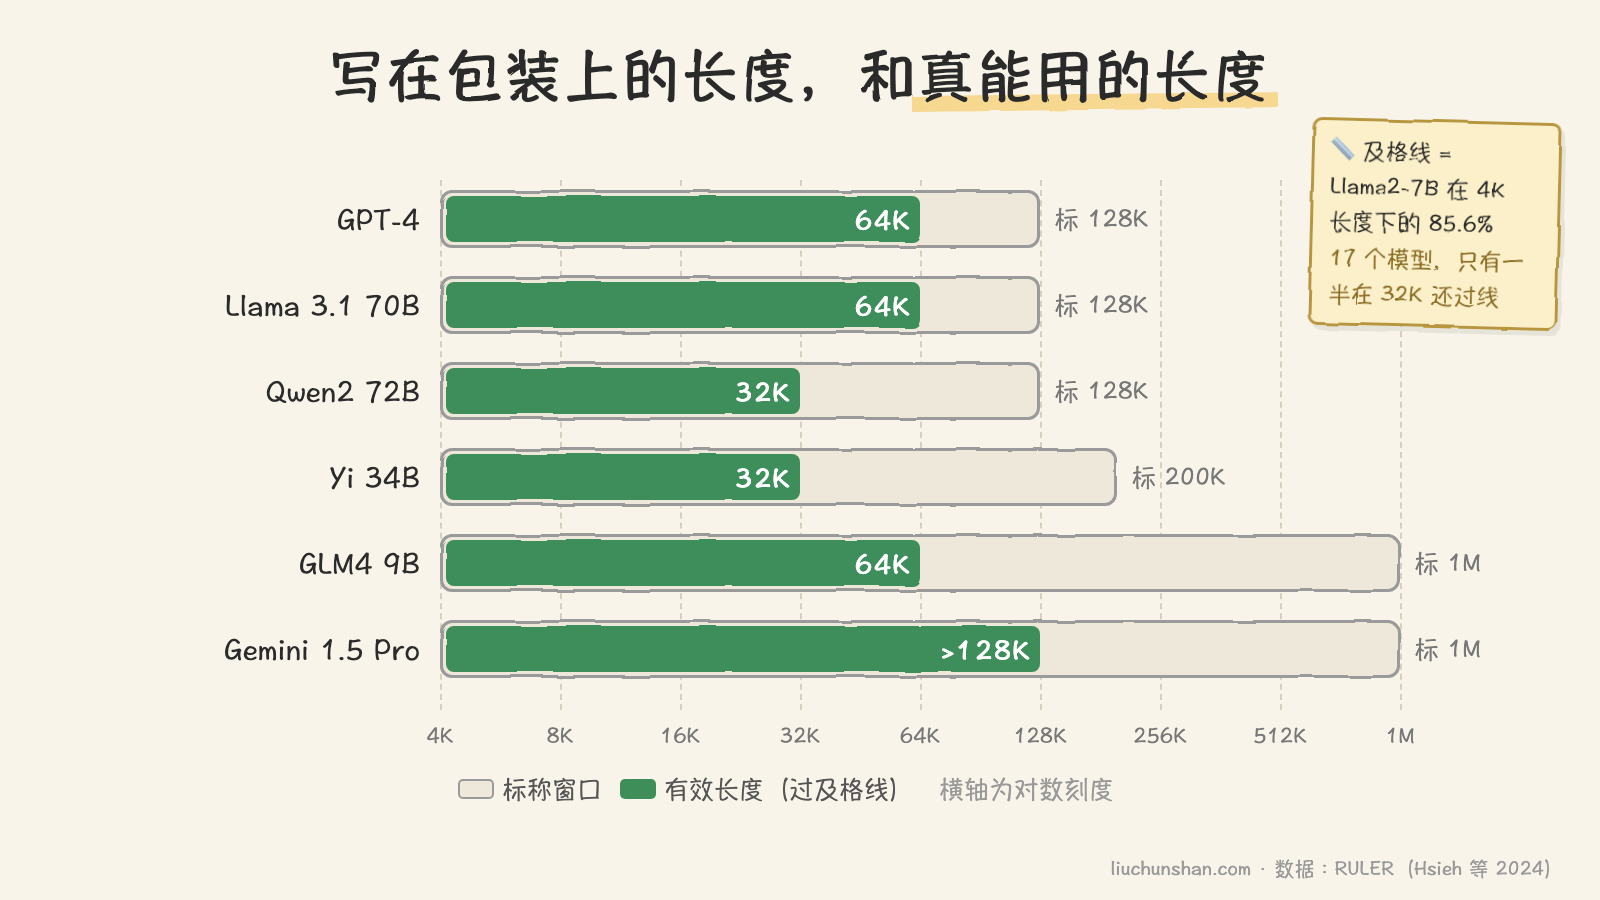
英伟达 2024 年的 RULER 测试做得更系统:不只捞一根针,还有捞多根针、顺着线索多跳追踪、统计全文里出现最多的词这类要真正”通读”的任务。它定了一个口径:以 Llama2-7B 在 4K 长度下的成绩(85.6%)为及格线,模型在多长的上下文里还能过线,就叫它的”有效长度”。
几组标称和实测放在一起看:
| 模型 | 标称长度 | 有效长度 |
|---|---|---|
| GPT-4 | 128K | 64K |
| Llama 3.1 70B | 128K | 64K |
| Qwen2 72B | 128K | 32K |
| Llama 3.1 8B | 128K | 32K |
| Yi 34B | 200K | 32K |
| GLM4 9B | 1M | 64K |
| Gemini 1.5 Pro | 1M | 超过 128K |
17 个模型,全都标称 32K 以上,其中只有一半在 32K 还能保持及格。Gemini 1.5 Pro 是少数在测到的最长长度上还站得住的。
这些都是一两年前的模型,现在的模型在这类测试上进步了不少。但 2025 年 Chroma 做过一次横向测试,拿 18 个当时的一线模型(Claude、GPT、Gemini、Qwen 几个家族都有)去测,结论是每一个都随输入变长而变差,只是掉得快慢不同。他们给这个现象起了个名字,叫 context rot,上下文腐烂。
他们还测出了两个很有意思的细节。第一,只要放进一句和答案很像、但不是答案的干扰句,成绩就会下降,放得越多掉得越多。第二是个反直觉的结果:把干草堆里的句子打乱顺序、让它读起来前言不搭后语,模型反而比读一篇逻辑连贯的文章时找得更准,18 个模型都是这样。作者对原因没给定论。我自己的理解是,连贯的文章会让注意力被文章自己的上下文牵着走,而打乱之后每句都是孤立的,针反而更显眼。这只是猜测,但它至少说明一件事:长文里的”噪音”不只是占地方,它会主动干扰。
为什么偏偏是开头和结尾
回到那条 U 形曲线。开头和结尾为什么占便宜,目前常见的解释有这么几条,不一定是全部原因,但都有实验支撑。
结尾占便宜,是因为离得近。前面讲 RoPE 时说过,旋转位置编码天然让注意力随距离衰减,隔得越远的两个词,表针夹角越乱,打分越容易互相抵消。GPT 类模型从左往右生成,要开口回答时,离它最近的就是上下文的结尾。问题本身通常也放在最后,和它挨着的内容自然分数高。
开头占便宜,原因有点怪。2023 年一篇论文发现,模型会把大量注意力分数”倒”在最开头的几个词上,哪怕那几个词毫无意义。他们给这个现象起名 attention sink,注意力的”下水道”。原因在于注意力的打分要做归一化(softmax),所有词分到的注意力加起来必须等于 1。一个词如果”其实不需要特别关注谁”,这份注意力也得有个地方放,模型在训练中学会了把它丢给开头那几个每个词都看得见的位置。这套习惯的副作用是:开头的位置天然更受关注。
中间两头不靠。它离结尾远,又不是开头那几个特殊位置,还要和成千上万个词一起分那一份总和为 1 的注意力。上下文越长,每个词平均能分到的就越少,一句和答案很像的干扰句就能把分数抢走。
还有一个训练数据上的原因常被提到:真正需要跨越几万字去关联两处信息的训练样本,比”看看前后几段”的样本少得多。模型长距离的本事练得少,自然不如短距离的扎实。
长窗口该怎么用
知道了这些,用法就有了方向。下面几条是我日常用 Claude 时真在用的,也能和官方建议对上。
文档放前面,问题放最后。Anthropic 的提示词文档里专门写了这一条:长文档(2 万 token 以上)放在提示的最上面,问题和指令放在最后,在他们的测试里回答质量最多能提升 30%,文档越多越复杂效果越明显。原理上面讲了:问题紧挨着结尾,而你最关心的指令在最后,离要开口的位置最近。
先摘引,再作答。同一份文档里还有一条:让模型先把和问题相关的原文句子摘出来,放在一个标签里,再基于这些摘录回答。这一步等于让模型自己先做一遍”捞针”,把散在长文中间的关键句搬到结尾附近,后面作答时注意力就好找了。Claude 2.1 那个 27% 到 98% 的例子,本质上也是这个道理。
能少塞就少塞。Chroma 那次测试里有一组对比很说明问题:同一批问题,只给相关的约 300 个 token,和把 11 万多个 token 的完整对话历史全塞进去,所有模型都是前者明显更准。这也是为什么窗口到了 100 万,RAG(先检索再生成)也没有被淘汰:检索的价值不在于”装不下所以要挑”,而在于”挑过的比全给的准”。
多份文档要分隔清楚。几份材料一起给时,每份用标签包起来并写明来源,比如 <document> 里放 <source> 和 <document_content>。这样模型更容易分清哪句话出自哪份,减少张冠李戴。
重要的规矩别埋在对话中间。这是我自己踩出来的。和 AI 聊一个长任务,第 5 轮随口说的”别改测试文件”,到第 50 轮时它已经在几万字的中段了,被忽略的概率很大。我现在的做法是把这类长期有效的规矩写进项目说明文件(Claude Code 里是 CLAUDE.md),它每次都被放在上下文的最前面;一个会话拖得太长、开始出现”它怎么又忘了”的迹象,就压缩一下或者干脆开个新会话,把要点重新交代一遍。把规矩从中间挪到两头,比反复提醒管用得多。
一点看法
窗口大小是容量,不是注意力。一个标 100 万 token 的模型,意思是它”能读完”100 万 token,不是它”能记住”100 万 token 里的每一句。这和人读一份两百页的材料很像:开头认真看,结尾印象深,中间几十页快速翻过,问到中间某个细节,你也得回去翻。
区别在于,人知道自己没细看,会说”我回去查一下”;模型不会,它会凭一个模糊的印象给你一个很确定的答案,或者干脆当那段内容不存在。所以长窗口带来的最大改变,不是我们可以不再挑选资料了,而是挑选这件事可以做得更粗一点、更晚一点。该挑的还是要挑,该放在两头的还是要放在两头。
参考:
- Nelson F. Liu 等,Lost in the Middle: How Language Models Use Long Contexts,arXiv 2307.03172,TACL 2024
- Greg Kamradt,LLMTest_NeedleInAHaystack,GitHub,2023
- Anthropic,Long context prompting for Claude 2.1,2023
- Ali Modarressi 等,NoLiMa: Long-Context Evaluation Beyond Literal Matching,arXiv 2502.05167,2025
- Cheng-Ping Hsieh 等,RULER: What’s the Real Context Size of Your Long-Context Language Models?,arXiv 2404.06654,2024
- Kelly Hong 等,Context Rot: How Increasing Input Tokens Impacts LLM Performance,Chroma,2025
- Guangxuan Xiao 等,Efficient Streaming Language Models with Attention Sinks,arXiv 2309.17453,2023
- Anthropic,Prompting best practices(Long context prompting 一节),Claude 文档
评论