笔记本跑得动 30B 的模型,是因为每个字只算了 3B:MoE 讲人话
今年在本地跑模型的人多半试过 Qwen3-30B-A3B:名字里写着 30B,在一台笔记本上出字的速度却和 3B 的小模型差不多,聪明程度又明显不是 3B 的水平。这篇讲清楚 MoE(混合专家)为什么能做到:模型的参数分成两本账,总参数决定要占多少显存,激活参数决定每个字要算多少;每一层把一个大的前馈网络拆成一百多个"专家",每个字进来只挑 8 个用,DeepSeek-V3 的 671B 就是这样只算 37B 的。也讲三件容易想歪的事:这些专家并不是按学科分工的,Mixtral 的路由分析里 arXiv 论文、医学摘要、哲学文章挑的专家几乎一样;显存照样要装下全部专家,因为下一个字可能挑别的;自己一个人用能省算力、给几百人同时用就全然是另一回事,DeepSeek-V3 解码要 320 张卡一卡一专家。最后是训练里最要命的坑:路由会"富者越富",把所有字都塞给同几个专家,以及两代人怎么按住它。
今年在本地跑大模型的人,多半试过 Qwen3-30B-A3B。我第一次在笔记本上跑它的时候有点懵:名字里写着 30B,出字速度却和一个 3B 的小模型差不多,回答质量又明显不是 3B 的水平。再一看内存占用,量化到 4 位之后还是 18 GB 上下,这又是 30B 的体量。
一个模型,占内存像 30B,跑起来像 3B。名字里的 A3B 就是答案:A 是 activated,激活。这篇讲它为什么能这样,也讲几件我自己一开始想错的事。
参数分成两本账
先说普通模型是怎么算一个字的。一个稠密模型(dense model)里,每个字进来,逐层过去,每一层的每一个参数都要参与一次乘加。所以 30B 参数的模型,每个字就要做 30B 量级的乘加,占的显存也是 30B 参数的体量。两本账是同一个数。
MoE(Mixture of Experts,混合专家)把这两本账拆开了。改动只在一个地方:Transformer 的每一层里有一个前馈网络(FFN,可以粗略理解成每层里”记知识、做变换”的那一大块,参数占了每层的大头),MoE 把这一块换成一排小得多的前馈网络,每个叫一个专家,再配一个路由器(router,一个很小的打分网络)。每个字走到这一层时,路由器给所有专家打分,只挑分最高的几个让它过,其余的专家这一次不动。
于是两本账分开了。总参数是所有专家加起来的体量,决定显存要装多少;激活参数是一个字实际经过的那几个专家,决定每个字要算多少。
几个常见模型的两本账长这样:
| 模型 | 总参数 | 每个字激活 | 每层专家数 | 每个字挑几个 |
|---|---|---|---|---|
| Mixtral 8x7B | 46.7B | 12.9B | 8 | 2 |
| Qwen3-30B-A3B | 30B | 3B | 128 | 8 |
| Qwen3-235B-A22B | 235B | 22B | 128 | 8 |
| DeepSeek-V3 | 671B | 37B | 1 共享 + 256 | 8 + 共享 |
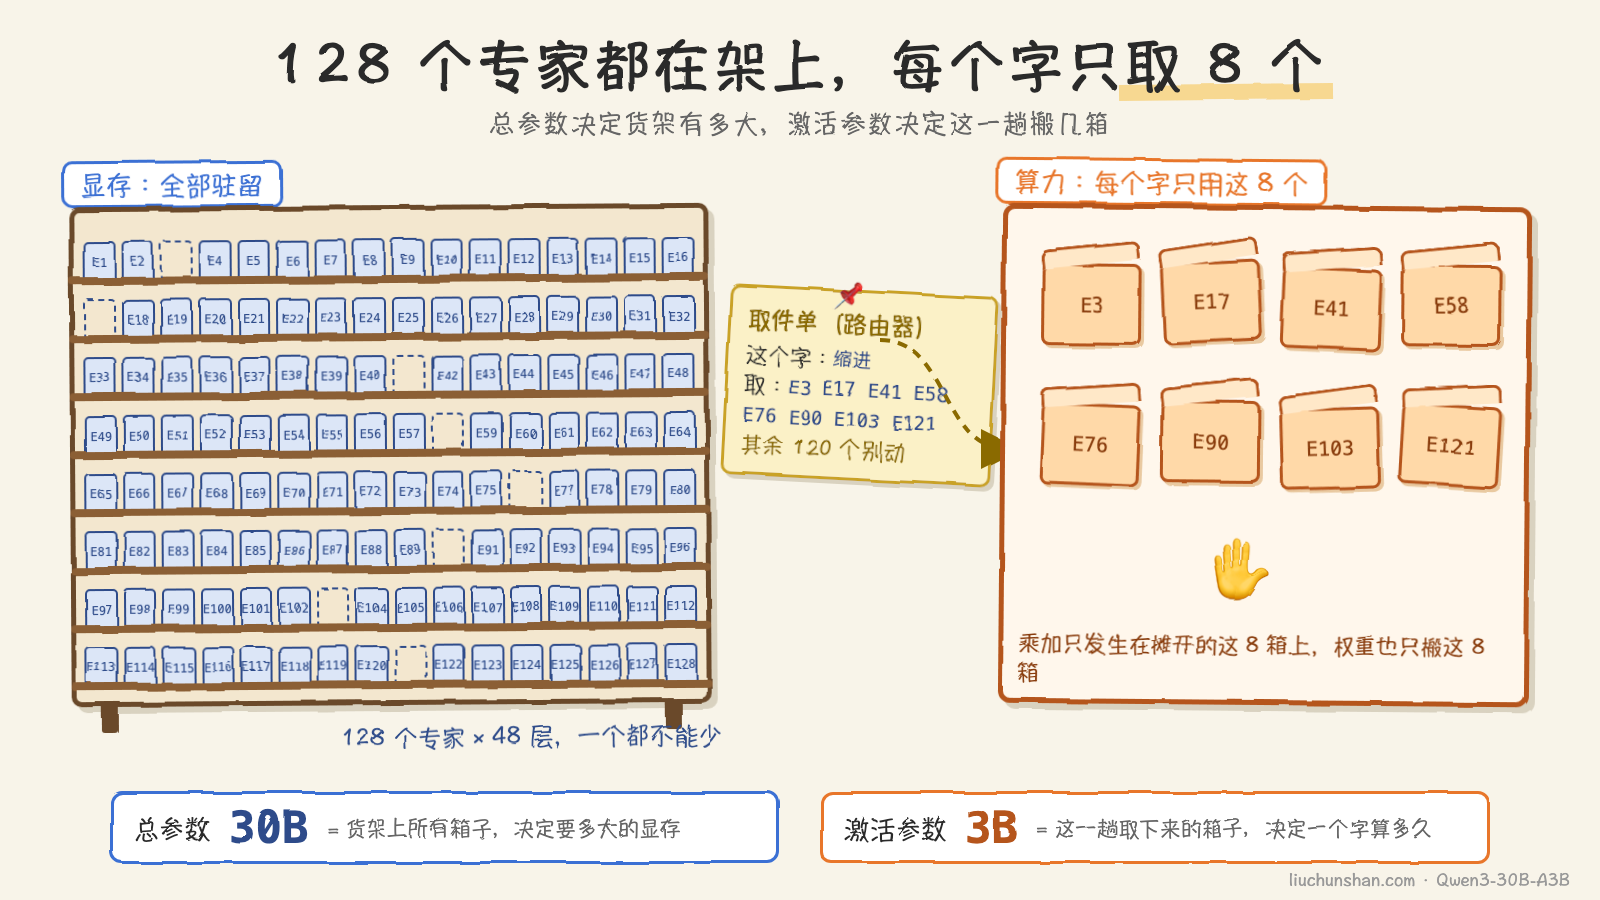
Mixtral 那篇论文说得最直白:每个字能接触到 47B 参数,但只用 13B 算。Mistral 的发布博客把这句话再翻译了一层:它处理输入和生成输出的速度与成本,和一个 12.9B 的模型一样。而在大多数评测上,它比 Llama 2 70B 强,激活参数只有后者的五分之一。
这种做法为什么划算,Google 2021 年那篇 Switch Transformer 给过一个干净的数:在每个字的计算量完全相同的前提下,把 T5 改成稀疏专家结构之后,预训练达到同样质量的速度最多快了 7 倍。同样的算力,参数摊得越开,模型学得越快。今天的旗舰开源模型几乎清一色是 MoE,这个 7 倍是源头。
专家不是专家
我一开始对”专家”两个字的理解是字面的:有的专家管代码,有的管数学,有的管医学,路由器看一眼这个字是干什么的,分派给对口的那个。
Mixtral 的作者也这么猜过,专门做了一组分析。他们拿 The Pile 里不同领域的文本喂给模型,看每个领域的字都被派给了哪些专家。结论用了 surprisingly 开头:看不出专家和主题有什么对应。arXiv 论文、PubMed 医学摘要、哲学文章,挑的专家分布几乎一样,只有一个合成的数学题数据集略有不同,作者认为那是因为它的文本不像自然语言。
那专家在按什么分?按语法。论文里的例子是代码里的缩进:那些空格和制表符总是被派给同一个专家,尤其在第一层和最后一层。还有一个规律是相邻的字爱进同一个专家。随机分派的话,前后两个字碰巧挑到同一个专家的概率是八分之一,12.5%;实测在第 15 层各领域是 25% 到 28%,翻了一倍。
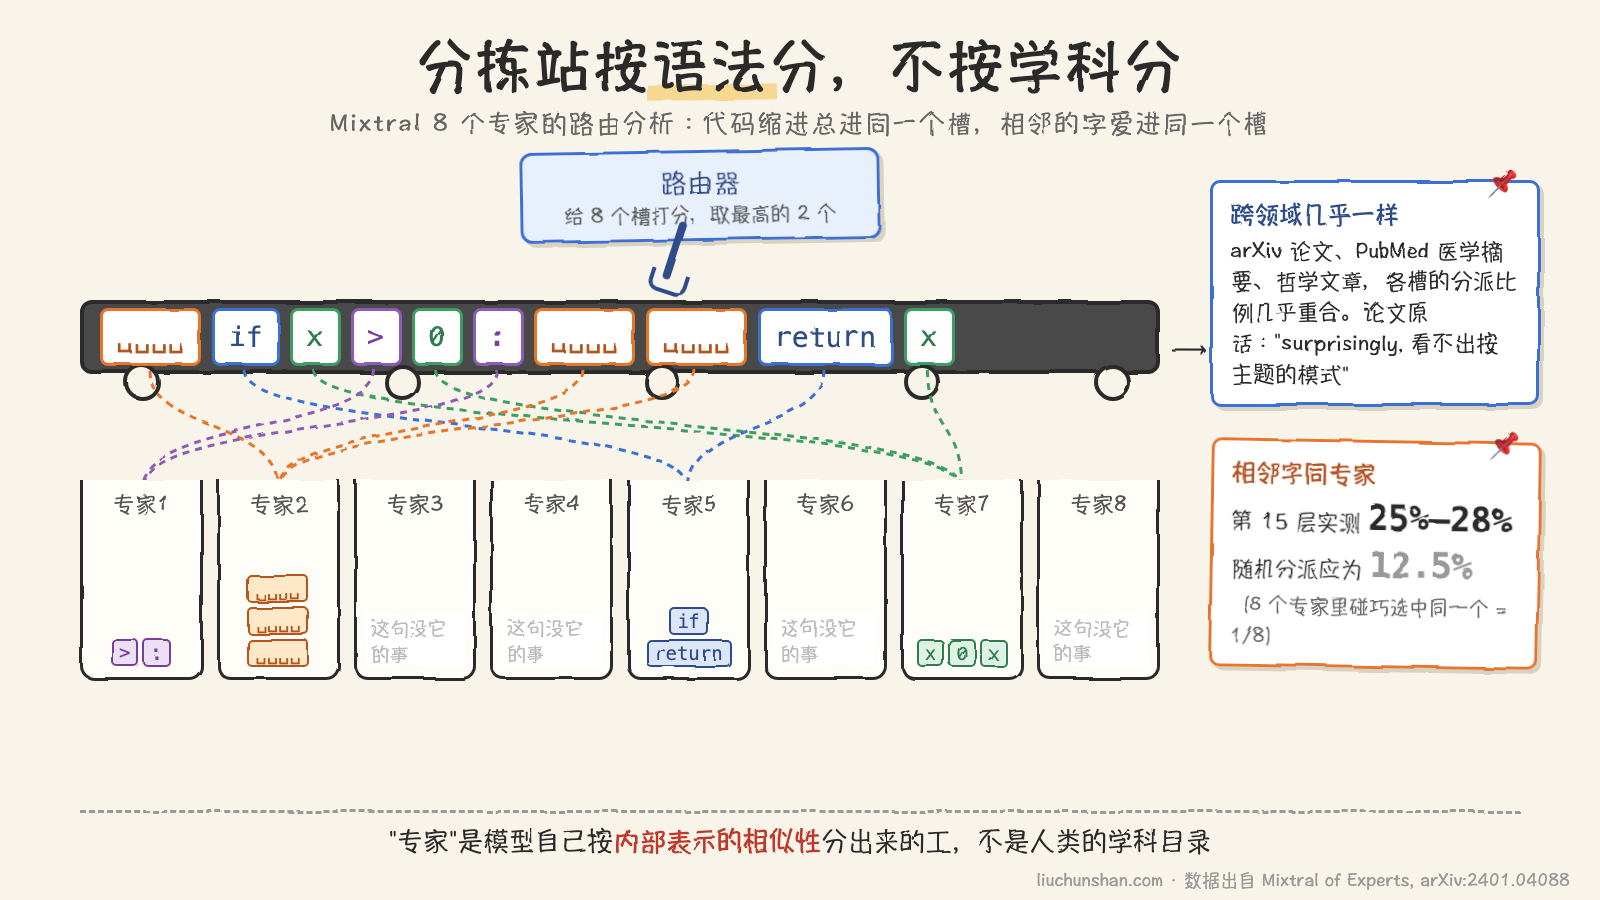
这不是缺点,只是说”专家”这个词起得有点误导。路由器学到的分工是模型自己发现的,按的是它内部表示里的相似性,不是人类的学科目录。
不过这里要补一句,Mixtral 那种一层 8 个专家、每次挑 2 个的切法是粗切。DeepSeek 在 2024 年初那篇 DeepSeekMoE 论文里正是冲着这个问题去的:专家切得太粗,一个专家里塞了很多不相干的知识(他们叫知识混杂),几个专家又各自记了一遍公共知识(知识冗余)。他们的改法是两条,把专家切细、数量增多,每次多挑几个组合起来;再单独留一个共享专家,所有字都过,专门装公共知识,让其他专家可以只管自己那一小块。DeepSeek-V3 的 1 个共享加 256 个路由专家就是这条路走到后来的样子,Qwen3 的 128 个专家也是细切,只是没留共享专家,改用一个按全局批次算的负载均衡损失,论文里写明目的就是鼓励专家专业化。所以更准确的说法是:粗切的时候看不出专业化,后来的架构是专门为了让它专业化改的。
显存照样吃满,速度却快
回到开头的困惑:为什么占内存像 30B,跑起来像 3B。
跑起来像 3B 好理解,每个字只经过 8 个专家,算的量就是 3B 的量。而且我前几天写投机解码时讲过,出字这一段真正的瓶颈是把权重从显存搬到计算单元,不是算。一个字只挑 8 个专家,只有这 8 个专家的权重需要搬,搬的量也是 3B 的量。所以单人使用时,它的出字速度就是一个 3B 稠密模型的速度。
占内存像 30B 也好理解:你不知道下一个字会挑哪 8 个专家,所以 128 个都得在显存里候着。Mixtral 论文里说得很明确,服务它的显存成本正比于总参数 47B,而不是激活的 13B。
我一开始没想到的是第三件事:这个省算力的好处,只在你一个人用的时候是完整的。一个字挑 8 个专家,一百个字同时进来,128 个专家几乎每个都会被挑到,权重还是要全搬一遍。Mixtral 论文里有一句话点破了这个:在一张卡上跑多个专家会增加显存加载的开销,所以 MoE 更适合批量的负载。
大规模服务的解法是把专家摊到很多张卡上,每张卡只管几个专家,字按路由结果在卡之间传来传去,这叫专家并行。DeepSeek-V3 报告里给的部署数很能说明问题:预填充阶段最小的部署单元是 4 台机器 32 张卡,专家并行 32 路;解码阶段最小部署单元是 40 台机器 320 张卡,专家并行 320 路,一张卡只放一个专家,另外拿 64 张卡放冗余的热门专家和共享专家。这时候瓶颈变成了字在卡之间的传输:他们限制每个字最多只发到 4 台机器,因为机器之间的 InfiniBand 是 50 GB/s,机器内部的 NVLink 是 160 GB/s,跨机器的传输要省着用。
所以”MoE 推理更便宜”这句话要看谁在用。自己在笔记本上跑一个 A3B,便宜是真的;给几百人同时提供服务,便宜的是训练和总算力,工程上要多付出一整套专家并行和通信优化。
训练里最要命的坑:富者越富
路由器是学出来的,它和专家一起训。这里面有一个从 2017 年就被指出的正反馈:某个专家一开始碰巧多学了一点,路由器就更愿意把字派给它,它学得更多,路由器更愿意派。最后是几个专家忙死,大部分专家闲着,模型退化成一个小得多的稠密模型。这叫路由塌缩。
Switch Transformer 的处理办法是加一个辅助损失:训练目标里额外惩罚分派不均,逼路由器把字摊开。同时给每个专家定一个容量,一批字里派给某个专家的数量不能超过它的容量,超出的字这一层直接跳过,走残差连接原样传到下一层。他们实测丢弃的字通常不到 1%,而且强调把丢弃率压低对训练效果很重要。
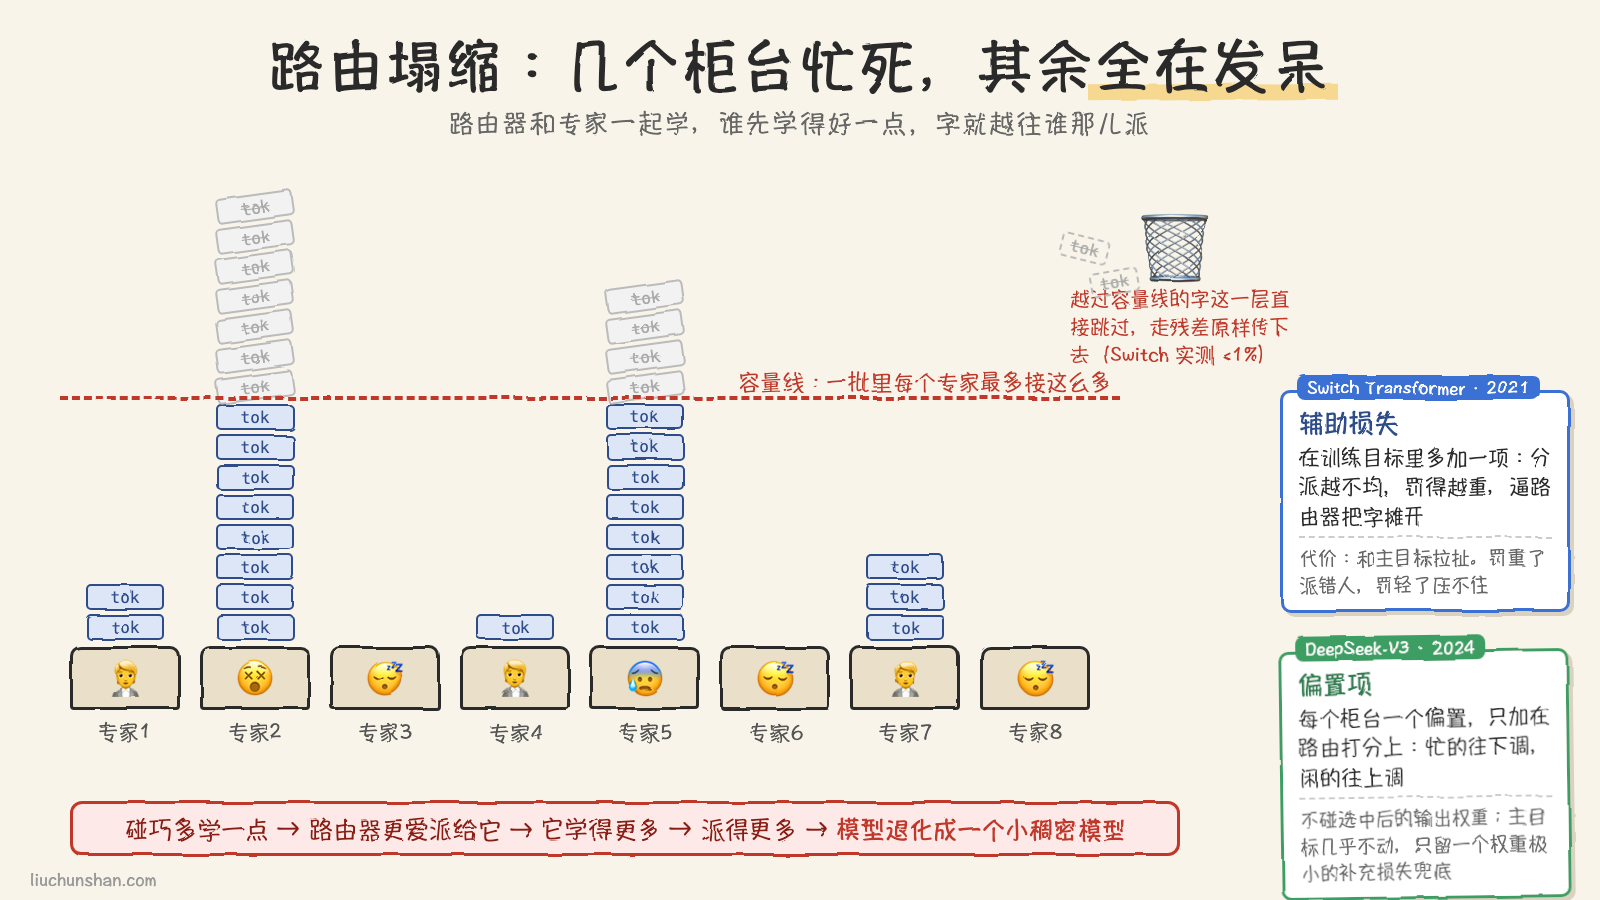
辅助损失有个代价:它和主目标拉扯。罚得太重,路由器为了均匀会把字派给不合适的专家,模型质量下降;罚得太轻,又压不住塌缩。DeepSeek-V3 的做法是主要不靠辅助损失:给每个专家配一个偏置项,只在路由打分时加上去,忙的专家偏置往下调,闲的往上调,每一步训练根据实际负载更新。这个偏置只影响挑谁,不影响挑中之后专家的输出权重,所以主训练目标几乎没被动。报告里还留了一个权重极小的补充损失,作者说只是为了避免单个序列内出现极端失衡。顺带一提,他们说整个训练过程没出现过不可恢复的损失尖峰,也没回滚过一次。
这一整套的意义在最后一个数字上:DeepSeek-V3 总参数 671B,完整训练用了 278.8 万个 H800 卡时,按每卡时 2 美元算是 558 万美元。一个 671B 的稠密模型不可能是这个价,因为它每个字只算 37B。
和蒸馏、量化的分工
前两天写量化和蒸馏时我都说过一句”把模型变小”,MoE 不是第三种变小的办法,它是反着来的:把模型变大,但让每个字只用其中一小块。
三者可以叠。今天你从下载页拿到的 Qwen3-30B-A3B-Q4_K_M 这个名字里就叠了两层,MoE 决定了 30B 里每个字只算 3B,量化决定了 30B 存成 18 GB。Qwen3 的小尺寸稠密模型又是从 235B 的 MoE 大模型蒸馏出来的,昨天讲的那条线也接上了。
我的看法
我以前觉得 MoE 是一种”省钱的取巧”,用更少的算力假装自己是大模型。看完这几篇论文之后我觉得这个理解反了。
一个稠密模型的每个参数,在每个字上都要被用一次,不管这个字用不用得上它。这才是浪费。MoE 承认了一个事实:处理”的”这个字和处理一段 Python 缩进,需要动用的知识本来就不一样,让它们各走各的路才是自然的。Switch Transformer 那个 7 倍,说的是同样的算力下模型学得更快,不是同样的质量下算力打折。
代价也很实在:显存不省,路由要防塌缩,多人服务要多一整套专家并行。所以它在两头最合适,一头是有几百张卡的大厂训旗舰模型,另一头是我这样只有一台笔记本、一个人用的。中间那些要自己搭推理服务给几十人用的团队,反而要算一算这笔账。
参考
- Albert Q. Jiang 等, Mixtral of Experts, arXiv:2401.04088, 2024
- Mistral AI, Mixtral of experts, Mistral AI 官方博客, 2023
- William Fedus, Barret Zoph, Noam Shazeer, Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, arXiv:2101.03961, 2021
- Damai Dai 等, DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models, arXiv:2401.06066, 2024
- DeepSeek-AI, DeepSeek-V3 Technical Report, arXiv:2412.19437, 2024
- Qwen Team, Qwen3 Technical Report, arXiv:2505.09388, 2025
评论