小模型抄的不是老师的答案,是老师的犹豫:模型蒸馏讲人话
DeepSeek-R1 发布那天最让我意外的不是 R1 本身,是随手放出来的那批小模型:同一个 32B 底座,自己用强化学习练拿 47 分,抄 R1 的作业拿 72.6 分;1.5B 的小模型在数学竞赛题上拿 28.9 分,比 GPT-4o 的 9.3 高出两倍。这篇讲清楚蒸馏为什么能成立:老师给出的不是"这是 2"而是"95% 是 2、3% 像 3、1.5% 像 7",这份犹豫里的信息量比标准答案大得多,大到 2015 年那个从没见过数字 3 的小网络能认对 98.6% 的 3。也讲清楚容易被混淆的两件事:最出名的那批蒸馏模型其实只抄了整份答案,真正抄犹豫的是 Gemma 2、Qwen3 这类同门蒸馏;抄来的本事为什么偏科;以及 2025 年起走红的 on-policy 蒸馏怎么用十分之一的算力把强化学习比了下去。
去年 1 月 DeepSeek-R1 发布,大家都在看 R1 本身。我当时更在意的是论文末尾随手放出来的那批小模型,名字里都带着 Distill。表格里有两行数字我盯了很久。
第一行:同一个 Qwen2.5-32B 底座,用 R1 那套强化学习自己练,AIME 2024(美国数学邀请赛,高中数学竞赛题)拿 47.0 分;把 R1 写好的 80 万份解题过程拿来抄,拿 72.6 分。第二行:抄出来的 1.5B 小模型拿 28.9 分,比当时的 GPT-4o 高出两倍,后者只有 9.3 分。
自己练不如抄作业,这个结论和我从小受的教育相反。它叫蒸馏(distillation),今天几乎所有你能在手机和笔记本上跑的小模型,背后都有一个大得多的老师。这篇讲它为什么能成立,也讲一个我自己以前没分清的事:蒸馏抄的到底是什么。
老师的犹豫比答案值钱
蒸馏这个词是 Hinton 在 2015 年定下来的。他那篇论文的核心观察,用一个手写数字的例子就能讲清楚。
训练一个识别手写数字的模型,标准做法是给每张图配一个答案:这张是 2,那张是 7。这种答案叫硬标签,非黑即白,一张图只有一个正确项。
但一个训练好的大模型看同一张图时,给出的不是一个答案,是一份打分表:95% 是 2,3% 像 3,1.5% 像 7,剩下的分给其他数字。这份打分表叫软标签。它比硬标签多出来的东西,Hinton 说得很直白:有一种 2 被打成 3 的概率是百万分之一、打成 7 的概率是十亿分之一,另一种 2 正好反过来。这两个数小到对最终答案毫无影响,但它们说的是”哪些 2 写得像 3,哪些 2 写得像 7”。这是老师对整个数据集的相似性结构的理解,硬标签里一个字都没有。
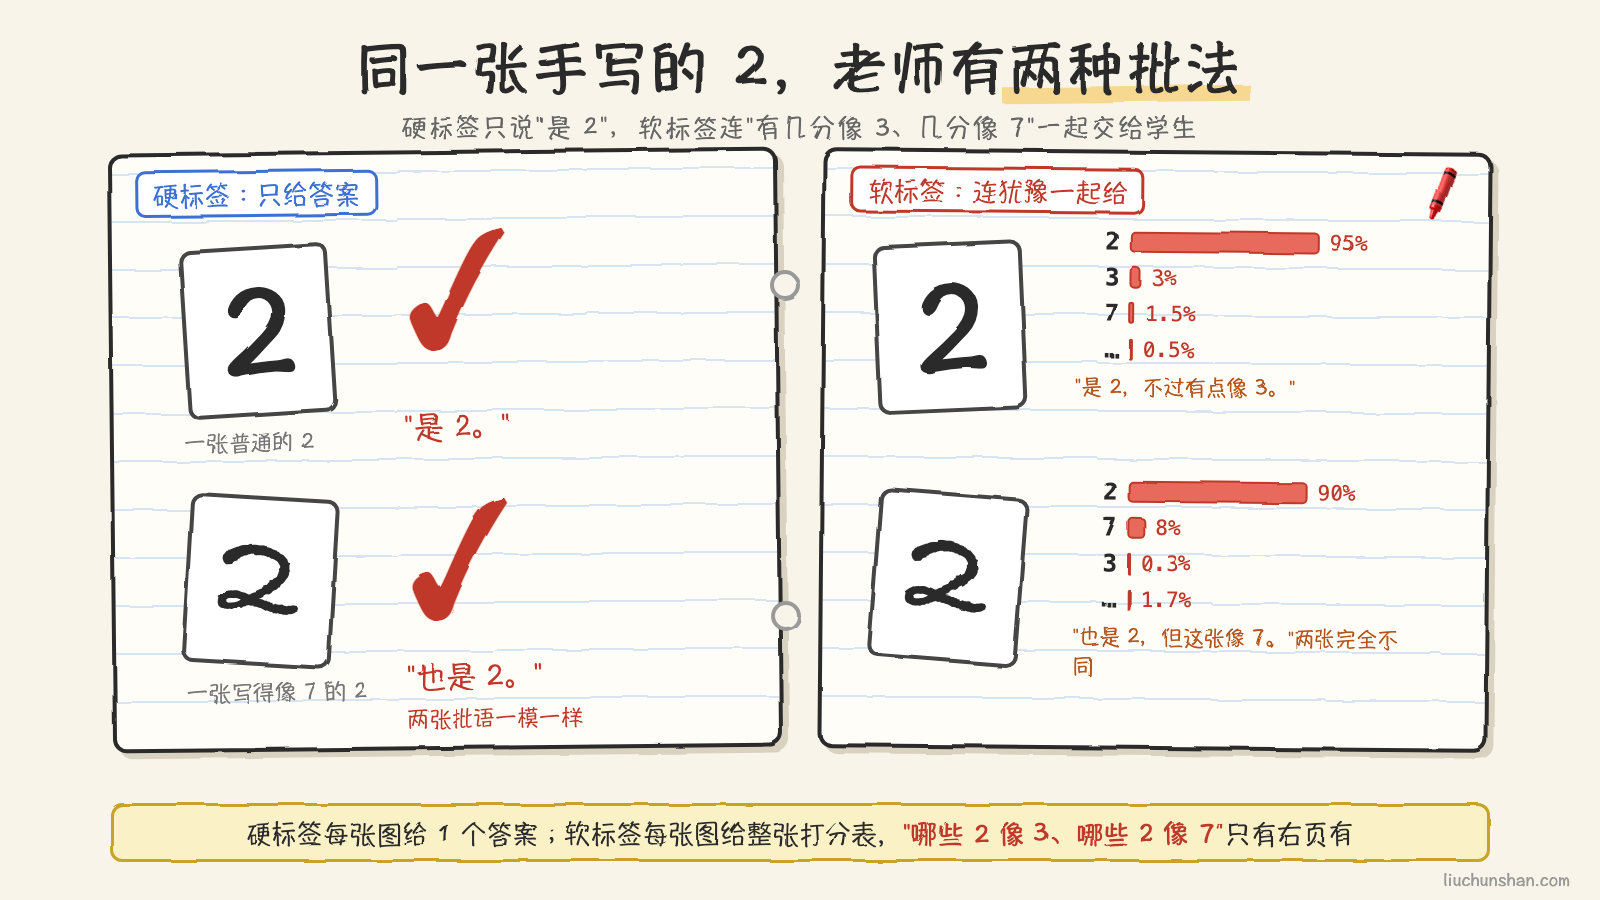
蒸馏做的事就是:让小模型不去拟合硬标签,而去拟合老师的打分表。小模型不需要自己从几万张图里摸索”2 和 7 哪里像”,老师直接把这层理解交给它了。
那篇论文的数字很干净。大网络在 MNIST 测试集上错 67 张,一个没有任何正则化的小网络错 146 张,同一个小网络改为拟合大网络的软标签之后,错 74 张。参数没变,只是换了一份作业,错误少了一半。
真正让我记住这篇论文的是下一个实验。他们把训练集里所有的 3 全部删掉,对小模型来说 3 是一个从没见过的数字。训完之后直接测,它错 206 张,其中 133 张是 3,看起来确实不认识。但错误几乎全来自一个原因:3 这个类别的偏置项太低,模型不敢选它。把这一个偏置手动加 3.5 之后,错误降到 109 张,其中只有 14 张是 3。也就是说,调一个偏置之后,这个从没见过 3 的模型认对了 98.6% 的 3。它是从老师说的”这个 2 有 3% 像 3”、“这个 8 有 5% 像 3”里,把 3 长什么样拼出来的。
顺带说一句,论文里那个 74 张的结果是在”温度 20”下拿到的。这个温度和我前几天写采样温度那篇里的是同一个开关,只是用途相反:采样时调高温度是为了让输出更随机,蒸馏时调高温度是为了把老师打分表里那些百万分之一的小概率放大到小模型看得见的程度。
三种交作业的方式,信息量差几个量级
把蒸馏放回大模型训练的全景里看会更清楚。一个小模型想学会解题,它能从老师那里拿到的反馈大致分三档。
只打分。学生自己写完整道题,老师看一眼,说对或错。这是强化学习的做法。一道题几千个词,换回来一个比特的信息。Thinking Machines 去年那篇讲蒸馏的博客把这件事算得很清楚:强化学习每一轮只教 O(1) 比特,词数再多也是一个对错。
给整份标准答案。老师把自己的解题过程完整写一遍,学生逐字抄。这是 SFT(监督微调)的做法,也是 DeepSeek-R1 那批 Distill 模型的做法。论文里写得很明白:让 R1 生成 80 万条样本,在 Qwen 和 Llama 的底座上微调 2 到 3 个 epoch,没有用到 R1 的打分表。每个词换回来一个确定的正确词,比只打分多了几千倍的信息,但每一步老师的犹豫还是丢了。
每一步都给打分表。老师不只告诉你下一个词该是什么,还告诉你它在这一步认为有 60% 该写”因此”、25% 该写”所以”、剩下的分给了什么。这才是 Hinton 意义上的蒸馏,每个词换回来的是整张词表上的一个分布。同一篇博客的说法是 O(N) 比特,N 是词数。
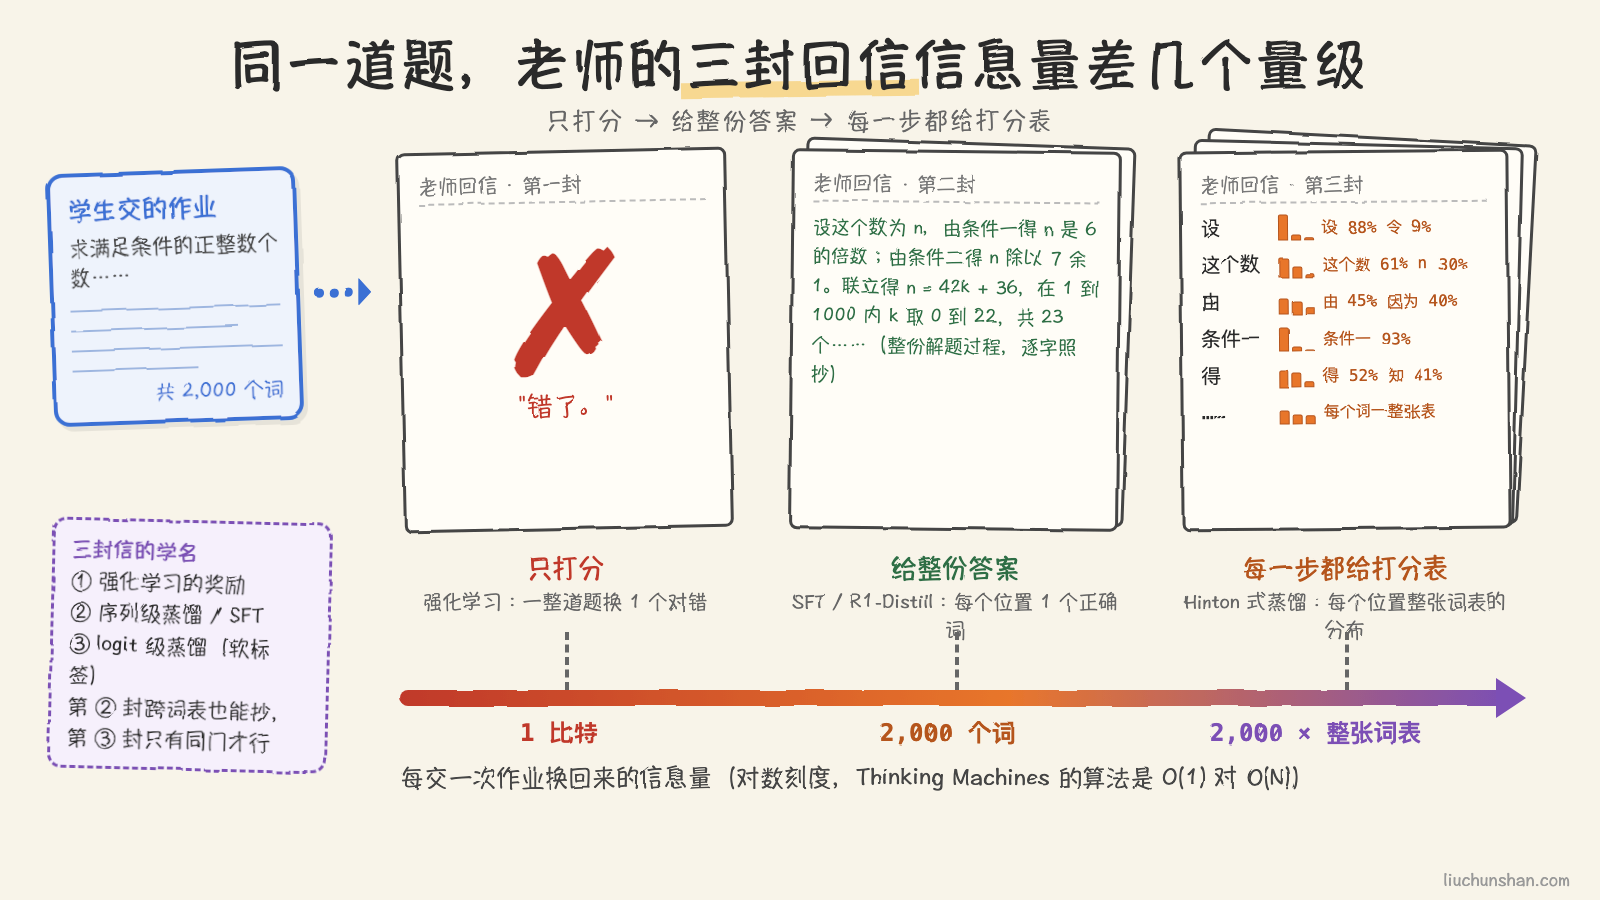
所以标题里那句”抄的是犹豫”要打一个补丁:最出名的那批蒸馏模型其实只抄了答案,真正抄犹豫的是同门的大小模型之间。R1-Distill 之所以只能抄答案,有个很实际的原因:Llama 和 Qwen 的分词器不一样,老师的打分表是按老师的词表打的,学生的词表对不上,压根没法逐词对齐。抄答案只需要文本,谁都能抄。
抄打分表的例子在同一个家族里才有。Gemma 2 训 2B 和 9B 的时候,把每个位置上”下一个词是什么”的独热向量换成了 27B 老师给的整张分布。他们做了一组消融来说明这样做值多少:同一个 2B 模型,训 5000 亿个词,从零训是 60.3 分,跟着 7B 老师蒸馏是 67.7 分(消融用 7B 当老师是为了模拟 27B 到 9B 的比例)。Qwen3 的小模型走的是同一条路,0.6B 到 14B 都是从 32B 和 235B 蒸出来的,训练目标是让学生的 logits(模型最后一层给每个候选词的打分)逼近老师的。
抄来的本事会偏科
蒸馏出来的模型有一个通病:老师教了什么,它就会什么;老师没教的,它比自己练的模型忘得更快。
R1-Distill 是个现成的例子。那 80 万条样本里,数学 39.5 万条,代码 21.1 万条,两项加起来占四分之三。1.5B 和 7B 用的底座干脆就是 Qwen2.5-Math,一个数学专用模型。论文自己在附录里承认,几乎全是单轮对话,多轮能力受限。所以你拿 R1-Distill-Qwen-7B 去解竞赛题很惊艳,拿它当日常助手用会觉得它有点一根筋,这不是 bug,是它的作业本里就只有这两门课。
偏科更严重的一种叫灾难性遗忘,Thinking Machines 那篇博客里有一组我觉得很有说服力的数字。他们想让 Qwen3-8B 学会一批内部文档的知识,做法是拿这些文档继续训。训之前,模型在内部知识问答上 18 分,指令遵循 85 分。全用文档训完,知识涨到 43 分,指令遵循掉到 45 分:学会了新东西,把以前会的忘了一半。把文档和通用对话按七三配比再训,知识 36 分、指令遵循 79 分,两头都没保住。
这组数字点出了蒸馏的另一面:老师给的分布不只是在教新东西,也是在告诉学生”哪些老本事不能丢”。后面讲 on-policy 蒸馏时会回到这个实验。
抄作业的正确姿势:自己写,老师逐步纠
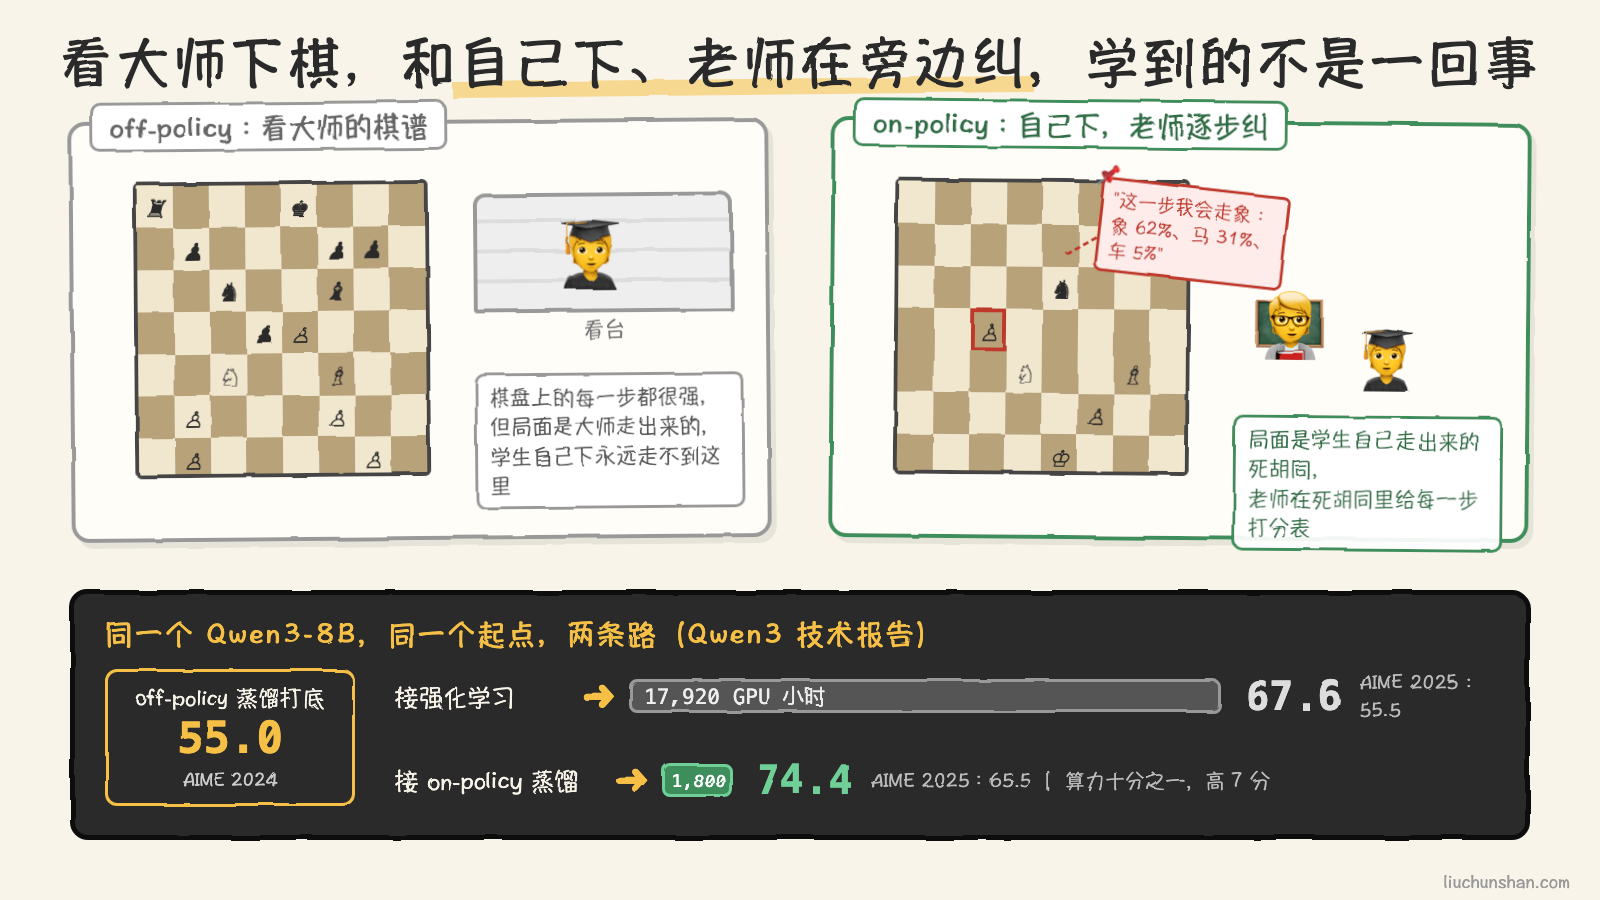
到这里为止讲的蒸馏都有一个共同点:作业是老师写的,学生在老师写出来的文本上学。这种做法有个名字叫 off-policy(离策略),意思是学生学习时看到的局面,是老师走出来的,不是学生自己会走到的。
Thinking Machines 用了一个下棋的比喻,我觉得很准。看大师下棋,你看到的每一步都很强,但那些局面是大师走出来的,你自己下棋根本走不到那里。你真正需要指点的,是你自己会犯的那些错,而那些局面在大师的棋谱里一个都没有。
on-policy 蒸馏(在策略蒸馏)把顺序反过来:学生自己写解题过程,老师在学生写出来的每一个词上给打分表。学生走进自己的死胡同,老师就在死胡同里告诉它”这一步我会怎么走”。这样每一次纠正都落在学生真正会犯的错上。
这个思路 2023 年就有人提出,去年 Qwen3 的技术报告把它做成了小模型的标准流程,并且给了一组对照数。同一个 Qwen3-8B,先用 off-policy 蒸馏打底,AIME 2024 拿 55.0 分。从这里出发,两条路:
| 从 55.0 分出发 | AIME 2024 | AIME 2025 | GPU 小时 |
|---|---|---|---|
| 接强化学习 | 67.6 | 55.5 | 17,920 |
| 接 on-policy 蒸馏 | 74.4 | 65.5 | 1,800 |
分数高了 7 分,算力只用了十分之一。为什么会差这么多?回到三种交作业的方式:强化学习每道题只拿回一个对错,学生要靠几千道题的对错去猜自己到底哪一步错了;on-policy 蒸馏每个词都拿回一张打分表,一道题的反馈密度是前者的几千倍。Thinking Machines 自己复现了一遍,用 Qwen3-8B-Base 做学生,大约 150 步就到了 70 分。
这个办法还顺手解决了前面的偏科问题。回到那个学内部文档的实验:七三配比训完是知识 36 分、指令遵循 79 分。接一轮 on-policy 蒸馏,老师就是原来那个没学过文档的模型自己,学生在自己写的回答上向老师对齐,结果是知识 41 分、指令遵循 83 分。老师没有教任何新知识,它只是把学生忘掉的那部分行为分布重新按了回去,而新学的知识一点没丢。这是 off-policy 做不到的:老师写的作业里没有学生的错,自然也没法纠。
和量化的分工
前几天写量化那篇时,我自己也差点把蒸馏和量化混成一回事,反正都是”把模型变小”。不是,它们动的是完全不同的东西。
量化是同一个模型,参数一个不少,只是每个参数存的精度从 16 位压到 4 位。体积变小,模型的”想法”没变,只是每个想法记得没那么精确。
蒸馏是另起一个小模型,参数量本来就少,然后用大模型当老师教它。它是另一个模型,只是学得像老师。
两者可以叠加,而且今天大多数端侧模型就是这么来的:先从大模型蒸出一个 4B,再把 4B 量化到 4 位。前者决定了模型”会多少”,后者决定了”存多小”。你在下载页看到的 Qwen3-4B-Q4_K_M 这种名字,就是两步各留了一个印记。
昨天投机解码那篇里的草稿模型也和这有关。草稿模型的用处是猜大模型会写什么,猜得越像接受率越高。让一个小模型像大模型,最直接的办法就是拿大模型当老师蒸它,同一个家族的大小模型配对做投机解码效果好,一半原因在这里。
我的看法
我以前对蒸馏有个粗糙的印象:大模型是本体,小模型是缩水版,蒸馏是把本体的能力打折装进小模型。看完这几组数字后,我觉得这个印象错在一个地方。
大模型训练时看到的,是互联网上的硬标签:每个位置上的下一个词就是那一个词,非黑即白。它是从几万亿个这样的非黑即白里,自己慢慢摸出”哪些词彼此相似、哪些表达可以互换”的。这个摸索的过程贵得惊人。
而蒸馏出来的小模型,从第一天起看到的就是老师摸出来的这份相似性结构。它不需要重走那条路。Gemma 2 那个消融里,蒸馏的 2B 用同样的 5000 亿个词多拿了 7 分,不是因为它见了更多数据,是因为同样的数据它每一个词学到的东西更多。
所以蒸馏不是把能力打折,是把老师最贵的那部分认知,用最便宜的方式交给学生。学生拿到的不是老师的答案,是老师看世界的方式。这么想的话,98.6% 那个从没见过 3 的模型就不奇怪了:它没见过 3,但它见过老师看 2 和 8 时眼里的那点 3。
参考
- Geoffrey Hinton, Oriol Vinyals, Jeff Dean, Distilling the Knowledge in a Neural Network, arXiv:1503.02531, 2015
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, arXiv:2501.12948, 2025
- Gemma Team, Gemma 2: Improving Open Language Models at a Practical Size, arXiv:2408.00118, 2024
- Qwen Team, Qwen3 Technical Report, arXiv:2505.09388, 2025
- Kevin Lu 等, On-Policy Distillation, Thinking Machines Lab 博客, 2025
评论