大模型批改 5 个词,和自己写 1 个词一样快:投机解码讲人话
我第一次认真看这个数字是在 DeepSeek-V3 的技术报告里:把训练时顺手长出来的一个小模块拿来做投机解码,吐字速度变成 1.8 倍,模型一个参数没动。再往前翻,Google 2022 年的原始论文是 2 到 3 倍,DeepMind 在 700 亿参数模型上是 2 到 2.5 倍,三家都强调"输出和原来一样"。这篇讲它为什么不是魔法:一个 700 亿参数的模型每吐一个词要从显存搬 140 GB 权重、耗时 42 毫秒,而算这个词只要 0.14 毫秒,算力 99% 的时间在空转;既然权重非搬不可,一趟搬上来批改 5 个草稿词和自己写 1 个词的代价几乎一样。小模型起草、大模型一次前向批改、错处剪断重来是怎么运作的,为什么数学上能证明输出分布一个数都不变(以及浮点噪声这条边界),接受率从 0.5 到 0.9 换来的倍数差多少,草稿来源怎么从外挂小模型一路演化到 Medusa、EAGLE 和长在模型体内的 MTP,最后讲高并发下它为什么反而是累赘。
我第一次认真看这个数字是在 DeepSeek-V3 的技术报告里。报告最后一节说,把训练时顺手长出来的一个小模块拿来做投机解码(speculative decoding),吐字速度变成 1.8 倍,模型本身一个参数没动。再往前翻,2022 年 Google 那篇原始论文是 2 到 3 倍,DeepMind 在 700 亿参数的 Chinchilla 上是 2 到 2.5 倍。三家都强调同一句话:输出和原来一模一样。
同一个模型、同一张卡,快两三倍,答案还不变。这听起来像免费午餐。它确实是,但午餐的钱早就付了,只是以前没人吃。
前提:吐字慢,不是算不过来,是搬不过来
前天讲注意力那篇的结尾提过一句,decode(解码,逐字往外吐的阶段)的瓶颈是搬数据。投机解码的整个道理都建立在这句话上,所以值得把账算清楚。
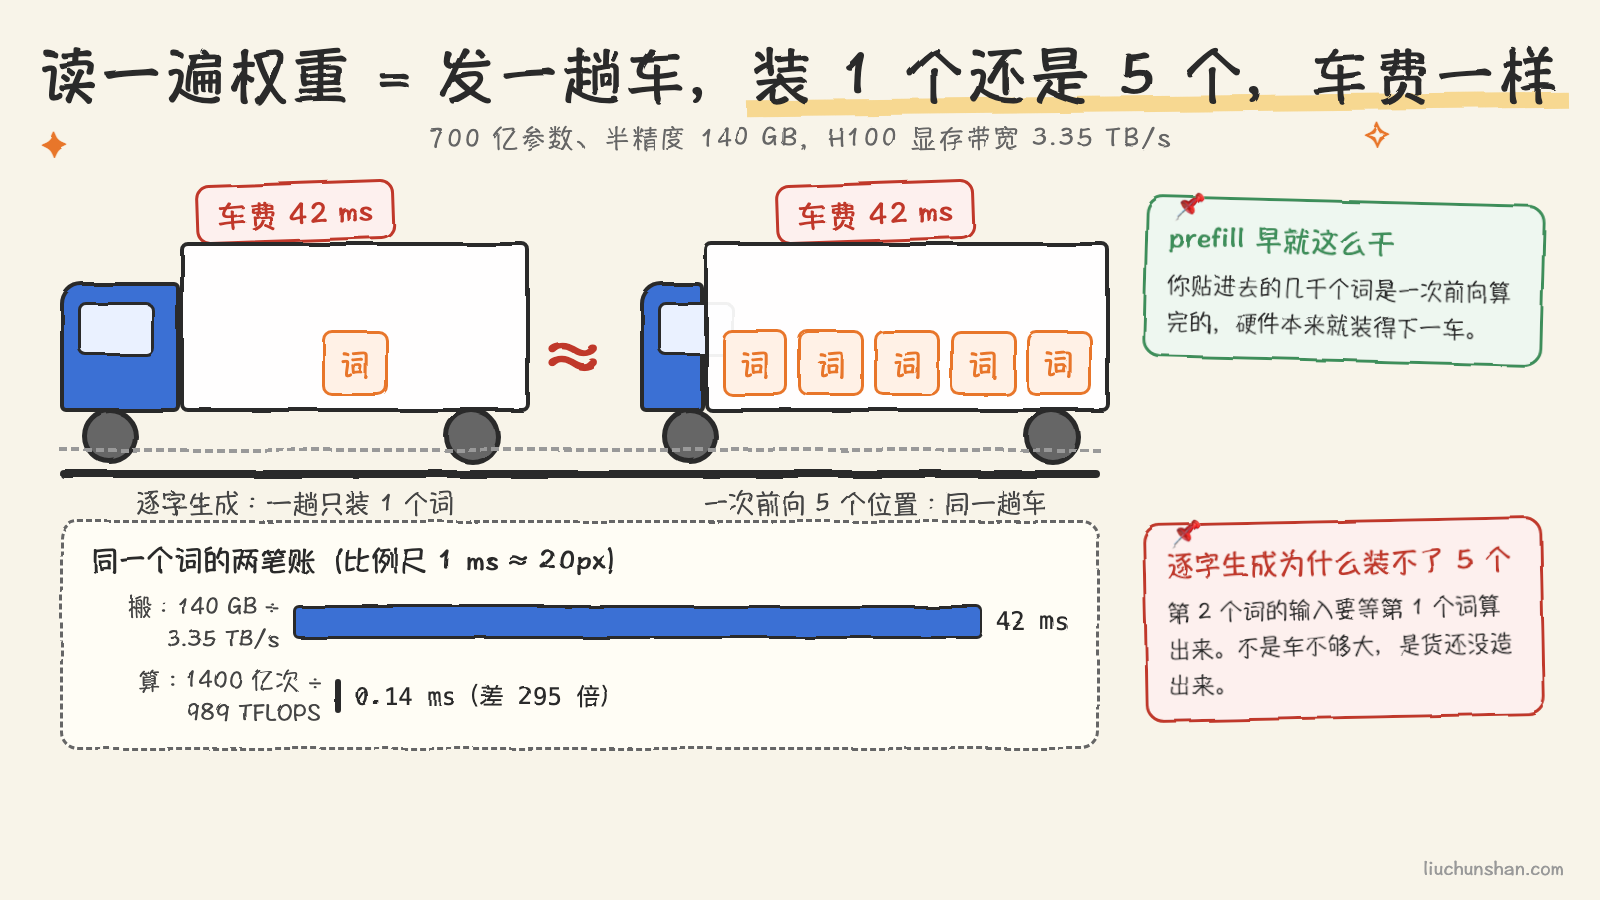
大模型吐字是逐个来的:算出一个词,把它接到输入末尾,再算下一个。每算一个词,模型的全部权重都要从显存里读一遍,因为每一层都得参与。一个 700 亿参数的模型,半精度存放是 140 GB。H100 的显存带宽是每秒 3.35 TB,把 140 GB 读一遍要 42 毫秒。这意味着单个请求的吐字速度有一个硬上限:每秒 24 个词,再快就得换卡。
那算的那部分呢?生成一个词的计算量大约是参数量的两倍,1400 亿次浮点运算。H100 每秒能做接近 1000 万亿次,算完只要 0.14 毫秒。搬要 42 毫秒,算只要 0.14 毫秒,算力有 99% 以上的时间在等数据。
这里藏着一个关键事实:既然权重反正要读一遍,这一遍读上来处理 1 个词还是处理 5 个词,时间几乎一样。5 个词的计算是 0.7 毫秒,在 42 毫秒面前依然可以忽略。其实 prefill(预填充,读你输入的那个阶段)一直就是这么干的,你贴进去的几千个词是一次前向算完的,不是一个一个来。逐字生成之所以做不到,不是硬件不允许,是第二个词依赖第一个词:你不知道第一个词是什么,就没法把第二个词的输入喂进去。
投机解码干的事,就是把这个依赖绕开。
小模型起草,大模型批改
办法说出来很朴素:找一个小得多的模型,让它先猜。
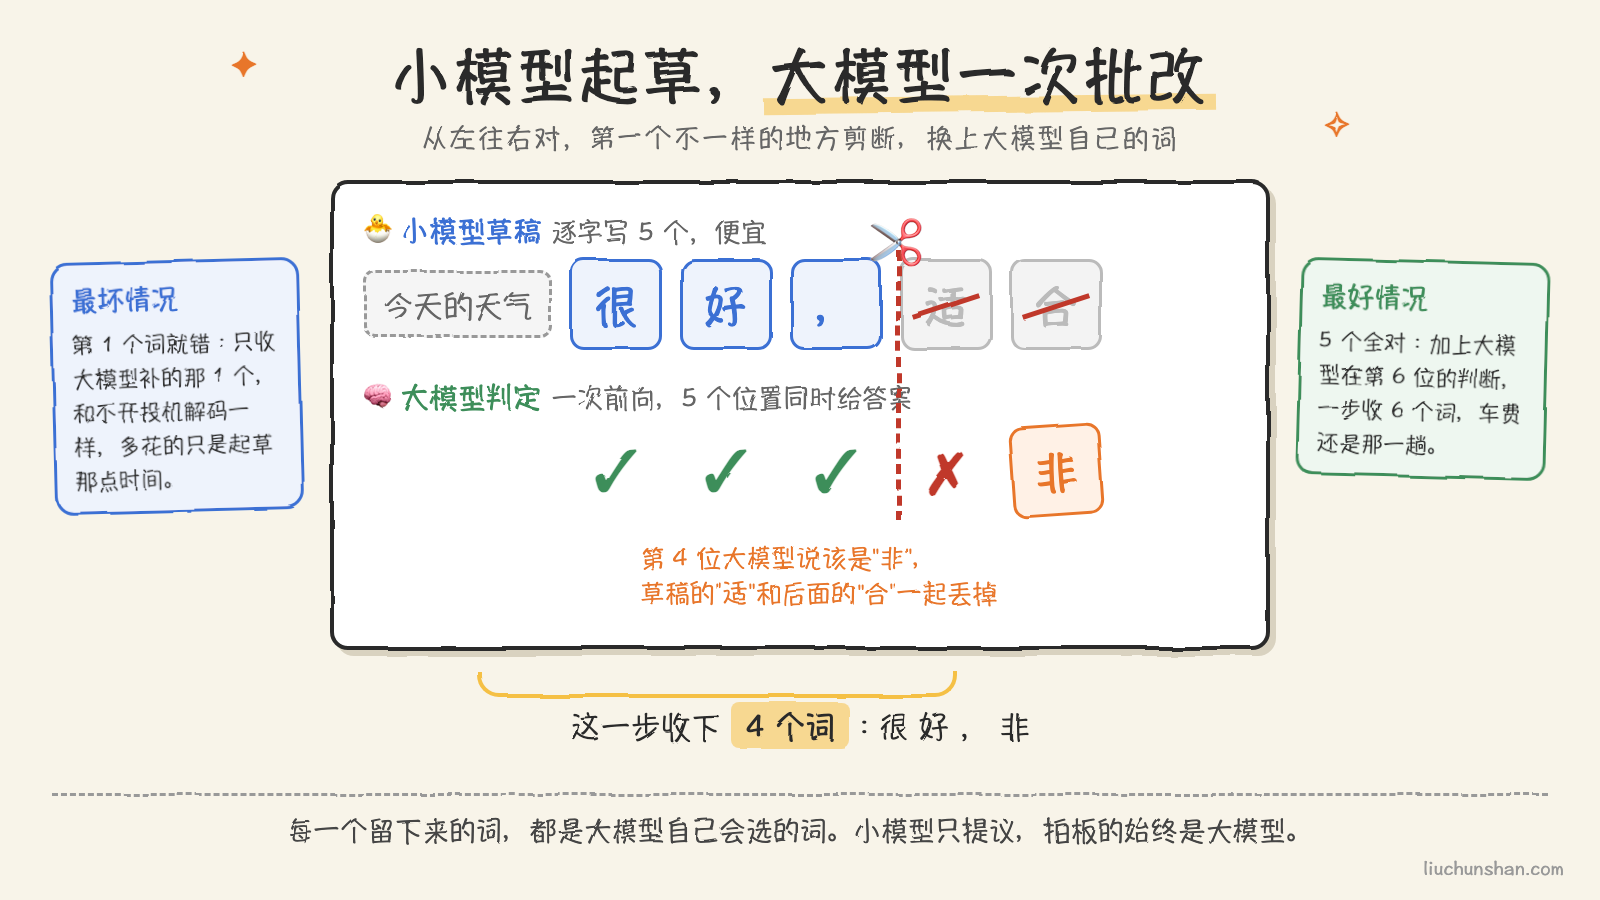
小模型逐字写 5 个词。它便宜,Google 最早的实验里用 6000 万参数的小模型带 110 亿参数的大模型,差了近 200 倍,小模型写 5 个词的时间比大模型写 1 个词还短。然后把这 5 个词一次性接到输入后面,大模型做一次前向。前面说了,一次前向处理 5 个词和处理 1 个词花的时间差不多,所以这一步的代价还是”读一遍权重”。
这一次前向的产出很值钱。大模型在 5 个位置上各给出一个”下一个词该是什么”的判断:看完原文它认为第 1 个词该是什么,看完原文加草稿第 1 个词它认为第 2 个词该是什么,一直到看完全部 5 个草稿词它认为第 6 个词该是什么。拿这些判断和草稿逐个比对,从左往右,一致就收下,遇到第一个不一致的地方停下来,丢掉那个词和它后面的所有草稿,换成大模型自己在这个位置的判断。
所以每一步的收成在 1 到 6 个词之间。最差的情况,草稿第 1 个词就不对,那也白拿了一个大模型自己算出来的词,和不用投机解码一样,只是多花了小模型起草的那点时间。最好的情况,5 个全对,加上大模型在第 6 个位置的判断,一步收 6 个词。
为什么答案不会变
这是最容易被怀疑的一点。小模型明明更笨,为什么它参与了,结果不会被带偏?
先看最简单的情况,也就是 temperature 为 0、每次都取最可能的那个词。这时大模型对每个位置都有一个明确答案。草稿词和它一样才收下,不一样就换成它的答案。所以最终留下的每一个词,都是大模型自己会选的那个词。小模型只是在提议,拍板的始终是大模型。它提得准就快,提得不准就退回到大模型自己的节奏,但永远不会让大模型接受一个它自己不会选的词。
带采样的情况要绕一点。这时大模型对每个位置给的不是一个词,是一个概率分布,比如”下一个词 60% 是猫、25% 是狗、15% 是别的”。小模型也给一个分布,比如”70% 猫、20% 狗”。两篇原始论文的做法是同一个:草稿抽到某个词后,按大模型概率除以小模型概率的比值来决定收不收。大模型觉得这个词比小模型觉得的更可能,就一定收;大模型觉得没那么可能,就按比例有一定概率拒绝。拒绝之后,大模型重新抽一个词,但不是从它原本的分布里抽,是从”大模型比小模型多出来的那部分概率”里抽,专门补小模型低估了的那些词。
这个设计是有意为之的。小模型偏爱的词被打了折扣,小模型低估的词在拒绝后被补回来,两边一加,得到的正好是大模型自己的分布。论文里给了证明:一步接受与拒绝重采样合起来,输出分布和直接从大模型采样完全一致。不是近似一致,是数学上相等。所以”答案不变”严格的说法是”输出的概率分布不变”:temperature 0 时每个字都不变,带采样时每种答案出现的概率不变。
有一条边界要交代。前几天那篇《temperature 调成 0,答案为什么还是会变》讲过,浮点运算的顺序一变,极小概率上最可能的词会翻转。投机解码换了计算的组织方式,一次前向处理多个位置,批次的形状和不开时不同,浮点误差也就不同。DeepMind 那篇论文的措辞很准确,说它”在硬件数值精度范围内保持大模型的分布”。vLLM 的文档更直白:开关投机解码之间输出可能有差异,来源是浮点精度和批次大小,而且不保证每个词的对数概率稳定。算法上零改动,工程上有浮点噪声,两句话都是真的。
这笔账划不划算,看一个数
投机解码快多少,取决于草稿被接受的比例。这个比例通常叫接受率,记作 α。每步起草 γ 个词时,平均每步能收下的词数有个闭式公式,Google 那篇论文里给了。我按 γ 等于 4 算了几档:
| 接受率 α | 平均每步收下 |
|---|---|
| 0.5 | 1.9 个词 |
| 0.7 | 2.8 个词 |
| 0.8 | 3.4 个词 |
| 0.9 | 4.1 个词 |
接受率 0.5 时每步差不多收 2 个词,也就是快接近一倍;接受率 0.9 时每步收 4 个,快接近四倍。真实数字落在这个范围里:Google 在翻译和摘要任务上是 2 到 3 倍;DeepSeek-V3 报告的第二个词接受率是 85% 到 90%,换来 1.8 倍。DeepSeek 只起草 1 个词就拿到 1.8 倍,是因为它一步最多收 2 个,接受率高就贴近上限。
接受率由什么决定?由小模型和大模型在这段文本上有多大程度”想的一样”。代码、JSON、有固定格式的输出、把一段话改写一遍,这类文本下一个词的可预测性高,小模型容易猜中。天马行空的创作,大模型自己每一步的分布都很平,小模型猜中的概率自然低。同一套配置,接受率在不同任务上差一倍很正常。
草稿从哪来:从外挂小模型到长在体内
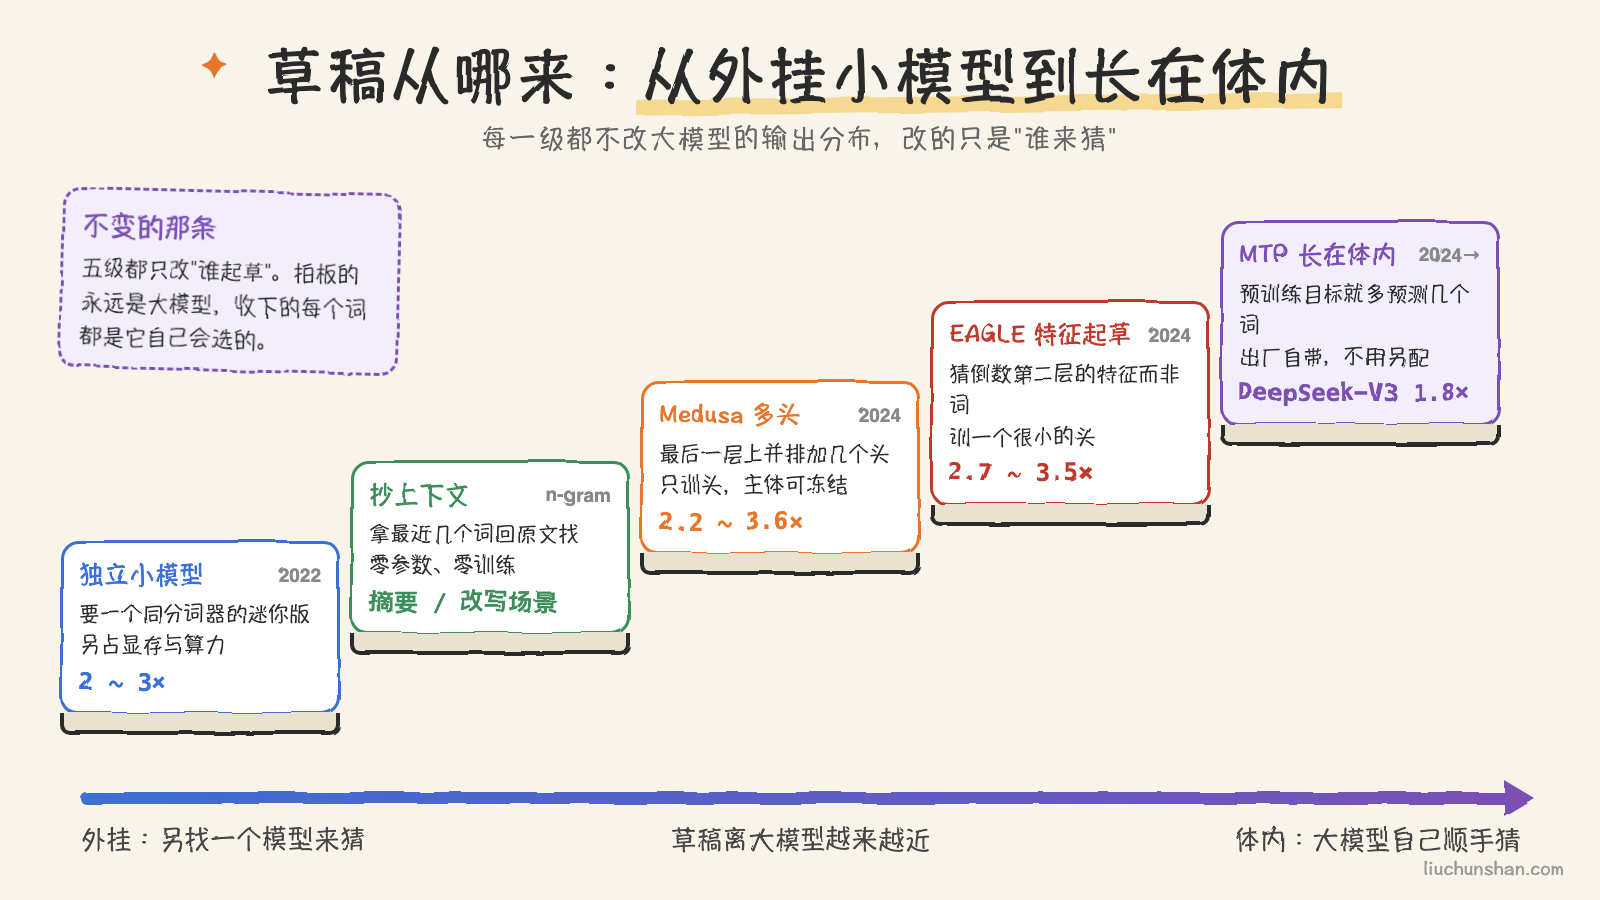
最早的做法需要一个独立的小模型,而且得和大模型用同一套分词器,不然草稿的词大模型根本认不出来。这带来两个麻烦:不是每个模型都有现成的”迷你版”,小模型自己也要占显存和占一份计算。后面几年的工作基本都在解决”草稿从哪来”这一个问题,路线是让草稿离大模型越来越近。
从上下文里抄。最省事的一种压根不用模型:拿最近生成的几个词去原文里找,找到一样的片段就把它后面的几个词抄下来当草稿。摘要、改写、代码补全这种输出大量复用输入的场景,命中率出奇地高,而且零额外参数。vLLM 里叫 n-gram 方式,是最容易开的一档。
给大模型多长几个头。2024 年的 Medusa 不要小模型,在大模型最后一层上面并排加几个小的预测头,每个头负责猜后面第几个词。大模型一次前向,主头出下一个词,附加头顺便把再后面几个词猜了。冻结主体只训附加头的版本快 2.2 倍,连主体一起微调的版本 2.3 到 3.6 倍。
用大模型的中间结果起草。同年的 EAGLE 更进一步,发现直接猜词不如猜大模型倒数第二层的特征向量,特征比词更”顺”,更容易预测。它训一个很小的头,在特征层面上自回归几步,再映射成词。在 700 亿参数的 LLaMA2-Chat 上延迟快了 2.7 到 3.5 倍。
训练时就长在体内。最新的一档是把多词预测(MTP,multi-token prediction)放进预训练目标。Meta 在 2024 年的论文里让 130 亿参数的模型训练时同时预测后面 4 个词,本意是让模型学得更好,结果代码能力确实涨了,HumanEval 多解出 12% 的题;同时这几个预测头天然就是草稿来源,推理最多快 3 倍。DeepSeek-V3 走的就是这条路:训练时多预测 1 个词,推理时这个模块可以直接扔掉,也可以留下当草稿头,就是开头说的 1.8 倍。到 2026 年,新发布的模型技术报告里带 MTP 已经是常态,投机解码从一个部署期的优化,变成了模型出厂自带的东西。
什么时候它反而是累赘
免费午餐的前提是”算力在闲着”。这个前提不总成立。
前面的算账是按单个请求算的。推理服务通常不止服务一个人,几十个请求拼成一批一起做前向,一次读权重就处理几十个词,算力的利用率本来就高了。这时候再给每个请求多算 5 个草稿词,算力已经吃紧,多算的就是净成本,草稿被拒绝的那部分全白干。vLLM 的文档把适用范围写得很清楚:中低并发、受显存带宽限制的场景。高并发下收益会明显缩水,甚至变负。
第二个前提是接受率。上面那张表已经说明,接受率 0.5 只换来不到两倍,再扣掉起草的开销,剩不下多少。让一个通用小模型给一个专业领域的大模型起草,接受率往往上不去。
第三是显存。独立小模型要占显存,验证时 KV cache 也要为多出来的候选位置留空间。显存本来就紧的部署,为了提速反而把并发压小了,得不偿失。
回到那顿免费午餐
写到这里我觉得投机解码最好玩的地方,是它和批处理是同一个想法的两个方向。GPU 读一遍权重的代价是固定的,这一遍读上来能处理的词越多越划算。批处理的办法是攒很多用户的请求,把不同人的词拼成一批;投机解码的办法是给一个用户自己造出一批候选,先猜再验。服务的人多,用前者;服务的人少、每个人都嫌慢,用后者。两条路都是在填同一段空闲,只是一个靠人多,一个靠猜。
所以它不是魔法,也不是免费。那 42 毫秒里 99% 的算力本来就在空转,投机解码只是找到了一种不改答案的方式把它用上。前天算注意力的账时说过,在 GPU 上少搬字节比少做乘法值钱。这篇算是那句话的另一面:既然字节非搬不可,就让每次搬运多干点活。
参考:
- Leviathan 等,Fast Inference from Transformers via Speculative Decoding,arXiv 2211.17192,2022
- Chen 等,Accelerating Large Language Model Decoding with Speculative Sampling,arXiv 2302.01318,2023
- Cai 等,Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads,arXiv 2401.10774,2024
- Li 等,EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty,arXiv 2401.15077,2024
- Gloeckle 等,Better & Faster Large Language Models via Multi-token Prediction,arXiv 2404.19737,2024
- DeepSeek-AI,DeepSeek-V3 Technical Report,arXiv 2412.19437,2024
- Google Research,Looking back at speculative decoding,2024
- vLLM 文档,Speculative Decoding
- 搬运与计算耗时按 NVIDIA H100 公开规格(HBM 带宽 3.35 TB/s、BF16 稠密算力约 989 TFLOPS)自行计算;每步期望词数按 Leviathan 等论文给出的公式计算
评论