"狗咬人"和"人咬狗",注意力算出来一模一样:位置编码讲人话
昨天说注意力是"每个词去问所有词",写完我自己卡住了:这个"问"和词在哪儿没有一点关系。"狗咬人"和"人咬狗"三个词一样,"咬"去问另外两个词拿到的东西一字不差,注意力这一步算出来的"咬"完全相同。那模型怎么知道谁咬谁?答案是顺序不是注意力自带的,是外挂进去的。这篇讲这个外挂怎么装:从 2017 年给每个位置发一张身份证,到现在主流模型用的 RoPE 把词向量当表针转一个角度,为什么"把绝对位置写进去、把相对距离读出来"这句话在数学上成立(我写了十行代码验证);为什么一个头里 64 对表针转速差一万倍,4096 个词里有 9 对连四分之一圈都没转完;以及超过训练长度模型为什么不是慢慢变差而是断崖式说胡话,位置插值、YaRN、Llama 3 把 base 调到 50 万各自是在拧哪个螺丝。
昨天那篇讲注意力,核心一句话是”每个词都去问过所有词”。写完我自己卡住了一个地方:这个”问”,和词在句子里的位置没有一点关系。
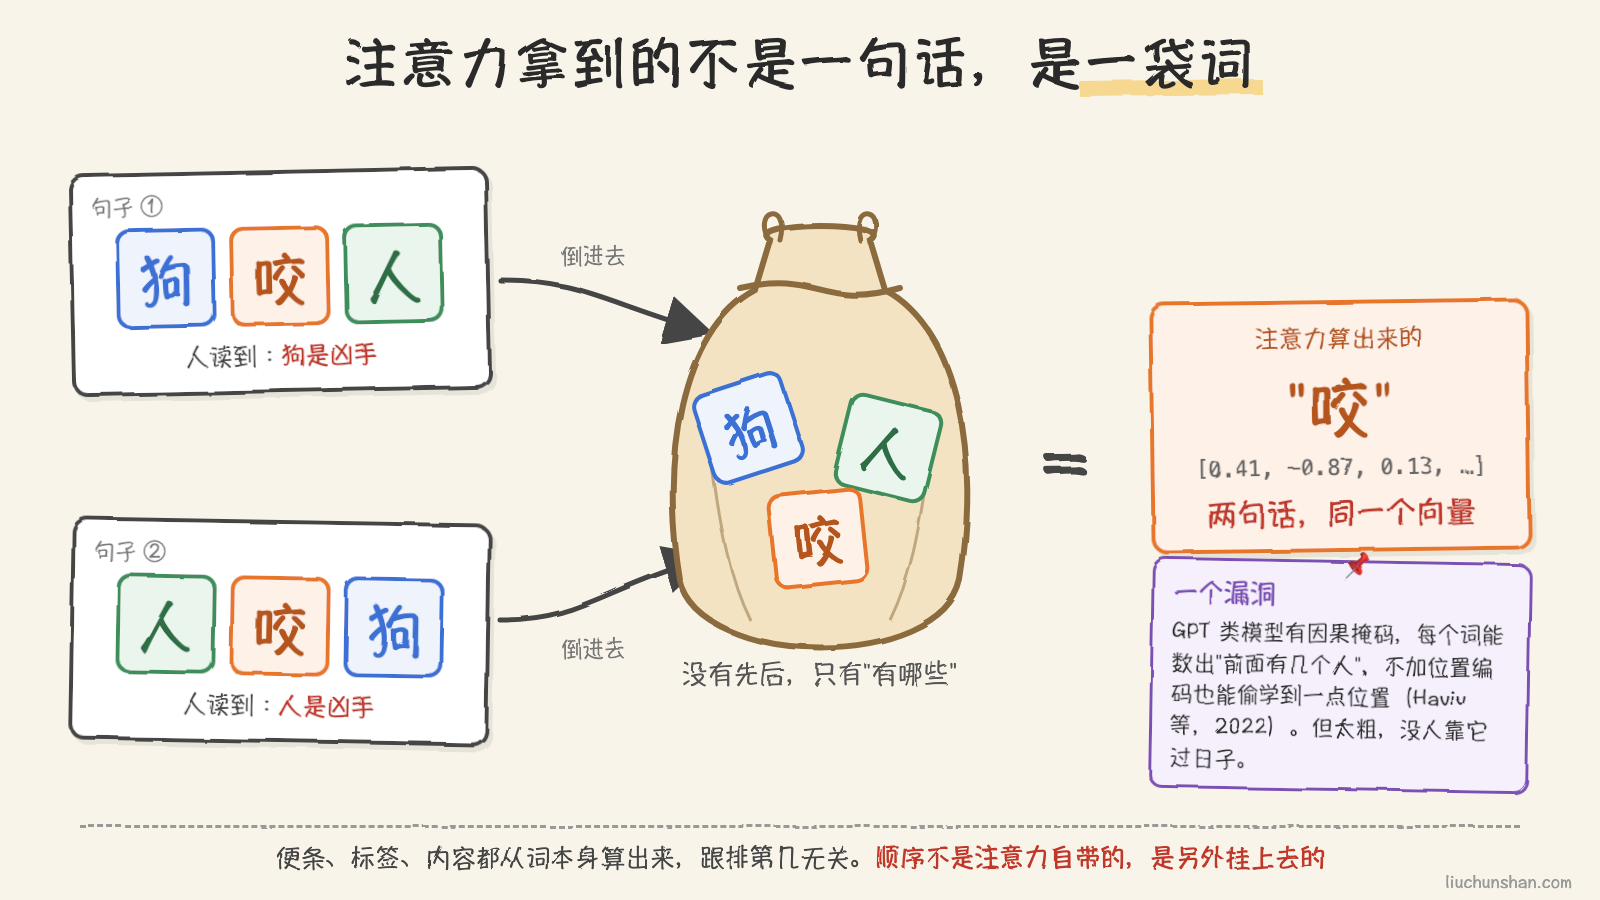
拿”狗咬人”和”人咬狗”来说。三个词一样,只是顺序反了。“咬”要去问”狗”和”人”,它拿出自己的便条(Query,查询向量),去比对两个词的标签(Key,键向量),按分数加权拼两个词的内容(Value,值向量)。便条、标签、内容都是从各自的词向量算出来的,跟这个词排第几没关系。所以在两句话里,“咬”拿到的两份标签一模一样,打的分一模一样,拼出来的结果一模一样。注意力这一步算出来的”咬”,在”狗咬人”和”人咬狗”里是同一个向量。
那模型是怎么知道谁咬谁的?
注意力眼里,句子是一袋词
先把上面那件事说得更硬一点:这不是模型训练得不够好,是数学上的性质。
注意力的输入是一堆向量,输出也是一堆向量。每个输出只依赖两样东西:这个词自己的向量,和其余所有词的向量组成的那个集合。集合没有顺序。你把输入打乱重排,每个词算出来的结果一个数都不变,只是跟着一起换了位置。用行话说这叫置换等变(permutation equivariant),用人话说就是:注意力看到的是一袋词,不是一句话。
这在 Transformer 之前是不存在的问题。RNN(循环神经网络)天生按顺序读,一个词一个词往下走,位置就藏在”读到第几个”里。Transformer 为了并行,把这个顺序读法扔掉了,一次把所有词摊开算。并行是它快的原因,顺序丢失是并行的代价。2017 年那篇论文的作者当然知道这一点,所以位置信息从第一天起就是单独加回去的。这个”加回去”,就是位置编码(positional encoding)。
一个反直觉的漏洞:GPT 其实能偷看到一点
写到这里要诚实地补一条。上面说的”一袋词”,严格成立的是没有遮挡的注意力,也就是每个词能看见所有词的那种。而 GPT 类模型生成文字时用的是因果掩码(causal mask):每个词只能看见自己前面的词,看不见后面的。
这个掩码本身就漏了位置。2022 年有一篇论文专门做了这个实验,把 GPT 类模型的位置编码整个拆掉,什么都不加,训出来的模型居然还有竞争力。作者探测了一下模型内部,发现它自己学出了一套隐含的绝对位置。他们的猜测是:因为有掩码,第一个词看不见任何人,第二个词能看见一个,第 100 个词能看见 99 个,每个词”能看见多少人”就是它的位置。模型把这个数出来了。
所以”注意力完全看不见顺序”这句话,对 GPT 类模型要打个折扣。但没有哪家真的靠这个漏洞过日子:数人头数出来的位置是粗的,而且要靠模型自己去学,长度一变就不准。所有主流模型都明确外挂了位置信息,接下来讲的就是怎么挂。
外挂的几种装法
发身份证。2017 年最早的做法是给每个位置一个固定的向量,直接加到词向量上。第 1 个位置加这一串数,第 2 个位置加另一串,每个位置一张身份证。具体是用不同频率的正弦余弦函数生成的,所以叫正弦位置编码。BERT 和 GPT-2 换了一种:身份证不用公式算,让模型自己学,训练时每个位置一个参数向量。这种可学习的版本有一个硬上限,以 GPT-2 为例,训练时最多到 1024 个位置,第 1025 个位置就没有身份证,压根不能算。
发身份证的毛病在于它给的是绝对位置,而语言里真正要紧的是相对位置。“前一个词是什么""隔三个词那个动词”,这些关系不管句子从第 5 个位置开始还是第 500 个位置开始都一样。身份证方案要靠模型自己从两张身份证里推出距离,学起来费劲,而且推理时遇到没见过的位置就抓瞎。
按距离扣分。2021 年的 ALiBi 干脆不发身份证,在打分那一步动手:两个词隔得越远,注意力分数直接减得越多,减多少和距离成正比。位置不再是加进词向量里的东西,是打分时的一条罚则。它的好处是天然只认距离,训练时在 1024 长度上训的模型,推理时给它 2048 长度,困惑度和一个直接在 2048 上训练的正弦模型一样,还快了 11%。
转表针。这是现在的主流,叫旋转位置编码(RoPE,Rotary Position Embedding),2021 年由苏剑林等人提出,LLaMA、Qwen、DeepSeek 这些你叫得出名字的开源模型基本都用它。它的想法值得单独讲一节。
RoPE:把位置转成一个角度
把一个词的便条向量和标签向量拿出来,比如 128 维,两两一对分成 64 对。每一对看成平面上的一根箭头,或者说一根表针。RoPE 做的事只有一件:这个词排在第 m 个位置,就把它所有的表针都转 m 乘以某个角度。第 1 个词转 1 份角度,第 2 个词转 2 份,第 100 个词转 100 份。
关键在打分那一步。打分是便条和标签做点积,而两根箭头的点积只取决于它们的长度和夹角。便条转了 m 份角度,标签转了 n 份,夹角差的是 m 减 n 份。点积算出来的分数,只和 m 减 n 有关。
换句话说:往向量里写进去的是绝对位置 m 和 n,从分数里读出来的却只有相对距离 m 减 n。这个性质不是训练出来的,是旋转这个几何操作自带的。
我不太相信话说得这么漂亮,写了十行代码验证了一下。取一对随机的便条和标签,每个位置转 0.3 弧度,看不同位置组合下的点积:
import math
q, k, theta = [0.8, 0.3], [0.5, -0.6], 0.3

def rot(v, a):
    return [v[0]*math.cos(a) - v[1]*math.sin(a),
            v[0]*math.sin(a) + v[1]*math.cos(a)]

for m, n in [(3, 1), (10, 8), (103, 101), (5, 1), (20, 16)]:
    q_m, k_n = rot(q, m*theta), rot(k, n*theta)
    print(m, n, m - n, round(q_m[0]*k_n[0] + q_m[1]*k_n[1], 4))
输出是这样的:
| 便条位置 m | 标签位置 n | 距离 m−n | 点积 |
|---|---|---|---|
| 3 | 1 | 2 | −0.1742 |
| 10 | 8 | 2 | −0.1742 |
| 103 | 101 | 2 | −0.1742 |
| 5 | 1 | 4 | −0.5075 |
| 20 | 16 | 4 | −0.5075 |
第 3 个词看第 1 个词,和第 103 个词看第 101 个词,分数一个数都不差。距离一变,分数才变。
64 根表针,转速差一万倍
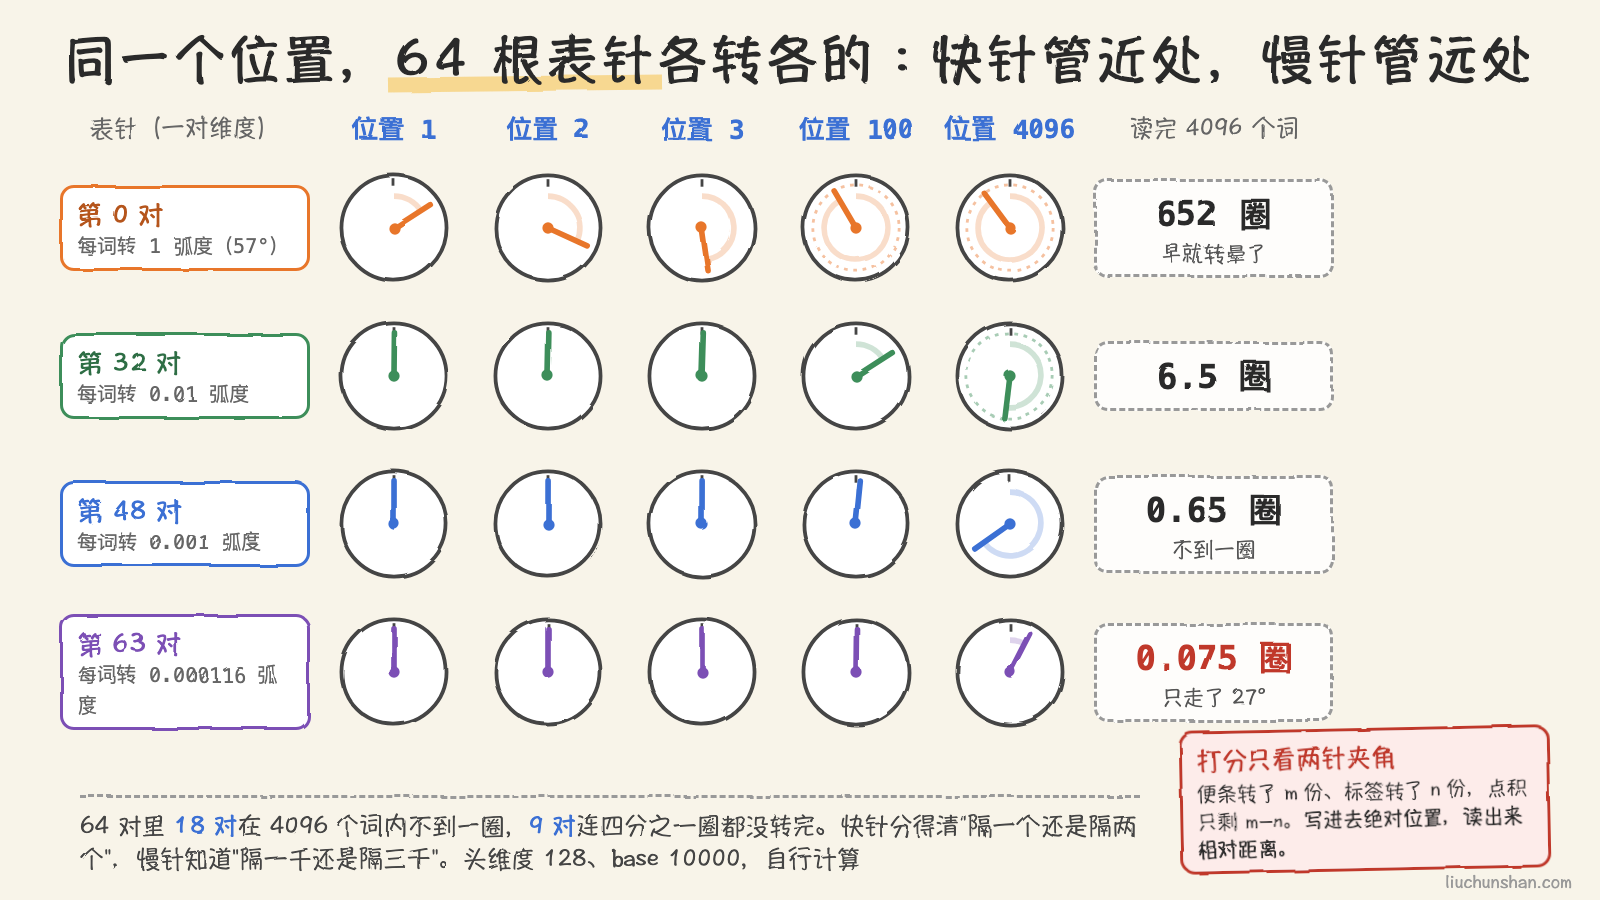
上面说”转某个角度”,实际上 64 对表针每一对的角度都不一样。第 i 对的每词转角是 10000 的负 2i 除以 128 次方。第 0 对每个词转 1 弧度,大约 57 度;最后一对每个词只转 0.000116 弧度。转速差了将近一万倍。
我把训练长度 4096 代进去算了一下,几对表针在读完 4096 个词时各自转了多少圈:
| 表针 | 每词转角(弧度) | 4096 个词转了 | 32768 个词转了 |
|---|---|---|---|
| 第 0 对 | 1 | 652 圈 | 5215 圈 |
| 第 32 对 | 0.01 | 6.5 圈 | 52 圈 |
| 第 48 对 | 0.001 | 0.65 圈 | 5.2 圈 |
| 第 63 对 | 0.000116 | 0.075 圈(27 度) | 0.6 圈 |
64 对里有 18 对在 4096 个词内不到一圈,9 对连四分之一圈都没转完。
这不是设计缺陷,是分工。快针每隔几个词就转一圈,它能精细分辨”隔一个词”和”隔两个词”,但隔 100 个和隔 105 个它已经分不清了,因为都转了几十圈、回到差不多的方向。慢针几千个词才走一小段,分不清相邻的词,但能大致知道”这个词离我有一千个词还是三千个词”。快针管近处的细节,慢针管远处的大致方位。两个词隔得越远,各对表针的夹角错得越乱,点积里正负互相抵消得越多,这就是 RoPE 论文里说的注意力随距离衰减,和语言的直觉是一致的:远处的词平均来说没那么相关。
超过训练长度,为什么是断崖不是滑坡
有了表针这个画面,外推失效就好理解了。
一个在 4096 长度上训练的模型,你给它塞 8192 个词。快针没问题,它早就转过成百上千圈,任何角度训练时都见过。出问题的是慢针。第 63 对在训练时最多只转到 27 度,位置 8192 的词把它转到了 54 度,这个角度模型从没见过。不止一对,那 18 对不到一圈的表针,全都进了训练时没到过的区域。
没见过的角度会让打分失控。2023 年 Meta 那篇位置插值论文里的原话是,外推会产生”灾难性的高注意力分数,完全毁掉自注意力机制”。他们算了理论上界,外推的注意力分数上界比插值大了大约 600 倍。这解释了一个很多人见过的现象:模型超过训练长度不是慢慢变差,是过了那条线之后输出突然变成重复的符号或者乱码。不是知识跟不上了,是打分这一步的数值直接坏了。
三种修法,拧的是同一个螺丝
知道了坏在”慢针转进没见过的角度”,修法就都能看懂了。
位置插值。最直接:8000 个词,我把位置全部乘 0.5,第 8000 个词当第 4000 个词转。所有表针最多转到训练见过的角度,没有一根出圈。代价是相邻两个词的夹角也减半了,近处的分辨率变粗,所以要微调一下让模型适应。Meta 用这个办法把 LLaMA 从 7B 到 65B 各个尺寸从 2048 拉到 32768,微调不超过 1000 步。
快针不动,慢针多压。位置插值对 64 对表针一刀切,快针本来没出圈,也被压了,近处细节白白损失。2023 年的 YaRN 按转速区别对待:快针基本不压,慢针多压,中间的渐变。效果是比之前的方法少用 10 倍的训练 token、少 2.5 倍的训练步数。推理框架里的 rope scaling 参数,大多就是在配这一档。
从头把 base 调大。前面公式里那个 10000 叫 base,它决定慢针有多慢。Llama 3 在 2024 年把它调到了 500000,原文一句话:“我们把 RoPE 的 base 频率超参数提高到 500,000”。我算了一下,base 是 10000 时最慢那对表针在 8K 长度上转 0.15 圈,base 500000 时在 128K 长度上只转 0.05 圈。慢针更慢,就有了更多没用完的角度余量,长距离也能分得开。Llama 3 用 8K 窗口预训练,然后分六个阶段继续训练,把窗口拉到 128K,靠的就是这个余量。
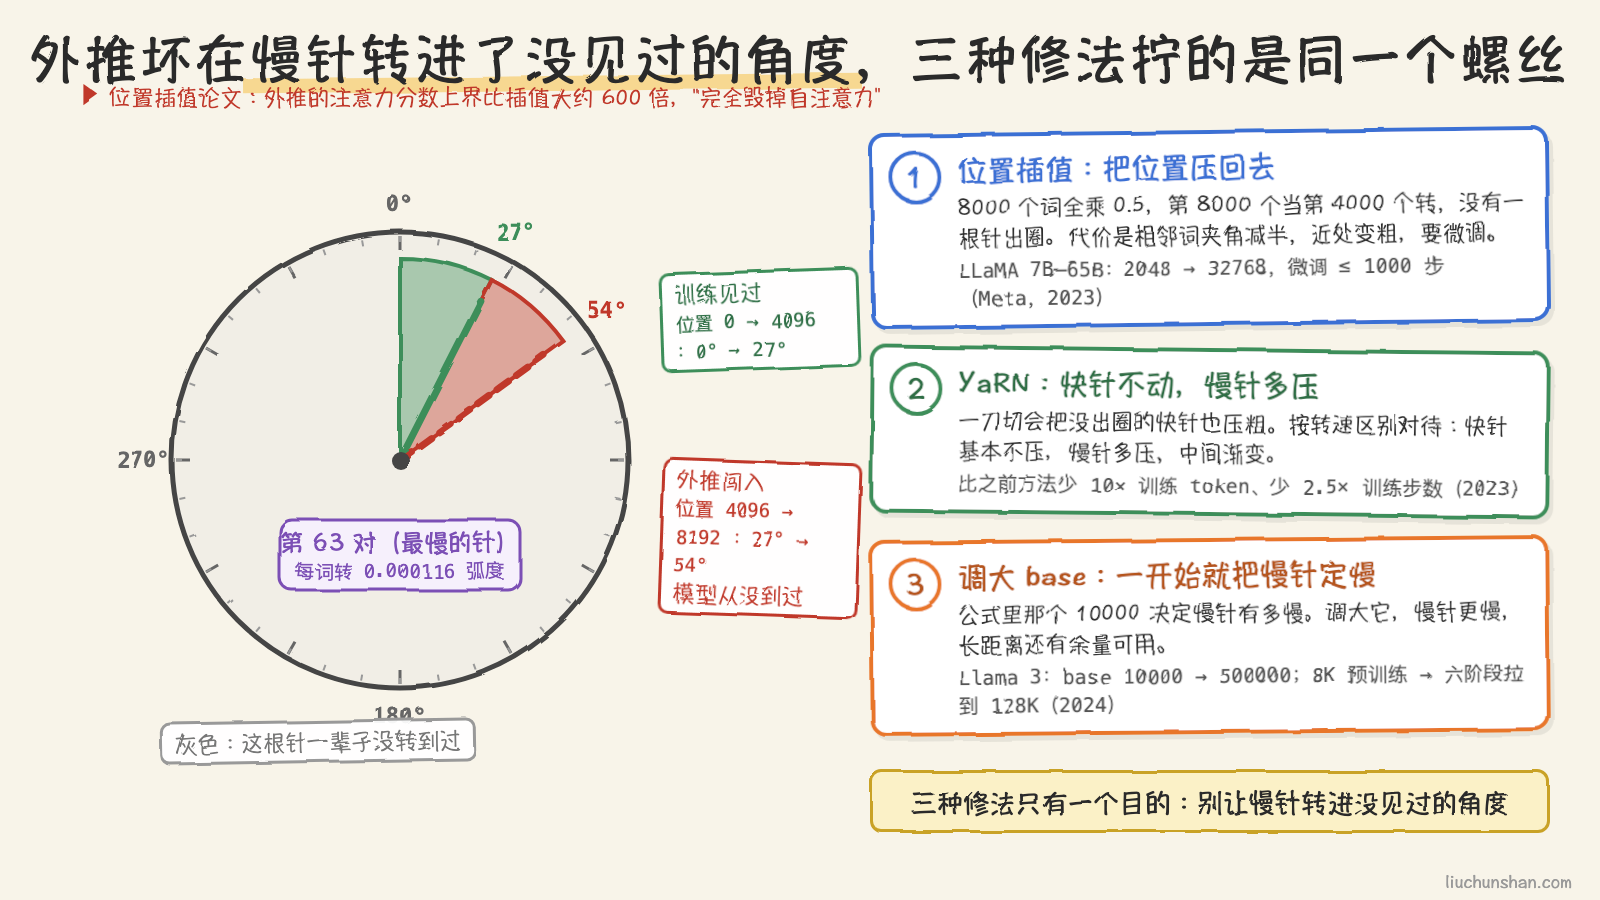
三种修法都在干同一件事:别让慢针转进没见过的角度。区别只在于是压位置、压转速,还是一开始就把转速定慢。
位置是外挂,决定了长上下文的所有玩法
回到开头。模型知道”狗咬人”里谁咬谁,是因为”狗”的表针转了 1 份角度、“人”转了 3 份,“咬”去问它们时,分数里带着”一个在我前面一格、一个在我后面一格”这个信息。词序不是注意力自带的,是转进去的。
想通这一点之后,长上下文这件事的很多现象都对上了。为什么模型有”训练长度”这个概念,因为表针只在那个范围内转过。为什么某个模型的长上下文版本要”继续训练”发布而不是改个配置就行,因为角度余量是训出来的。为什么推理框架里改一个 rope scaling 参数就能让一个 4K 的模型硬撑 32K,但质量会掉,因为那是在没有微调的情况下把近处分辨率换给了远处。
昨天那篇的结尾我说,上下文能从 4K 撑到 100 万是另一个故事。这篇算是讲了那个故事的一半:位置编码决定了”能不能塞进去”。另一半是塞进去之后模型到底用不用得好,中间那几万字它是不是真的看了,那是下一篇的事。
参考:
- Vaswani 等,Attention Is All You Need,arXiv 1706.03762,2017
- Su 等,RoFormer: Enhanced Transformer with Rotary Position Embedding,arXiv 2104.09864,2021
- Haviv 等,Transformer Language Models without Positional Encodings Still Learn Positional Information,arXiv 2203.16634,2022
- Press 等,Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation,arXiv 2108.12409,2021
- Chen 等,Extending Context Window of Large Language Models via Positional Interpolation,arXiv 2306.15595,2023
- Peng 等,YaRN: Efficient Context Window Extension of Large Language Models,arXiv 2309.00071,2023
- Grattafiori 等,The Llama 3 Herd of Models,arXiv 2407.21783,2024
- 表针转速与圈数按 RoPE 公式(头维度 128、base 10000 / 500000)自行计算,代码见正文
评论