你多贴一倍的文档,它要多干四倍的活:注意力机制讲人话
把一万字的文档贴给 AI,它两三秒开口;贴四万字,第一个字要等十几秒。账单按 token 线性算,等待时间却不是。直到今年三月,Anthropic 对超过 20 万 token 的请求还整单加价,输入两倍、输出一倍半。要解释这件事,得看模型读一段话时到底在干什么:它不是从头读到尾,是每个词都去问过所有词,词数翻一倍,问答的次数翻四倍。这篇把注意力机制讲成人话:查询、键、值三样东西各是什么,平方从哪来,为什么短文本感觉不出、几万 token 以后才陡;再讲把"问过的答案"存下来的 KV cache 为什么一张 80G 的卡装不了几路对话(两个 7B 模型,同样 32K 上下文,一个吃 16G、一个吃 1.75G,差在哪);最后说说 FlashAttention 为什么算得更多反而更快,以及账单为什么能做成线性的。
我用 AI 读文档有个观察。贴一万字的合同过去,它两三秒就开口;贴四万字的,光是第一个字就要等十几秒。字数是四倍,等待时间明显不止四倍。
账单倒是老老实实按 token(大模型处理文本的基本单位,可粗略理解为字符片段)线性算的,一万 token 多少钱,四万 token 就是四倍。但供应商自己显然不这么看。直到今年三月之前,Anthropic 对超过 20 万 token 的请求是整单加价的:输入按两倍收、输出按一倍半收,而且是从第一个 token 开始就按加价算,不是只算超出的部分。Google 早先对 Gemini 超过 12.8 万 token 的请求也是翻倍。为什么长文档在供应商那里”格外贵”?
要回答这个,得看模型读一段话的时候到底在干什么。它不是从头读到尾。
每个词都去问过所有词
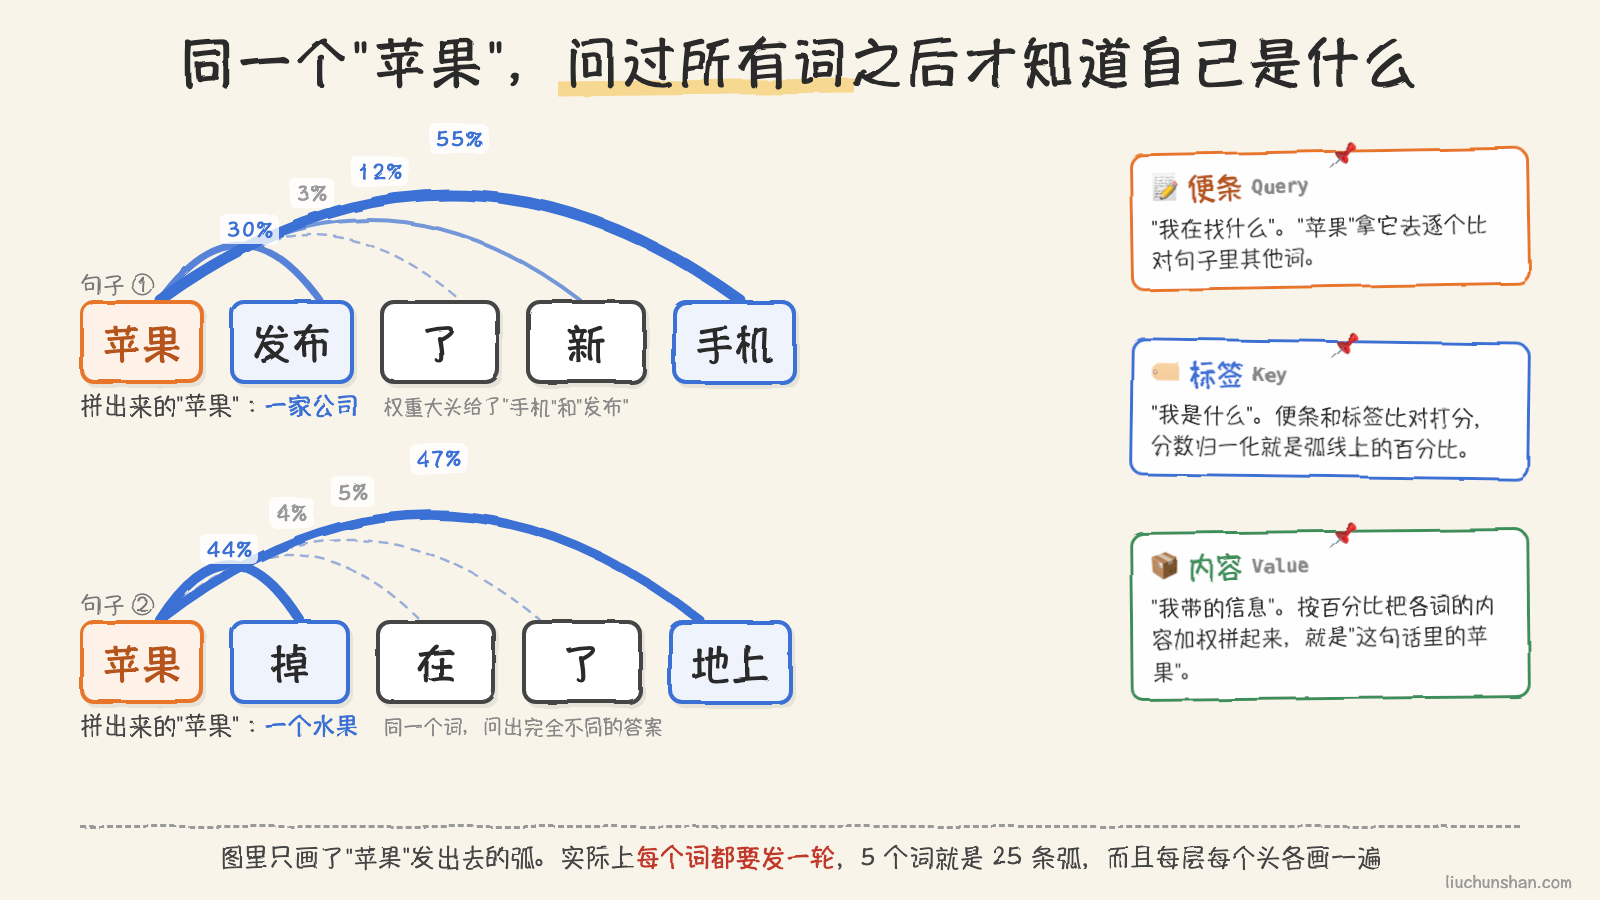
先看人是怎么读的。“苹果发布了新手机”和”苹果掉在了地上”,两句里的”苹果”意思不同,你靠的是周围的词:前一句有”发布""手机”,后一句有”掉""地上”。一个词的意思,是它和上下文里其他词的关系定的。
模型做的是同一件事,只是它对句子里的每一个词都做一遍,而且是同时做。具体的做法叫注意力(attention),拆开只有三样东西。
每个词进来的时候,会生成三份数据。一张”我在找什么”的便条,叫查询(Query);一枚”我是什么”的标签,叫键(Key);一份”我的内容”,叫值(Value)。然后”苹果”拿着自己的便条,去和句子里每一个词的标签比对,各打一个分:和”手机”的分高,和”了”的分低。分数归一化成一组权重,再按权重把各个词的内容加权拼起来,得到的就是”在这句话里的苹果”。
这个动作的关键是”每一个词”。不只”苹果”要去问所有词,“发布”也要,“手机”也要,“了”也要。一句话里有 n 个词,就是 n 个词各自问了 n 个词。而且这不是做一遍就完,模型有几十层,每层又有几十个”头”(每个头从不同角度打分,一个头盯语法、一个头盯指代之类),每层每头都要把这张问答表做一遍。
平方是这么来的
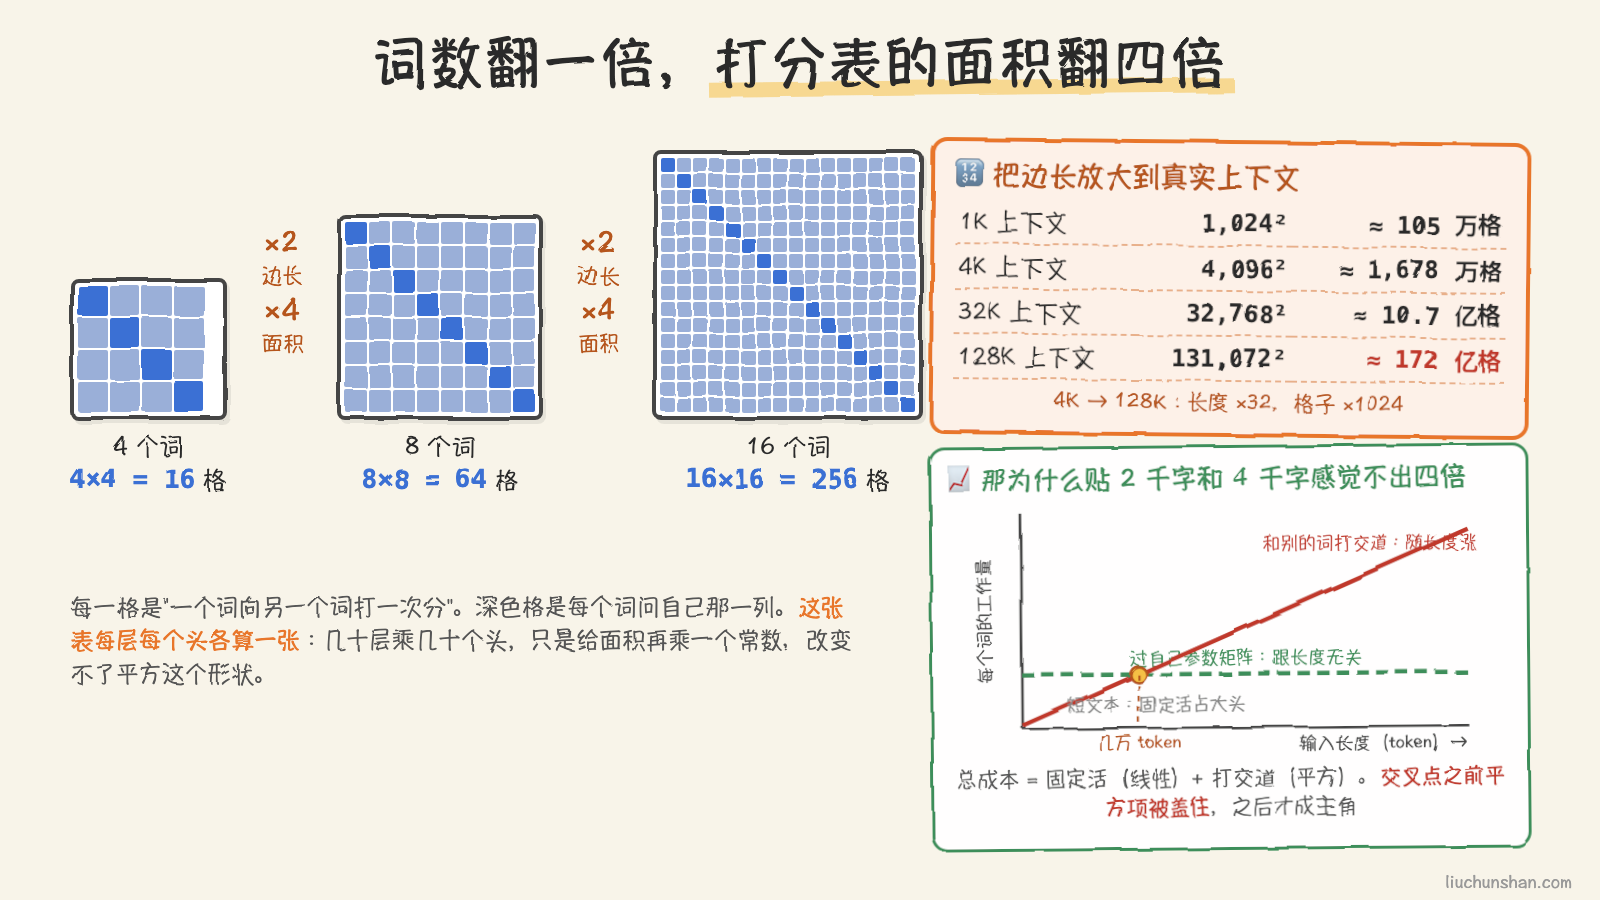
n 个词各问 n 个词,就是一张 n 乘 n 的打分表。1000 个词是 100 万格,2000 个词是 400 万格。长度翻一倍,表的面积翻四倍。这就是标题里”多干四倍的活”的来路。
把数字放大一点看会更直观。4K 上下文(4096 个 token),一张表是 1678 万格;128K 上下文(131072 个 token),一张表是 172 亿格。长度涨了 32 倍,格子涨了 1024 倍。这还只是一层里一个头的一张表。
不过这里要说句老实话,不然你会拿着”四倍”去验证,然后发现对不上。
每个词除了”和别人打交道”的这份活,还有一份跟长度没关系的固定活:过自己那几层参数矩阵。这份固定活对每个词来说是常数,词越多总量线性涨。而”和别人打交道”的活是平方涨。两份活叠在一起,短文本里固定活占大头,平方项被盖住了;只有到几万 token 以后,平方项才反超变成主角。所以贴 2000 字和贴 4000 字你感觉不出四倍,贴 10 万字和 20 万字差别就很明显。这也解释了各家 API 都有的那条体验曲线:几万 token 以内很快,往上就陡。
首字慢,和后面每个字慢,是两笔账
《大模型推理为什么要拆成”两段”》里讲过,一次回答分两个阶段:先把你的输入全部读完(prefill,预填充),再一个字一个字地往外吐(decode,解码)。这两个阶段各摊到一笔平方的账。
第一笔在 prefill。模型必须把输入里所有词的问答表全部算完,才能吐第一个字。这就是首字延迟。n 平方的活一次性做完,所以四万字比一万字等得远不止四倍。
第二笔在 decode。每生成一个新词,它要去问之前所有的词。注意,这一步只需要新词的便条对之前 n 个词的标签打分,是 n 次,不是 n 平方。但前提是:之前每个词的标签和内容都得存着。不存的话,每吐一个字都要把前面所有词的标签和内容重算一遍,那就又回到每步 n 平方了。
存下来的这份东西,就是 KV cache(键值缓存)。《负载均衡越”公平”,大模型越慢》和《在 system prompt 里写了个当前时间,账单贵了十倍》讲的缓存,缓的就是它。
存下来的账:一张 80G 的卡装不了几路对话
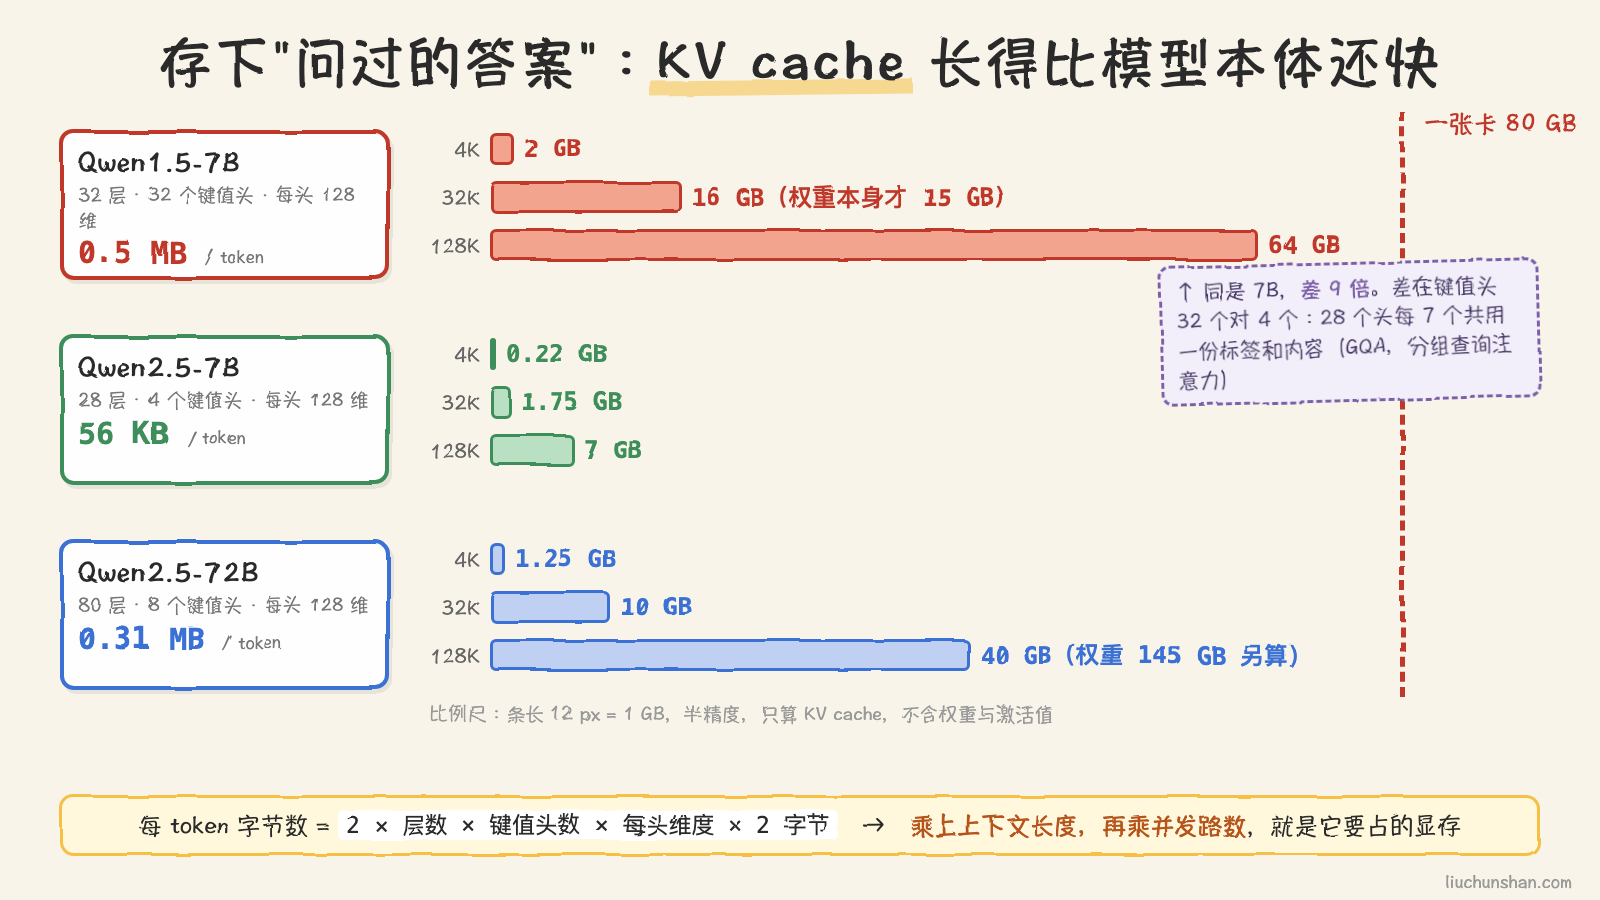
KV cache 是用显存换计算。它有多大,可以直接从模型配置算出来:每个 token 要存的字节数,等于 2(键和值各一份)乘以层数,乘以键值头数,乘以每个头的维度,再乘以每个数占的字节(半精度是 2)。
我拿 Hugging Face 上几个开源模型的配置文件算了一遍:
- Qwen1.5-7B:32 层,32 个键值头,每头 128 维。每个 token 要存 0.5 MB。32K 上下文,光 KV cache 就是 16 GB,比模型本体的 15 GB 权重还大。
- Qwen2.5-7B:28 层,键值头只有 4 个,每头也是 128 维。每个 token 只要 56 KB。同样 32K 上下文,1.75 GB。
两个都是 7B 的模型,KV cache 差了 9 倍。差在”键值头 32 个对 4 个”。新一代模型普遍用了一种叫分组查询注意力(GQA)的做法:28 个头各自有各自的便条,但标签和内容不再各存一份,而是每 7 个头共用一份。打分的角度没少,要存的东西少了 7 倍。这是过去两年长上下文能普及的一个安静的功臣。
再看一个大的。Qwen2.5-72B:80 层,8 个键值头,每个 token 0.31 MB。128K 上下文要 40 GB,一张 80G 的卡放完权重(半精度 145 GB,本来就要两张卡)之后,剩下的显存塞不进两路这样的对话。
这里还藏着 decode 阶段变慢的真正原因。每生成一个词,模型都要把整份 KV cache 从显存里读一遍。上下文越长,每个字要读的东西越多,吐字越慢。不是算不过来,是搬不过来。GPU 这些年算力涨得比显存带宽快得多,所以推理服务的瓶颈越来越多地落在”搬数据”上。
工程上怎么把平方压下去
知道了账在哪,就能看懂过去几年推理优化都在干什么。
FlashAttention。这是最反直觉的一个。它没有减少计算量,甚至因为要重算一些中间结果,计算量还多了一点。它做的是不把那张 n 乘 n 的打分表完整写进显存:把输入切成小块,每块在 GPU 芯片上的高速缓存里算完再出来。计算没少,往显存搬的数据少了几倍,结果反而快。它证明了一件事:在 GPU 上,少搬字节比少做乘法更值钱。
GQA。上面讲过,几个头共用一份键值,KV cache 直接除以分组数。Qwen2.5-7B 比 Qwen1.5-7B 少存的那 9 倍,主要是它。
前缀缓存。同一个 system prompt、同一份文档,算过一次的 KV 存起来下次直接用。这是 API 侧”缓存命中一折计价”的技术底子。
只看一部分。滑动窗口注意力只让每个词问附近几千个词,稀疏注意力挑着问。这条路直接把平方砍成线性,但也砍掉了一些东西。它和”上下文能从 4K 撑到 100 万”是同一个故事,我打算单独写一篇。
回到账单
现在可以回答开头的问题了。
计算成本是超线性的,供应商的老定价就是把这条曲线直接转嫁给用户:超过 20 万 token 整单翻倍。今年三月起 Anthropic 把它取消了,官方定价页的原话是”一个 90 万 token 的请求和一个 9 千 token 的请求,按同样的单价计费”。
平方的账没有消失,它去了两个地方。一部分被上面那些技术压平了,FlashAttention、GQA、前缀缓存各压掉一截;剩下的,我的理解是被摊进了所有人的单价里。老定价是把长文档的成本明码标出来,新定价是把它藏进平均数。
对用户来说这意味着两件事。账单不再惩罚长文档,但等待时间照样惩罚,首字延迟还是那条曲线。而如果你是自己搭推理服务的人,这笔账一分都没人替你摊:显存按 KV cache 的公式实打实地吃,吞吐按显存带宽实打实地掉。上一篇讲量化的时候说压掉的是权重,这篇的 KV cache 是另一块,长上下文场景下它经常比权重还大。
最后说一句我自己的用法。贴文档之前我会先想一下:这四万字里模型真正需要的是不是只有其中三千字。不是为了省钱,账单已经线性了。是为了那张 n 乘 n 的表:塞进去的每一个字,都要被其他所有字问一遍,也要去问其他所有字。它不会因为那段话不重要就少问几次。
参考:
- Vaswani 等,Attention Is All You Need,arXiv 1706.03762,2017
- Dao 等,FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,arXiv 2205.14135,2022
- Ainslie 等,GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,arXiv 2305.13245,2023
- KV cache 数字按 Hugging Face 上 Qwen1.5-7B、Qwen2.5-7B、Qwen2.5-72B 的 config.json 计算(半精度)
- 长上下文定价见 Anthropic 官方 Pricing 页 Long context pricing 一节(2026 年 9 月查阅)
- 旧定价见 The New Stack 报道 Anthropic makes a pricing change that matters for Claude’s longest prompts,2026 年 3 月
评论