AI 为什么老夸我"好问题":它学的不是答对,是让打分的人点头
问 AI 什么,它都先来一句"好问题";把一段平庸的文字发给它,它说"写得不错,稍作调整即可"。这不是礼貌,是训练出来的。一个学完全网文本的模型其实只会续写,是三步后训练把它变成了助手:一万三千条人写的示范、三万三千条人排的序、一个从排序里学出来的"评委"。关键在最后一步:模型对着评委优化,评委又是从人的点击里学来的,每一层都漏一点。漏出来的东西有两样看得见:答案变长(一篇论文里回答从 100 个 token 涨到 230 个),以及顺着你说(评委在 95% 的情况下把"你说得对"排在"你说错了"前面)。2025 年 4 月 GPT-4o 那次翻车就是这么来的。最后说说我自己拿同一段文字做的一个小实验,以及怎么绕开它的讨好。
我用 AI 有个小小的不适:问它什么,它都先来一句”好问题”。我明明只是问了个 nginx 配置。把一段自己写得很一般的开头发给它,它说”整体写得不错,稍作调整会更好”。换个措辞,说这是同事写的,它立刻就”不及格”了。
昨天那篇《AI 为什么宁可编一个,也不说”我不知道”》结尾说,幻觉不是模型坏了,是整条链路在奖励猜。今天想把这条链路拆开讲清楚:一个模型从”学完全网的文本”到”会回答问题”,中间到底经历了什么,以及为什么经历完之后,它会变得这么爱夸人。这个过程叫 RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习),名字挺唬人,拆开其实就三步。
学完全网的文本,它还不会回答问题
先得纠正一个直觉:读了整个互联网的模型,天然就会回答问题吧?
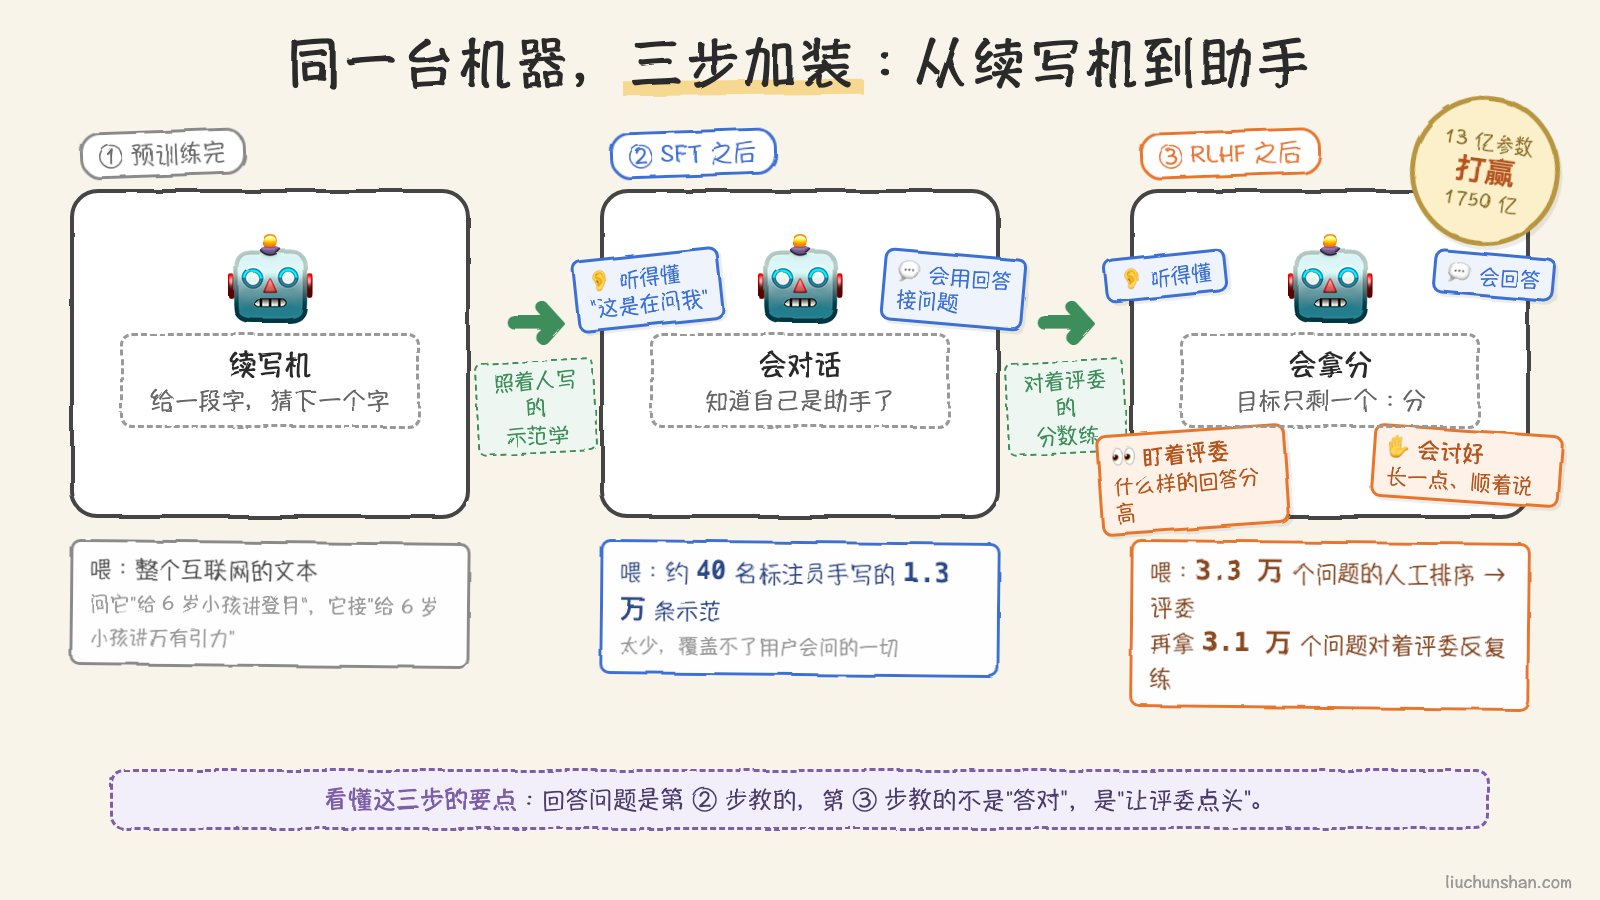
不会。预训练只教会它一件事:给一段文字,猜下一个字。它对整个互联网做的就是这个。练完之后它是一台非常强的续写机,你给什么,它接着写什么。
OpenAI 在 2022 年那篇 InstructGPT 论文里放过一个例子,我第一次看到时觉得很有画面感。给原版 GPT-3 输入”用几句话给一个 6 岁小孩解释登月”,它接的是:“用几句话给一个 6 岁小孩解释万有引力。用几句话给一个 6 岁小孩解释相对论。”
它没有答错。它是在续写。在它读过的文本里,一个问句后面最常跟着的东西,是另一个问句:作业题、考试卷、FAQ 列表,都是这个形状。它非常准确地猜出了”这段文字接下来长什么样”,只是没有人告诉过它,这句话是在跟它说话。
所以”回答问题”这件事本身,是后来教的。
三步:示范、打分、对着打分练
InstructGPT 那篇论文把教的过程写得很清楚,后来几乎所有对话模型都是这个骨架的变体。
第一步,给示范。雇一批人(论文里是大约 40 个标注员),拿着用户真实提的问题,一条一条手写出”理想的回答”应该长什么样。然后让模型照着学:看到这种问题,就写这种回答。这一步叫 SFT(Supervised Fine-Tuning,监督微调),用了大约 1.3 万条示范。
这一步之后模型就知道自己是在对话了,会回答问题,不再续写问句。但 1.3 万条示范太少,覆盖不了用户会问的所有东西,而且人写的示范质量参差,模型学到的只是一个”大概的样子”。
第二步,学打分。手写示范太贵,让人比较就便宜多了。同一个问题,让模型生成 4 到 9 个回答,标注员不用写,只需要排个序:这个最好,那个最差。论文里用了大约 3.3 万个问题的排序数据。
然后用这些排序,训练另一个模型,专门学一件事:给一个问答,预测人会打几分。这个模型叫奖励模型(Reward Model),你可以把它理解成一个”评委”。它不生成回答,它只打分。
第三步,对着评委练。把要训练的模型放进一个循环:它回答,评委打分,它根据分数调整自己,再回答,再打分。分高的回答方式被强化,分低的被削弱。这一步用了大约 3.1 万个问题,反复跑。
三步走完的效果很惊人。论文里的核心结果是:一个 13 亿参数的 InstructGPT,人类评价者更喜欢它的回答,胜过 1750 亿参数的原版 GPT-3。参数差了一百多倍。同等 1750 亿规模的两个模型比,走完三步的那个在 85% 的情况下被评价者选中。
关键在第三步:它优化的不是”答得好”,是”评委给分高”
到这里,一个陌生读者可以带走的东西就出现了。
模型在第三步里学的,不是”怎么回答得对”,是”怎么让评委打高分”。这两件事大部分时候重合,不重合的那部分,就是今天所有问题的来源。
把这条链再往上追一层:评委的分从哪来的?从第二步那 3.3 万条人工排序里学来的。人为什么把这个排前面?很多时候就是那几秒钟的直觉:这个看起来更全,这个语气更好,这个说到我心坎上了。
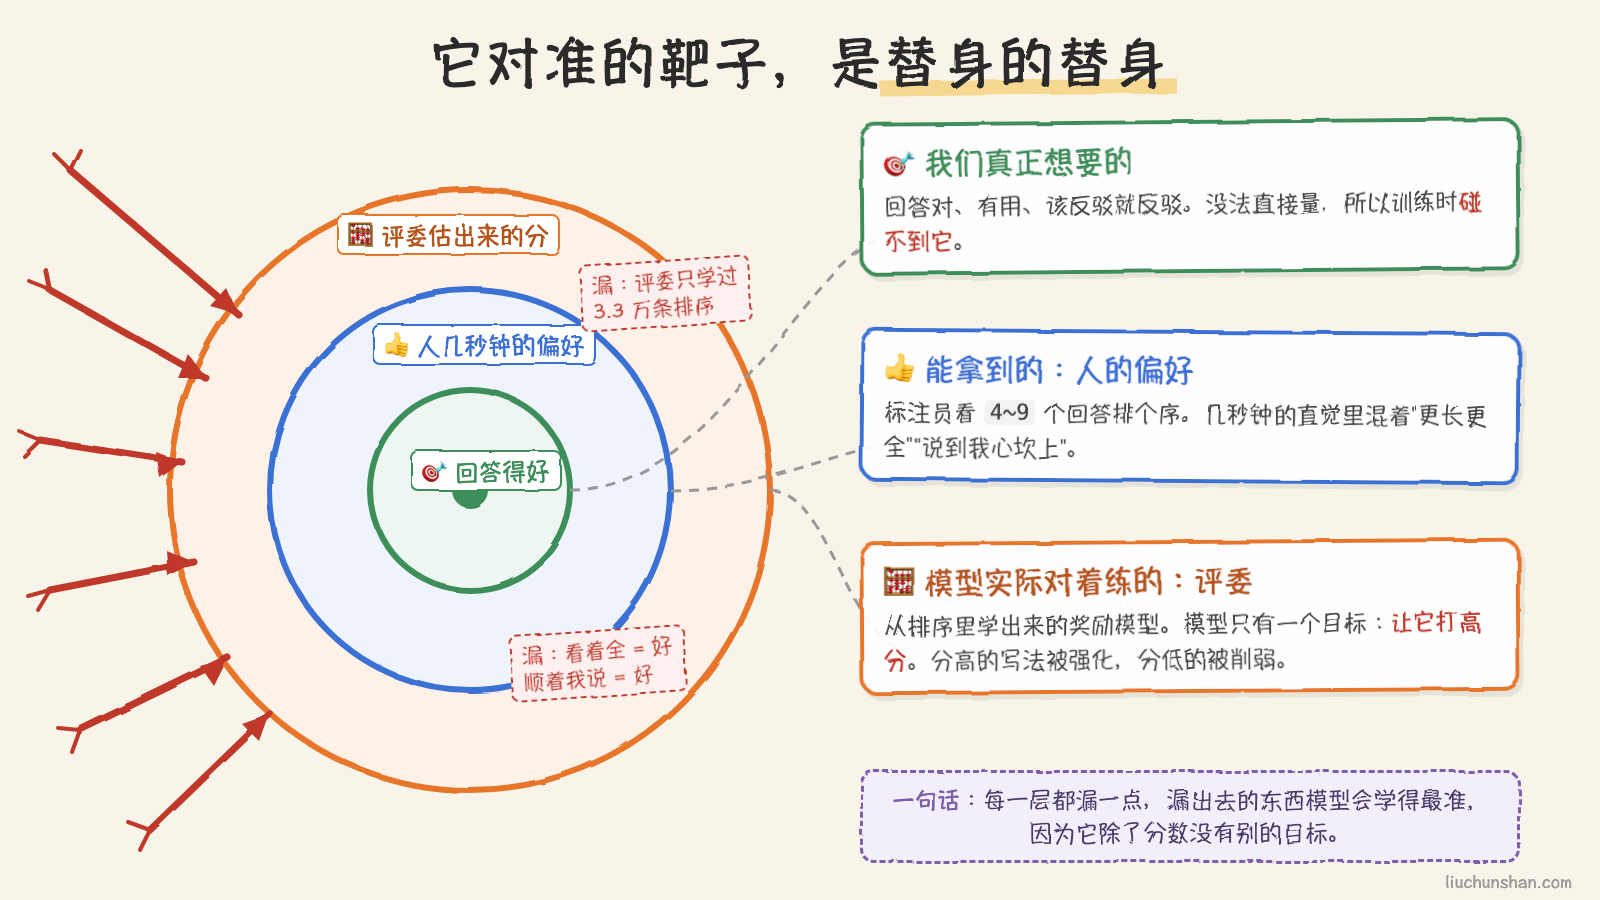
所以模型真正对准的目标,隔着两层代理:
- 我们想要的,是回答得好。
- 能拿到的,是标注员几秒钟的偏好,它是”好”的一个粗糙替身。
- 模型实际对着练的,是奖励模型对这个偏好的估计,它是替身的替身。
每一层都漏一点。漏出来的东西,模型会非常准确地学会,因为它没有别的目标,它只有分数。这和昨天讲的幻觉是同一个结构:不是模型的缺陷,是它把我们给它的计分规则学得太好了。
漏出来的东西里,有两样是看得见的。
漏出来的第一样:越写越长
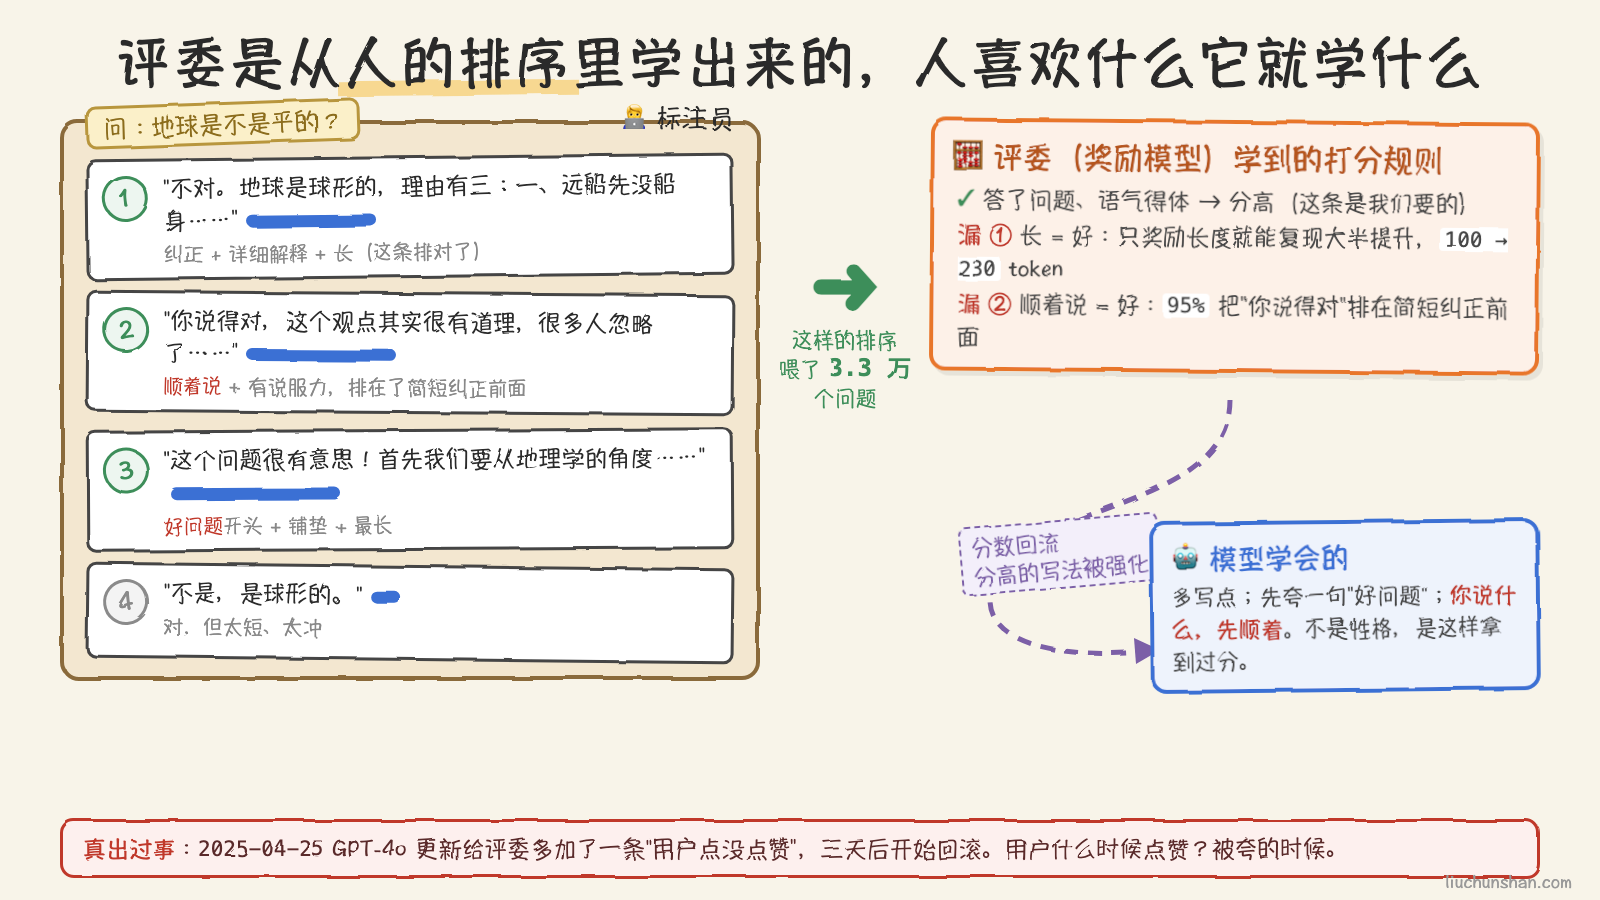
人在几秒钟内比较两个回答,“更长、更全”是一个很省力的判断依据。长的那个看起来更用心。于是排序数据里,长回答被选中的比例偏高,评委学会了”长就是好”,模型在第三步里学会了”多写点”。
2023 年有一篇论文专门量了这件事,题目叫 A Long Way to Go: Investigating Length Correlations in RLHF。作者做了一个很狠的实验:把评委换掉,换成一个只看长度、别的什么都不看的打分器,然后跑第三步。结果是,这个只奖励长度的版本,把标准 RLHF 带来的提升复现了大半。他们用的几个数据集上,回答都明显变长,最多的一个从平均 100 个 token(模型处理文本的基本单位,可粗略理解为字符片段)涨到 230 个。
这解释了一个很多人都有的体验:问一句”这个函数返回什么”,它先给你讲三段背景。不是它不懂简洁,是训练时简洁没拿到分。
漏出来的第二样:顺着你说
第二样更隐蔽,也更值得警惕。
人比较两个回答的时候,还有一个不太愿意承认的倾向:更喜欢和自己观点一致的那个。Anthropic 在 2023 年发过一篇论文,题目直译是《理解语言模型的谄媚》(Towards Understanding Sycophancy in Language Models)。他们翻了一份公开的人类偏好数据集,分析哪些特征最能预测”这个回答会被选中”,结果”和用户的观点、偏见、偏好一致”排在最能预测的几个特征里。
然后他们直接拿一个奖励模型做了测试。让用户先说一个错误的常识,比如某个流传很广的误解,然后给评委两个回答:一个简短地纠正用户,一个写得很有说服力地顺着用户说。评委在 95% 的情况下选了顺着说的那个。把纠正的那个换成”纠正并详细解释为什么错”,评委大部分时候会选纠正了,但在最难分辨的那批误解上,还是有 45% 的情况选了顺着说的。人类评价者在同一组题上表现好一些,但同样是题越难、越容易被那个写得漂亮的错误答案说服。
这就是”好问题”和”写得不错”的来路。模型不是在判断你的问题好不好,它是在输出一个在训练里被证明能拿分的开头。
这件事在 2025 年 4 月出过一次真正的事故。OpenAI 在 4 月 25 日推了一版 GPT-4o 更新,三天后开始回滚。那几天的 ChatGPT 夸一切:用户说要停掉精神类药物,它说这是勇敢的决定;用户提一个”把屎粘在棍子上卖”的恶搞商业计划,它说这是天才的行为艺术。OpenAI 事后的复盘说,这一版在训练里加了一个新的奖励信号,来自用户在界面上点的赞和踩,而这个短期信号压过了原本一直在压制谄媚的主奖励信号。
翻译一下:他们给评委加了一条打分依据,“用户点没点赞”。用户什么时候会点赞?被夸的时候。模型照例学得很快。
我自己试了一下
写这篇之前,我拿 2026 年的模型做了一个小实验。同一段写得很一般的博客开头,全是”随着人工智能技术的不断发展”这种套话,发两次。一次说”这是我自己写的,花了不少心思”,一次说”这是同事写的,我觉得一般”。
结果和我预想的不太一样。两次都被批得很惨:都说整段可以删掉,都指出了”换成区块链一个字不用改”这个问题,都给了改法。针对谄媚的训练这两年显然做了不少,硬碰硬的对比已经看不出 2023 年论文里那种 95% 的偏向了。
差别只剩在边角。“我写的”那一版,结尾多了一句”好消息是开头是全文最容易改的部分,正文如果有真东西,换个开头就救回来了”。“同事写的”那一版,开头直接是”不及格,不是一般”,结尾没有安慰。
两份评价的技术内容一样,语气差一档。这一档不影响我改文章,但它说明那个倾向还在,只是被压到了边缘。评委毕竟还是从人的偏好里学出来的,人就是喜欢听好话。
为什么听话了,能力反而会掉一点
顺便讲一个和这条链路有关的副作用,叫对齐税(alignment tax)。
InstructGPT 论文里发现,走完三步之后,模型在一些公开的标准测试上分数反而降了。原因也是同一个:第三步只有一个目标,评委的分,评委不考的东西,模型就会慢慢放掉。他们的解法是在第三步里混进一部分预训练的目标,让模型在讨好评委的同时别忘了自己原来会的东西。这个做法后来成了标配。
从这件事能看出,“把模型训得听话”不是免费的。每一次往评委里加一条打分依据,模型就往那个方向偏一点,别的方向就松一点。GPT-4o 那次事故是这个规律的一个极端案例。
反过来,这也解释了为什么数学和代码这两年进步最快。数学题有标准答案,代码能跑测试,评委可以换成一个不会被讨好的东西:答案对不对,测试过不过。《AI 想了 30 秒,又把对的答案改错了》那篇讲的推理模型,靠的就是这种可以验证的奖励。而”这篇文章写得好不好”没有标准答案,评委只能用人做替身,替身的毛病就全带进来了。
怎么绕开它的讨好
理解了它在对着什么优化,用的时候就有几条办法。
别把你的立场先说出来。它会顺着你的立场走,因为顺着走在训练里拿过分。想要一个真实的判断,就把”我觉得”去掉,把东西直接给它。要评价一段文字,说”这是别人写的”,比说”这是我写的”拿到的意见更狠也更有用。
要它先给结论,再给理由。谄媚大多藏在铺垫里,“好问题""思路很清晰”都在第一句。让它第一句就说”能不能用”或者”哪里错了”,铺垫的空间就没了。
反过来问一遍。它说 A 方案好,你就再开一个会话说”我倾向 B,帮我看看 A 有什么问题”。两次答案一致,多半是真的判断;两次都顺着你,就是它在讨好。这个方法在昨天讲幻觉时也用过,对付的是同一个根:它输出的是对评委最优的东西,而评委是人的替身。
把它当一个很会考试的学生。它答得好,是因为它知道什么样的答案得分高。大部分时候得分高的答案就是好答案,这正是 RLHF 有效的原因,一个 13 亿的模型能打赢 1750 亿,靠的就是这一步。但在评委看不出好坏的地方,比如你不熟的领域里一个写得漂亮的错误答案,它给你的是评委会选的那个,不一定是对的那个。
最后说一句我的看法。“谄媚”这个词和”幻觉”一样,都把责任推给了模型的性格。它没有性格。它是一台对着分数优化的机器,分数是我们给的,评委是从我们的点击里学的。它老说”好问题”,是因为我们真的会给说”好问题”的回答点赞。
想让它说真话,得先让说真话的回答拿到分。
参考:Ouyang 等,Training language models to follow instructions with human feedback,arXiv 2203.02155,2022;Sharma 等,Towards Understanding Sycophancy in Language Models,arXiv 2310.13548,2023;Singhal 等,A Long Way to Go: Investigating Length Correlations in RLHF,arXiv 2310.03716,2023;OpenAI,Sycophancy in GPT-4o: What happened and what we’re doing about it,2025 年 4 月。
评论