AI 为什么宁可编一个,也不说"我不知道":幻觉讲人话
让 AI 推荐几篇文献,作者是真的、期刊是真的、年份也合理,题目却一篇都查不到。问它一个小众库的用法,它给了一个名字取得非常像样、文档里压根没有的参数。它为什么不说一句"我不知道"?这篇从昨天那张概率表接着讲:在模型内部,"答对"和"编造"是同一个动作,它没有"这条我没存"这个状态;为什么数字、日期、引文、URL 最容易假;以及一个更扎心的原因:从预训练到排行榜,整条链路都在奖励猜、惩罚弃答。OpenAI 那篇论文里的一组数很说明问题:弃答率 1% 的模型错了 75%,弃答率 52% 的模型只错 26%,但榜单上前者的"准确率"更高。最后说说 RAG 和工具调用为什么是对症的,以及我自己怎么跟一个"总在续写"的东西打交道。
去年有段时间我让 AI 帮我找文献。它给了五篇,格式工整:作者、年份、期刊、卷期页码一样不缺。作者是这个领域真有的人,期刊是真的,年份也合理。我拿去数据库一查,五篇里三篇不存在。不是找错了,是压根没有这篇文章。
另一次是写代码。我问它某个不太常用的库怎么设置超时,它给了一个参数名,命名风格和这个库的其他参数完全一致,看起来就该有这么个东西。跑起来报错:没有这个参数。翻文档,确实没有。
这两件事让我烦的不是它错了。人也会错。让我烦的是它错得那么自然:语气笃定、格式完整、细节齐全,和它答对的时候一模一样。它为什么不说一句”这个我不确定”?
要回答这个问题,得回到昨天那篇《temperature 调成 0,答案为什么还是会变》里的那张表。
答对和编造,在它内部是同一个动作
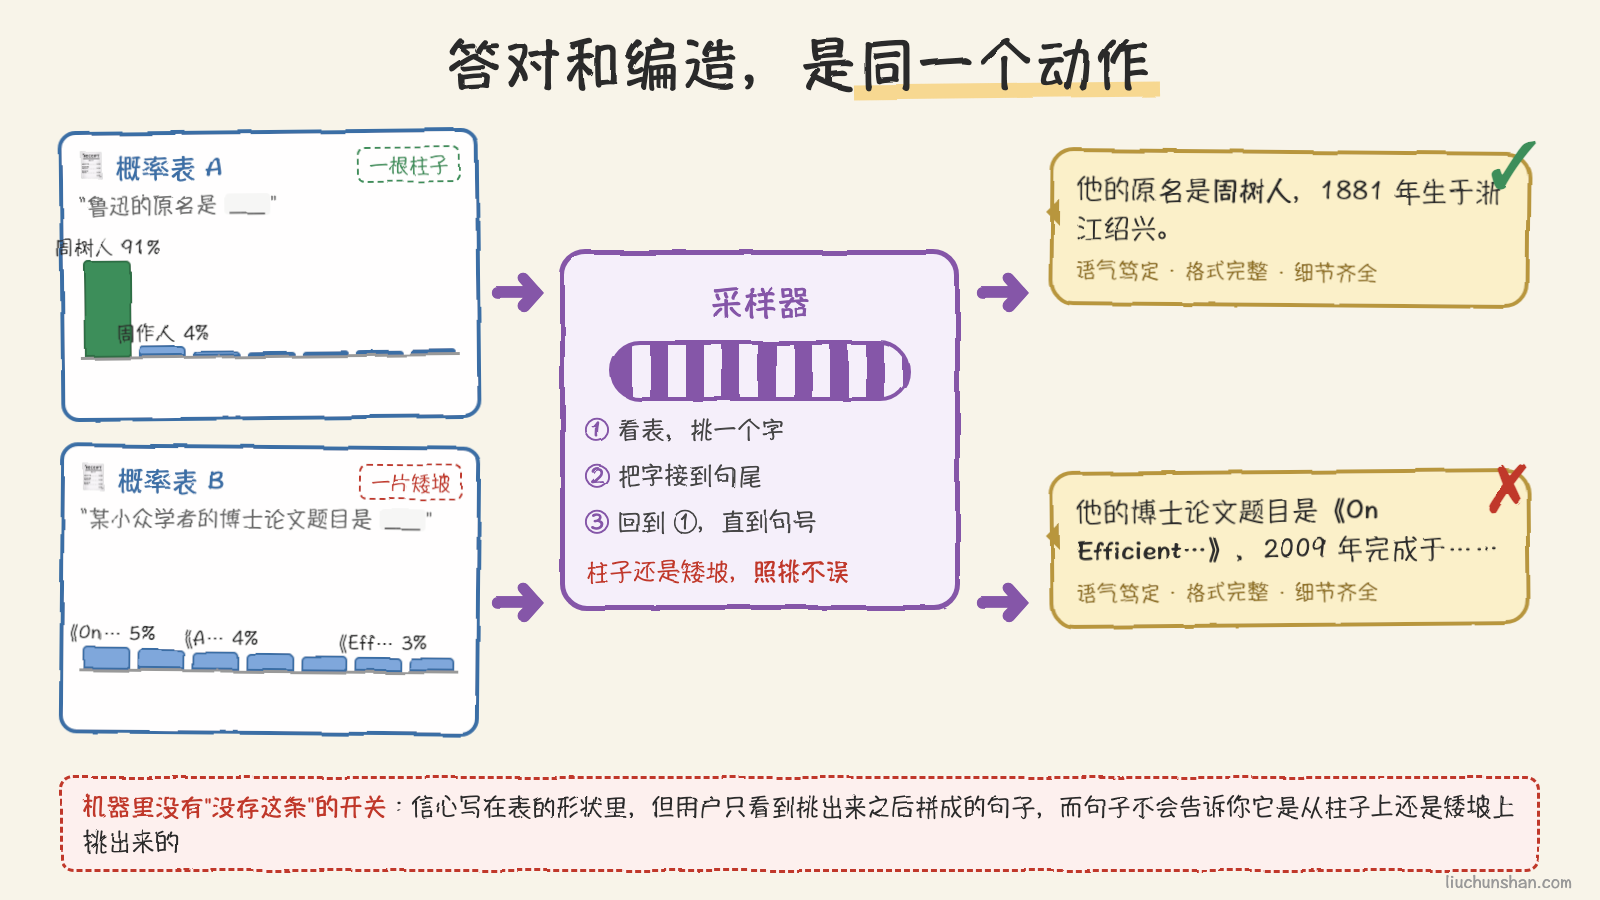
昨天讲过:模型每生成一个字,交出来的不是一个字,而是整个词表上的一张概率表,然后由采样器从表里挑一个。今天要说的是,这张表在”它知道”和”它不知道”两种情况下,长得没有本质区别。
问它”鲁迅的原名是”。这句话在训练数据里出现过无数次,“周树人”三个字在概率表上高得像一根柱子,其他候选加起来都不够看。采样器挑它,几乎不会挑错。
再问它”某位小众学者的博士论文题目是”。这条事实在训练数据里可能只出现过一次,甚至没出现过。概率表上没有那根柱子,取而代之的是一片矮坡:几十个候选,每个百分之几,都是”论文题目通常长什么样”这个模式撑起来的。
关键在下一步。采样器不会因为坡矮就拒绝挑选。它照样从这片矮坡里挑一个字,然后再挑下一个,再下一个。每一步都是同一个动作:看表,挑字。挑出来的那串字,语法通顺、用词专业、格式正确,因为”论文题目长什么样”这个模式模型学得很好。唯独内容是编的。
所以在模型内部,不存在”查到了”和”没查到”两种状态。它从来不是在查表,它一直在续写。答对是续写得恰好和事实一致,编造是续写得和事实不一致,中间没有一个开关。它的”信心”确实写在那张概率表的形状里,柱子高就是有把握,坡矮就是没把握,但用户看不到那张表,看到的只有挑出来之后拼成的句子。而句子不会告诉你它是从柱子上还是从矮坡上挑出来的。
OpenAI 在 2025 年 9 月发过一篇论文,题目直接就叫《为什么语言模型会幻觉》(Why Language Models Hallucinate,作者 Kalai、Nachum、Vempala、Zhang)。开头的例子和我的经历几乎一样:他们问一个常用的聊天机器人,这篇论文作者之一 Adam Kalai 的博士论文题目是什么。它给了三个不同的答案,没有一个对。问他的生日,给了三个不同的日期,同样全错。
那篇论文对”矮坡”给了一个更硬的说法。他们把生成事实的难度归约到一个二分类问题上:一条陈述是真是假,模型分得出来吗?对于有规律的东西,比如拼写、括号配对,见得多了就分得出来,这类错误随模型变大会消失。但对于没有规律、只能靠记的东西,比如某个人的生日,论文里有一句话我觉得说得非常清楚:如果训练数据里 20% 的生日只出现过一次,那基座模型至少会在 20% 的生日问题上编。只见过一次的事实,模型没法验证自己记对没记对,就像你只听人说过一遍的电话号码。
为什么越具体越会编
从这个机制往下推,可以直接推出一个现象:幻觉最爱落在数字、日期、引文、链接、函数参数这类东西上。
原因有两层。
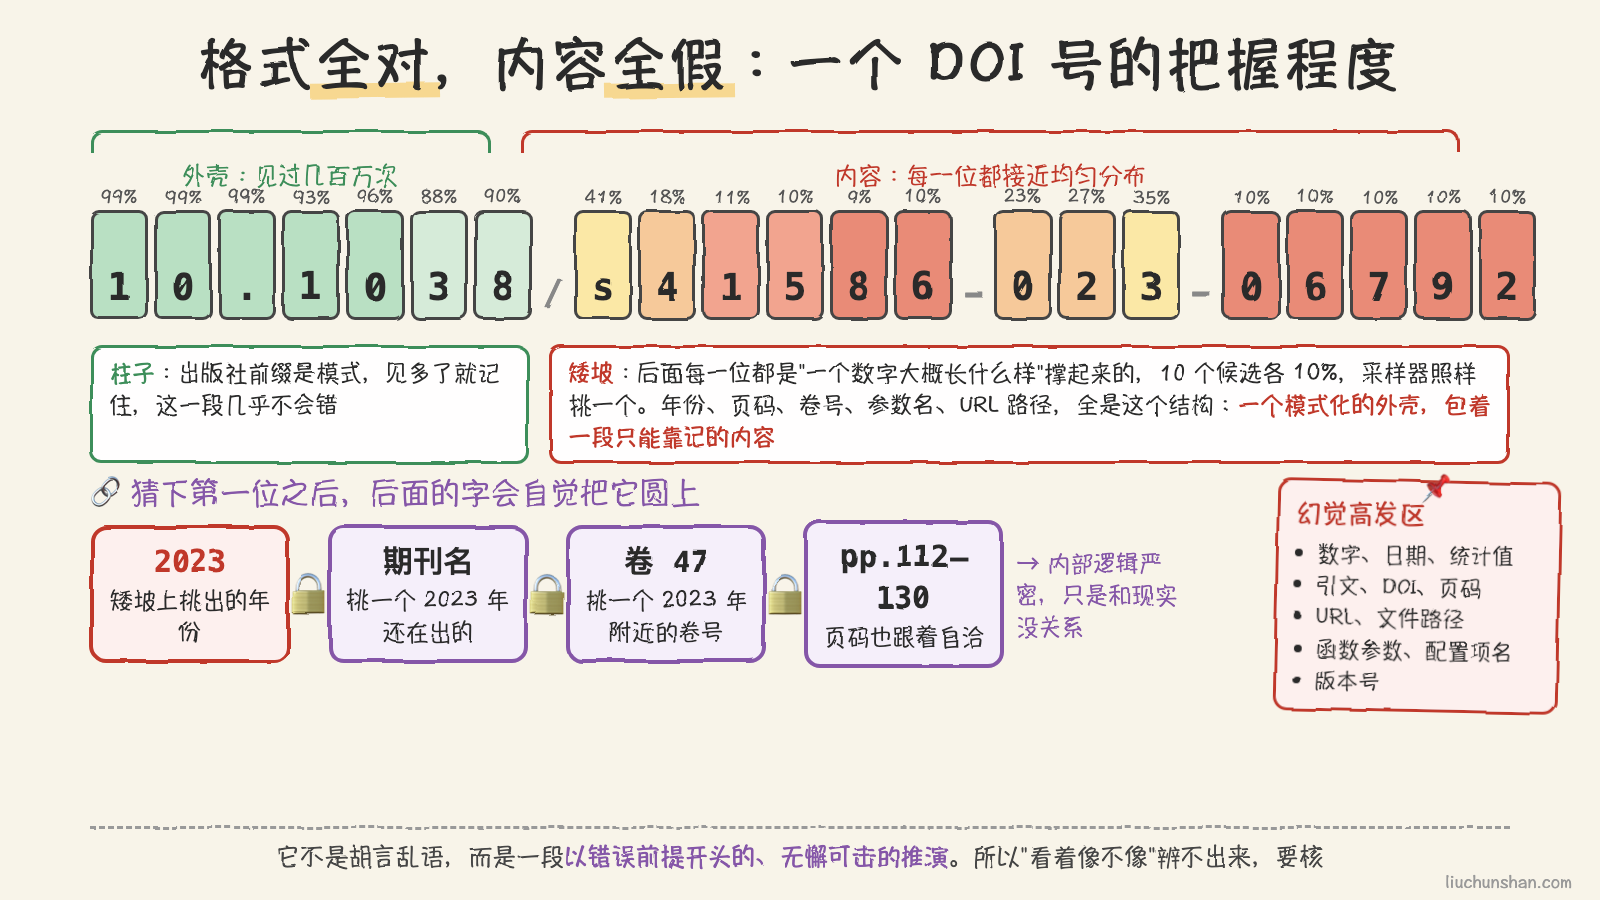
第一层是它们本身就是矮坡。一个 DOI 号,前面的 10.1038/ 是出版社前缀,训练数据里出现了几百万次,模型记得很牢。后面那串数字,每一位都是近乎随机的,模型记不住也没道理记得住。所以它输出的 DOI 前半段总是对的,后半段总是错的,格式完美、内容全假。引文、URL、版本号、函数参数,都是这个结构:一个模式化的外壳,包着一段只能靠记的内容。
第二层更隐蔽:一旦编了第一个字,后面的字会自觉地把它圆上。模型是逐字生成的,每一个字都以前面所有字为条件。当它在矮坡上挑出一个”2023”,这个 2023 就成了后面所有字的前提。后面的期刊名会挑一个 2023 年还在出版的,卷号会挑一个 2023 年附近的,一切都为了和这个 2023 自洽。整段引文内部逻辑严密,只是和现实没有关系。
这也是为什么幻觉很难靠”看着像不像”来识别。它不是胡言乱语,它是一段以错误前提开头的、无懈可击的推演。
更扎心的原因:整条链路都在奖励猜
上面讲的是预训练阶段。理论上,预训练之后还有一大段后训练,专门教模型怎么当一个好助手,本该把”不知道就说不知道”教进去。为什么没教好?
OpenAI 那篇论文的第二个论点就在这里,我觉得比第一个更有解释力:因为评测的计分方式在奖励猜。
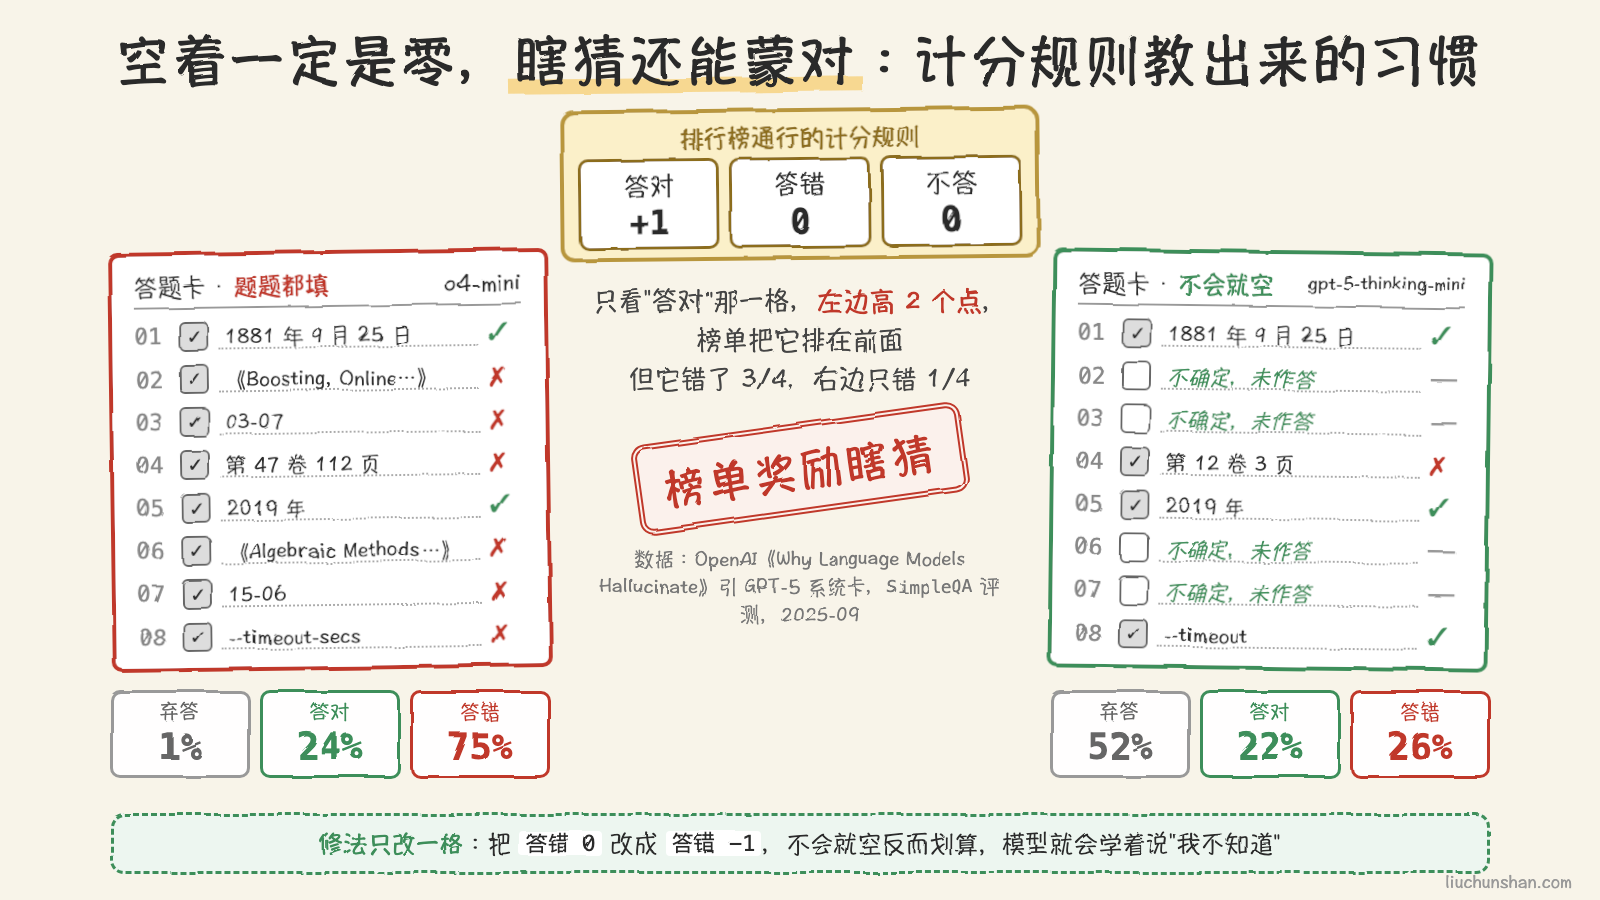
想象一场考试。答对一题得一分,答错零分,空着不答也是零分。你不知道答案怎么办?瞎猜。猜了还有可能蒙对,空着一定是零。一个理性的考生会把每道题都填满,哪怕完全不会。
大模型的排行榜大多就是这么算的:只看准确率,也就是答对的比例。“我不知道”在这种计分下等于答错,甚至比答错还亏,因为答错至少还有蒙对的机会。于是训练过程会自然而然地学到一件事:不确定的时候,给一个最像的答案,别弃权。
论文里放了一组来自 GPT-5 系统卡的数,在 SimpleQA 这个事实问答评测上:
| gpt-5-thinking-mini | o4-mini | |
|---|---|---|
| 弃答率(不给具体答案) | 52% | 1% |
| 准确率(答对) | 22% | 24% |
| 错误率(答错,也就是幻觉) | 26% | 75% |
看准确率,o4-mini 略高,24% 对 22%。只看这一行,它是更好的模型。但它几乎从不弃答,于是错了四分之三。另一个模型一半的题选择不答,代价是准确率低了两个点,换来错误率降到三分之一。
哪个更好用,取决于你怎么算分。而目前大多数排行榜的算法,会把前者排在后者前面。论文的结论很直接:不是缺一个专门测幻觉的评测,而是主流的、以准确率为纲的评测本身要改计分规则,让答错比弃答扣得更多。只要榜单继续奖励蒙对的,模型就会继续学会蒙。
我觉得这个视角的价值在于,它把幻觉从”模型的缺陷”挪到了”激励的结果”。模型没有坏,它只是非常准确地学到了我们用什么给它打分。
给它看,别问它记不记得
理解了机制,就能看清楚现有的几种对策各自在治哪一层。
RAG 和工具调用治的是”矮坡”这一层。它们的思路是不再让模型从参数里回忆事实,而是把事实放进上下文窗口里,让模型去读。读一段摆在眼前的文字,和从几千亿个参数里回忆一条只见过一次的记录,是两个难度完全不同的任务。前面那篇《AI 明明”读”了我上传的文档,为什么还会答错:RAG 讲人话》讲的就是这条路。
但它治不了根。模型在读文档的时候照样可能编。Vectara 维护着一个幻觉排行榜,测法很干净:给模型一段文档,要求它只用文档里的信息做摘要,不许推断,然后看摘要里有多少内容是文档里没有的。2026 年 5 月更新的那版榜单,主流模型的幻觉率从 1.8% 到 23.5% 不等。文档就在眼前,还是有百分之几到百分之二十几的内容是它自己加的。这里面有一个细节我印象很深:同一家的 DeepSeek,普通版 V3 是 6.1%,推理版 R1 是 11.3%。会推理的那个编得更多。这和《AI 想了 30 秒,又把对的答案改错了》里讲的现象是一个方向:推理链越长,模型越有机会把自己的推断当成事实写进去。
让模型输出不确定性治的是”计分”这一层。在提示词里明确写”不确定就说不确定,不要猜”,是有效的,虽然效果因模型而异。它相当于在推理阶段临时改了计分规则,告诉模型这场考试空着不扣分。更彻底的做法是在训练时就这么算分,这正是论文在呼吁的事。
校验治的是最后一层:不管前面怎么防,产出的东西里凡是可以核的,就去核。
我自己怎么做
几条我实际在用的规矩。
把”回忆”改成”查阅”。凡是需要精确事实的场景,文献、数字、命令参数、API 签名、配置项名字,我不再直接问模型”是什么”,而是让它先去查,把文档或搜索结果拉进上下文,再基于拉进来的东西回答。这一步把矮坡变成了柱子。它多花几秒,省下的是我去数据库里一篇篇核对的时间。
数字、引文、链接、参数名默认当作待核对。这四类东西是幻觉的高发区,机制上就注定了。我给自己定了一条硬规矩:这四类内容不核过原文不往外写。写这篇文章时,上面那组 52% 和 1% 的数字,我先凭记忆写了下来,再去论文原文核,结果是对的。但”恰好对了”不是方法,核一遍才是。
读它的措辞,不读它的语气。语气永远是笃定的,机制上它做不到不笃定,因为它输出的是从概率表里挑出来的字,不是概率表本身。但措辞里偶尔会漏出信号:泛泛而谈、绕开具体数字、用”通常""一般来说”兜底。这些时候它多半是在矮坡上。反过来,它开始报具体的年份、页码、参数值,而你没给它任何可以查的材料,就该警惕了。
同一个问题多问几遍。昨天讲评测的时候说过这个方法,今天换个用途。对一个事实性问题,让它回答五遍。五遍答案一致,多半是柱子;五遍五个样,一定是矮坡。OpenAI 论文开头那个例子,同一个人的博士论文题目问出三个不同答案,本身就是最好的幻觉探测器。它不需要你知道正确答案,只需要你看到它自己都不一致。
最后说一句我的看法。“幻觉”这个词起得有点误导,它让人以为模型平时是清醒的,偶尔出神一下。实际情况是它一直在做同一件事:续写。续写得和现实一致就叫回答,不一致就叫幻觉,但这两个名字是我们从外面贴上去的,它内部没有这条分界。所以对付它的正确姿势,不是等它自己变得诚实,而是不给它编的空间:把材料摆在它眼前,把计分规则改成不奖励猜,把产出里能核的都核一遍。
对一个总在续写的东西,别问它记不记得。给它看。
参考:Kalai、Nachum、Vempala、Zhang,Why Language Models Hallucinate,arXiv 2509.04664,2025 年 9 月;Vectara Hallucination Leaderboard,2026 年 5 月更新。
评论