temperature 调成 0,答案为什么还是会变:大模型采样讲人话
做评测的人都干过这件事:把 temperature 设成 0,指望同一个问题每次都给一模一样的答案。结果跑几次,措辞变了,有时结论也变了。这不是 API 坏了。要解释它,得先看清模型每一步吐出来的到底是什么——不是一个词,是整个词表上的一张概率表;temperature、top-k、top-p 各自在这张表上动的是哪一块;"调高更有创意"到底给了谁机会。最后回到那个反直觉的实验:同一个问题问 1000 遍,前 102 个 token 一模一样,第 103 个开始分岔,而分岔的原因跟随机数一点关系都没有,跟"同一秒还有谁在用"有关。
做提示词回归测试的人,多半有过这个经历:为了让结果可复现,把 temperature 设成 0,然后跑三遍。三遍答案不一样。
第一反应是怀疑自己,是不是参数没传对。检查了,传对了。第二反应是怀疑服务商,是不是偷偷加了随机。也不是。它确实在按你说的做,只是”temperature 等于 0”这句话,和”每次结果相同”之间,差着好几层东西。
另一个方向的困惑也很常见:“把 temperature 调高会更有创意”,这句话谁都听过,但调的到底是什么?为什么调高之后不只是更有创意,还会开始胡说?
这两个问题是同一个问题。要回答它,得先看清模型每一步到底交出来的是什么。
模型每次交的不是一个词,是一张表
假设模型正在续写”今天天气真”这句话。
它内部算出来的,不是”好”这一个字,而是词表里每一个候选的分数。词表有几万到十几万个条目,每个条目都被打了一个分,叫 logit(原始分数,还没归一化的那种)。这些分数经过一步归一化(softmax),变成加起来等于 1 的概率。
结果长这样,只列前五个:
| 候选 | 概率 |
|---|---|
| 好 | 0.67 |
| 不错 | 0.25 |
| 热 | 0.06 |
| 冷 | 0.02 |
| 蓝 | 0.005 |
后面还有十几万个候选,概率小到看不见,但不是零。
到这一步,模型的工作就结束了。它交出了一张概率表,然后退场。从这张表里挑出哪一个字,是另一个环节的事,叫采样。 temperature、top-k、top-p 这些参数,没有一个在改模型,全都在改采样这一步。
这个分工是理解后面所有事情的基础:模型算分,采样器挑字,每生成一个字重复一次。
temperature 在动什么
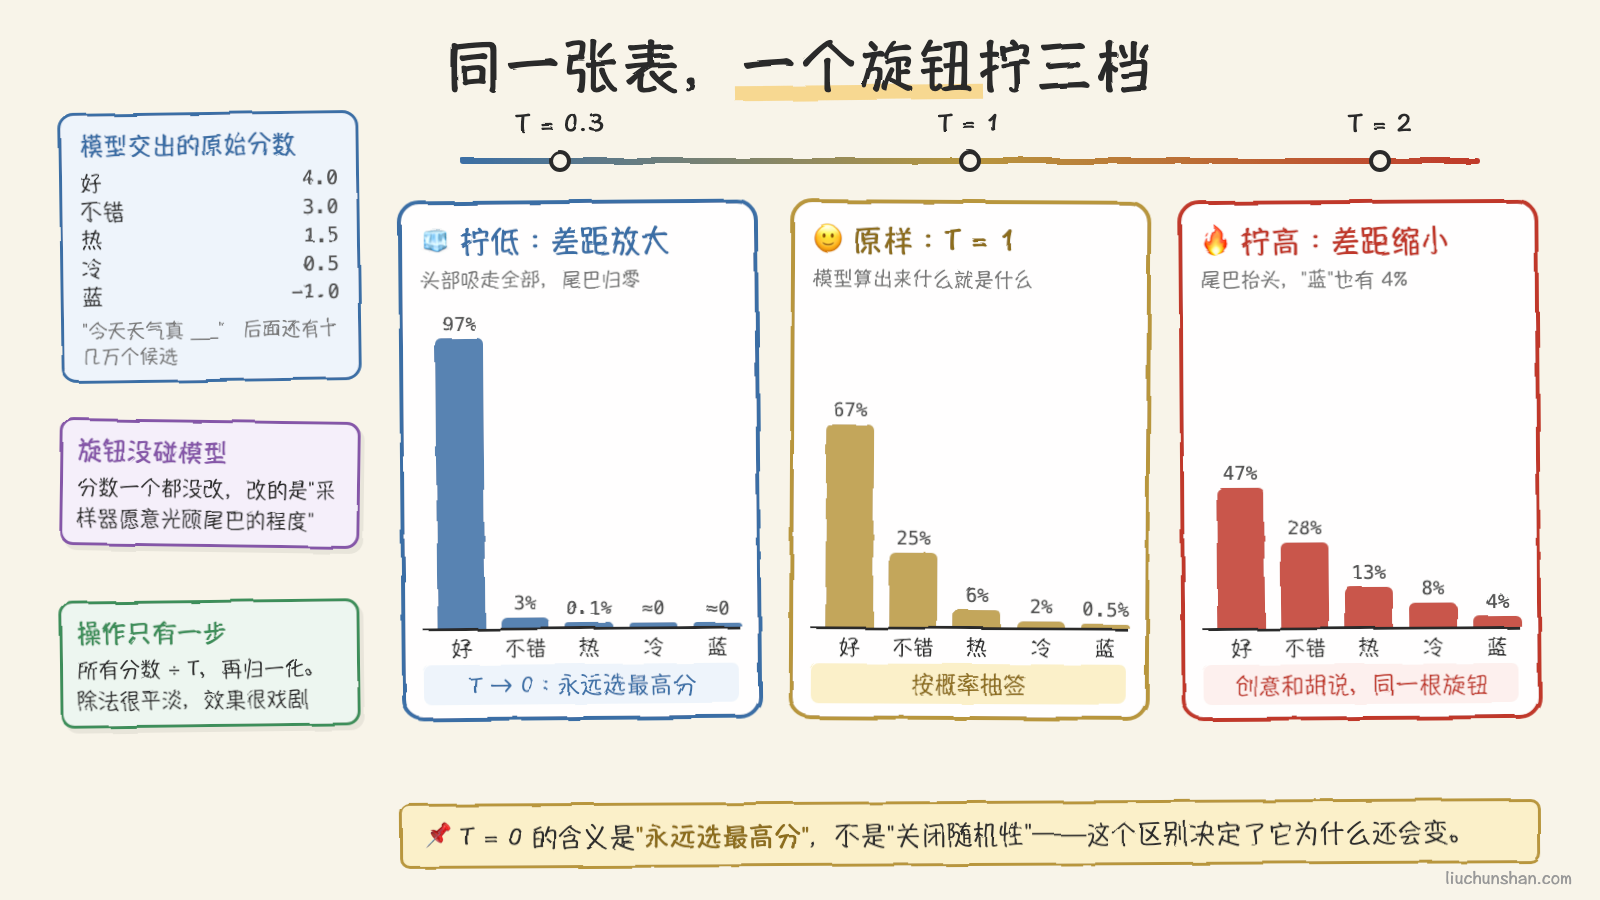
temperature 是最先动手的那个参数。它的操作只有一步:把所有 logit 除以 T,然后再做归一化。
除法看起来平淡,效果却很戏剧。还是上面那组分数,换几个 T 看看:
| 候选 | T = 0.3 | T = 1 | T = 2 |
|---|---|---|---|
| 好 | 0.97 | 0.67 | 0.47 |
| 不错 | 0.03 | 0.25 | 0.28 |
| 热 | 0.000 | 0.06 | 0.13 |
| 冷 | 0.000 | 0.02 | 0.08 |
| 蓝 | 0.000 | 0.005 | 0.04 |
T 小于 1,分数之间的差距被放大,头部的候选把概率吸走,尾巴被压平。T 大于 1,差距被缩小,分布变得扁而宽,尾巴上那些原本几乎不可能的词开始有像样的机会。
T 趋近于 0 是个极限情况:差距被放大到无穷,概率最高的那个候选拿走全部概率,其他的全归零。这时候采样退化成”直接选最大的”,叫 greedy(贪心)。所以 temperature 等于 0 的含义是”永远选最高分”,不是”关闭随机性”。这个区别后面会变得很重要。
这里顺便可以把”更有创意”这句话拆开了。调高 T,模型没有变得更聪明,它算出的分数一个字都没改。变的只是采样器愿意光顾尾巴的程度。尾巴上有意外的好词,也有垃圾。“蓝”在 T 等于 2 的时候拿到了 4% 的机会,写诗的人可能觉得”今天天气真蓝”有点意思,写工单的人只会觉得模型坏了。
创意和胡说是同一根旋钮的两头,这不是比喻,是数学上的同一个操作。
三种筛子,各筛各的
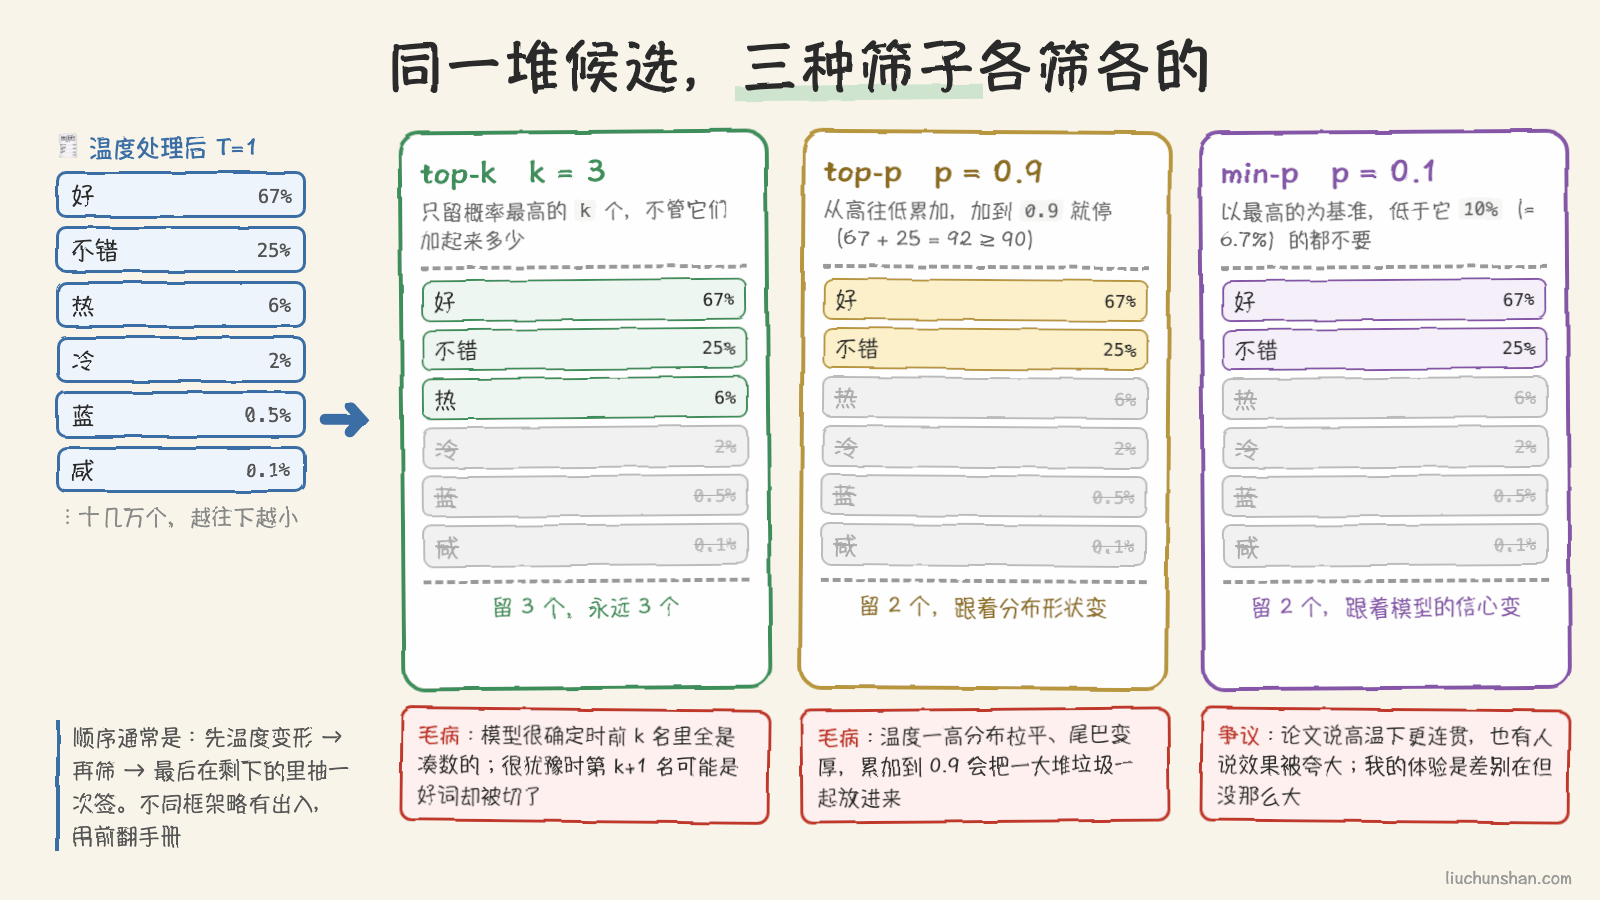
温度拧高之后,尾巴上那些垃圾词就成了问题。于是人们在温度之后又加了一道筛选,把尾巴直接切掉,只在剩下的候选里抽签。切法有三种。
top-k:只留概率最高的 k 个。k 等于 40,就只在前 40 名里抽。简单,但很僵硬。模型很确定的时候,前 40 名里有 39 个是凑数的垃圾;模型很犹豫的时候,第 41 名可能是个好词却被切掉了。
top-p:也叫核采样。从高到低累加概率,加到 p 就停,只留累加进来的那些。p 等于 0.9 时,上面那张表在 T 等于 1 的情况下留”好、不错”两个就够了(0.67 加 0.25 等于 0.92)。它会跟着分布的形状变:模型确定时候选少,模型犹豫时候选多。这是今天大多数框架的默认选项。
min-p:更晚出来的一种,2024 年才有论文。规则是以最高概率为基准,低于它某个比例的都不要。设成 0.1,最高概率是 0.67,那阈值就是 0.067,“热”以下的全切掉。它针对的是 top-p 在高温下的一个具体毛病:温度一高,分布被拉平,尾巴变厚,累加到 0.9 会把一大堆低质量候选一起放进来。min-p 跟着最高候选走,模型有信心时筛得狠,没信心时放得宽。论文说它在高温下比 top-p 更能保住连贯性,不过后来也有人写文章说这个效果被夸大了,我自己的体验是差别存在但没有宣传的那么大。
三种筛子的执行顺序通常是先温度后截断,最后在剩下的候选里按概率抽一次签。不同框架的实现顺序略有出入,这一点用之前最好翻一下手册。
那 temperature 等于 0,为什么还会变
把上面的逻辑走一遍:T 等于 0,永远选最高分。模型算出的分数由权重和输入决定,权重不变,输入不变,分数应该不变,最高分应该不变,答案应该不变。
理论上是这样。实践里不是。
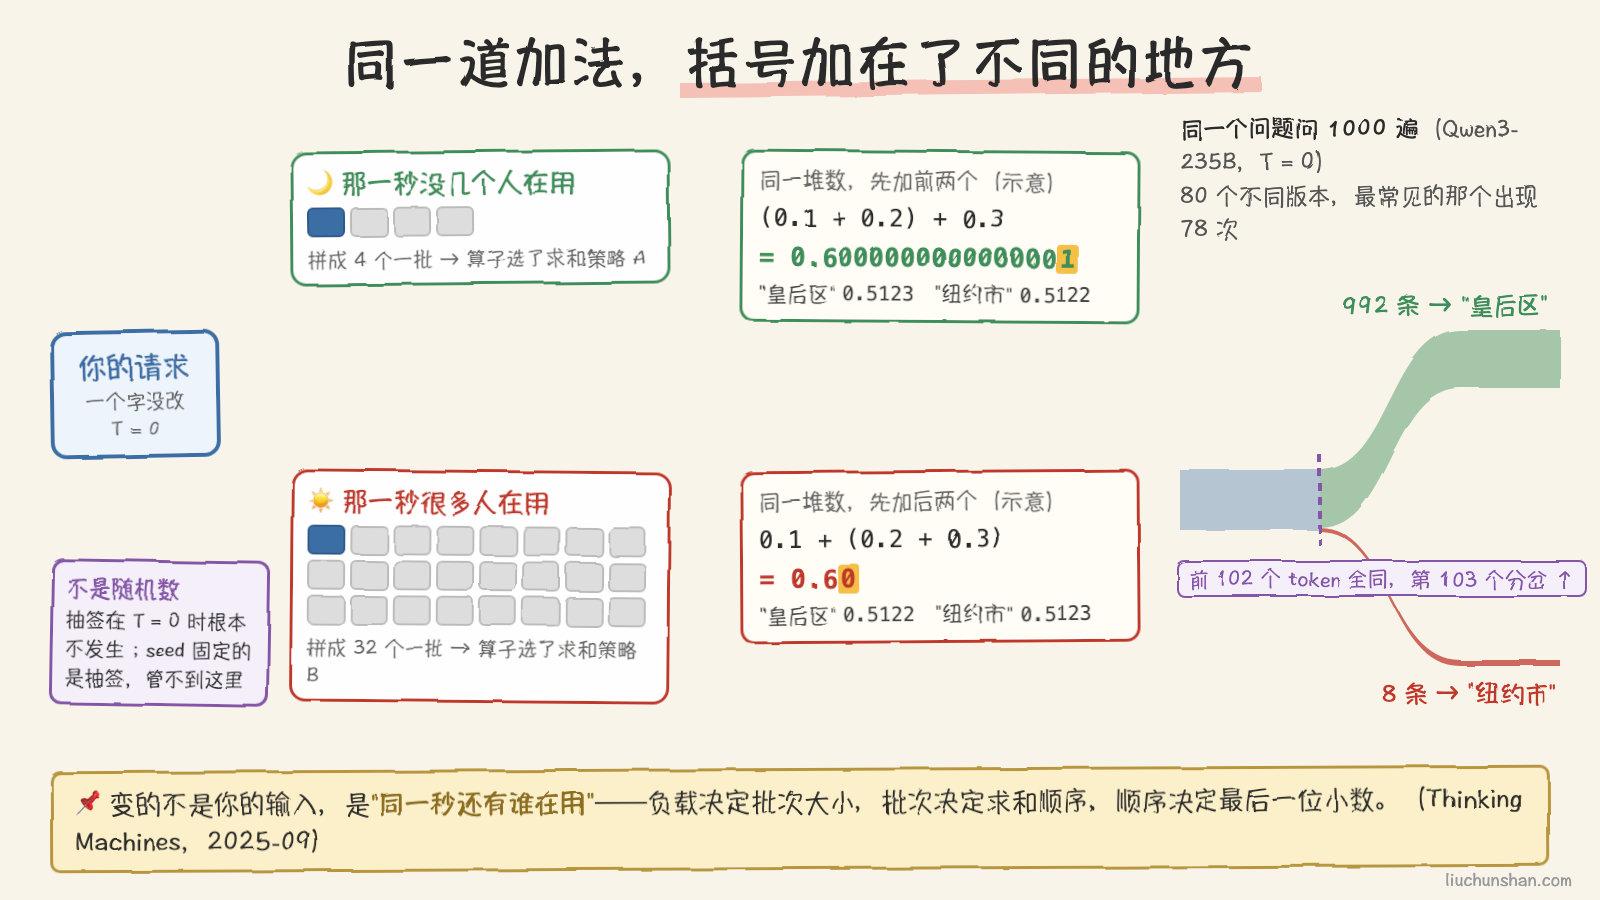
2025 年 9 月,Thinking Machines 的一篇博客做了个很干净的实验。用 Qwen3-235B,temperature 设 0,同一个问题”介绍一下费曼”问 1000 遍。结果 1000 条回答里有 80 个不同版本,最常见的那个出现了 78 次。更有意思的是分岔点:所有 1000 条回答的前 102 个 token 完全相同,到第 103 个,992 条写的是”皇后区,纽约”,8 条写的是”纽约市”。
这个现象业内早就知道,通行的解释是”GPU 上并行计算,浮点加法顺序不固定,所以结果有微小抖动”。这个解释对了一半。
对的那一半:浮点数加法确实不满足结合律。在计算机里,(0.1 加 0.2) 加 0.3 和 0.1 加 (0.2 加 0.3) 算出来是两个不同的数,差在最后一位。神经网络里到处是几千项的求和,加的顺序一变,结果的最后几位就跟着变。两个候选词的分数如果本来就只差一点点,这最后几位就足够让它们交换排名。第 103 个 token 就是这样翻过去的:两个说法本来概率就接近,一点抖动就换了赢家。
错的那一半:GPU 上同样形状的计算,反复跑,加法顺序其实是固定的,逐次结果完全一样。那抖动从哪来?
答案是批次。线上服务不会一个请求一个请求地算,它把同一时刻到达的请求拼成一批一起算。你的请求和另外 3 个人拼成一批,还是和另外 31 个人拼成一批,底层调用的计算核心会按批次大小选择不同的求和策略,加法顺序就变了。你的输入一个字没动,但和你拼批的人变了,最后几位就变了。
所以那篇文章的结论是:推理结果不确定,主要原因是服务器负载在不停变化,负载决定批次大小,批次大小决定数值的最后几位。你在 temperature 等于 0 时看到的不一致,本质上是”同一秒还有谁在用”这件事泄漏进了你的答案。
他们的修法也印证了这个判断:把三个核心算子(RMSNorm、矩阵乘法、注意力)改写成”不管批次多大都用同一种求和顺序”的版本,再跑 1000 遍,1000 条回答完全一致。代价是速度:在 Qwen3-8B 上跑 1000 个请求,默认实现 26 秒,改写后 55 秒,优化过注意力算子之后 42 秒。慢了六成,换来的是逐位一致。
这笔账线上服务一般不会算。多数场景下,用户宁可快一点,也不在乎第 103 个字是”皇后区”还是”纽约市”。所以公开的 API 通常只承诺”temperature 等于 0 时尽量确定”,不承诺逐字相同。
顺手澄清几个常见误会
seed 参数不能保证复现。有些 API 提供 seed,让你固定随机数种子。它固定的是抽签用的随机数,不是上面说的批次抖动。抽签在 T 等于 0 时本来就不发生,所以 seed 对这个问题基本没用。它能帮上忙的是 T 大于 0 的场景:同样的分布,同样的种子,抽出同样的结果,前提是分布本身没抖。
本地单独跑会稳很多,但不是绝对。自己起一个推理服务,只发一个请求,批次大小固定是 1,抖动来源就少了一大块。但换一个推理框架版本、换一张卡、换一个 CUDA 版本,算子实现可能不同,结果又会变。同一台机器同一套软件反复跑,才接近逐位一致。
确定不等于正确。这一点最容易被忽略。temperature 等于 0 选的是”模型最有把握的那个词”,不是”对的那个词”。模型在编的时候也可以非常有把握。所以 T 等于 0 解决的是可复现,不是可信。
T 等于 0 不总是最好的输出。贪心每一步选最高分,但一串局部最优拼起来未必是全局最优,有时会陷进重复的循环里,同一句话来回说。写代码、做数学这类要求精确的任务,低温确实好;开放式写作,稍高一点的温度配 top-p 或 min-p 往往读起来更自然。
我自己怎么用
做评测的时候,我不再指望 T 等于 0 给出唯一答案。改成同一个问题跑 5 到 10 遍,看答案的分布:如果 10 遍里 9 遍结论一致,那这个 prompt 是稳的;如果 5 遍 5 个样,说明模型在这个问题上本来就没把握,用哪个温度都救不了,得改 prompt 或者补上下文。把”抖动”当成一个信号来读,比把它当成噪声去消更有用。
生产环境里要精确输出的场景,比如抽字段、分类、生成结构化数据,T 设低,配 top-p 收紧。要文风的场景再往上调,但一般不超过 1,超过之后垃圾词的比例上升很快。
最后说一句我自己的看法。temperature 这个名字取得很好,但也害了不少人:它让人以为模型有一个”随机性开关”,关掉就是确定的机器。实际上模型从来不输出答案,它输出的是一张概率表,答案是我们从表里挑出来的。挑的规则可以调,但那张表本身,从权重到最后一位小数,都活在一个和别人共享算力的物理世界里。第 103 个字的分岔,不是模型在犹豫,是这个世界的噪声透过来了一点点。
参考:Thinking Machines,Defeating Nondeterminism in LLM Inference,2025 年 9 月;min-p 论文 arXiv 2407.01082。
评论