模型压掉四分之三,为什么没把它压傻:量化讲人话
同一个模型在下载页上摆着四五个版本,名字里带着 FP16、Q8、Q4_K_M、AWQ,体积从 140G 到 35G 不等。直觉上小的那个应该是缩水版、阉割版,用起来该明显变笨才对——但实际跑下来,大多数任务上你几乎感觉不出差别。这篇讲清楚量化到底动了什么:每个参数省下的那几个比特是怎么省的、为什么砍掉四分之三的信息模型还认得路、为什么难的不是权重而是激活值、以及压完之后真正变快的只有一半。
第一次在本地跑开源模型的人,大概都会在下载页前面愣一下:同一个模型名字底下摆着四五个文件,FP16 的一百多个 G,Q8 的一半,Q4_K_M 只剩三十几个 G。
体积差了四倍。按常识想,这应该是”完整版”和”精简版”的关系,小的那个多半砍了点什么,拿来干正事会露怯。于是很多人第一反应是选大的,然后发现显存不够,再不情不愿地退回小的,心里觉得自己在将就。
实际用下来会有点意外:大多数时候,你分辨不出来。同样的问题,两个版本给的答案措辞不同,但对错是一样的。
这件事值得讲清楚。它叫量化(quantization),是今天所有能在个人显卡上跑的开源模型背后那一步——也是少数几个”听起来像在偷工减料,但数学上确实站得住”的技术。
先算一笔字节账
模型文件里存的是什么?就是参数,一堆浮点数。所谓 7B、32B、70B,说的就是参数有 70 亿、320 亿、700 亿个。
文件多大,取决于每个参数用几个字节存:
- FP16 / BF16:每个参数 2 字节。这是模型训练出来时的原始格式。
- INT8:每个参数 1 字节。
- INT4:每个参数 0.5 字节。
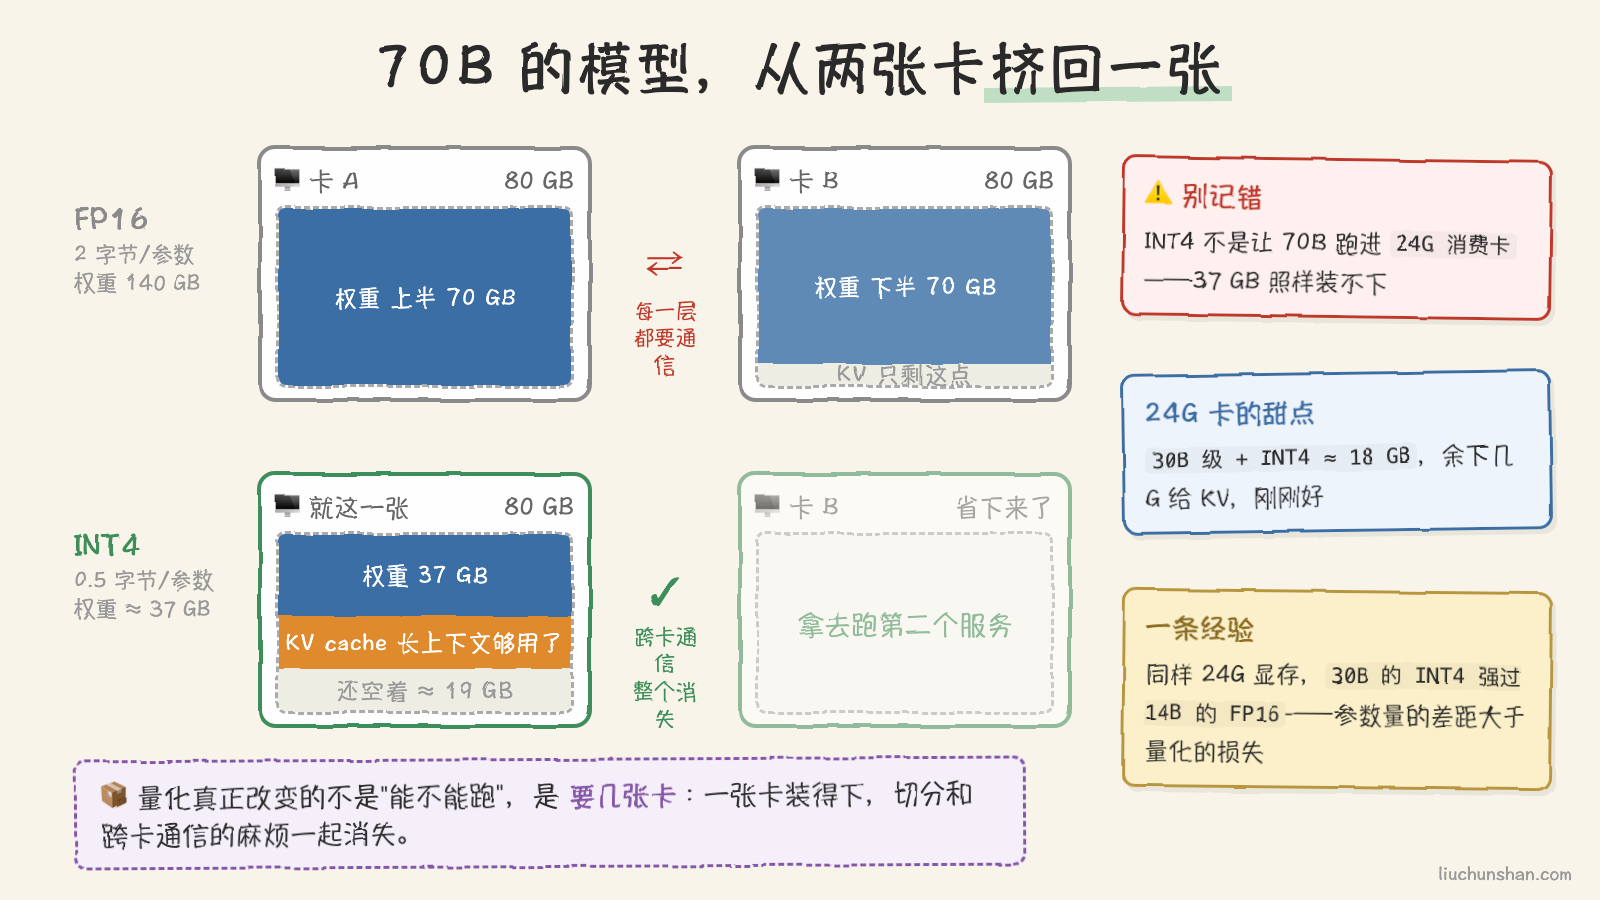
所以一个 70B 的模型,原始格式是 140 GB,压到 4 位就是 35 GB 左右。实际会比这个数大一点(下面会讲为什么),大约 37 到 40 GB。
这笔账的意义很直接:140 GB 的模型,单张卡装不下,怎么切都得两张甚至更多。而 37 GB 可以整个塞进一张 48G 或 80G 的卡里。这才是量化真正改变的事情——不是让 70B 跑进你的 4090,那是装不下的,而是把两张卡的活儿压回一张卡,把跨卡通信这个麻烦整个消掉。
至于消费级的 24G 显卡,甜点区是 30B 级别的模型配 INT4,权重十七八个 G,再留几个 G 给 KV cache,刚好。7B、14B 这种,INT4 之后只剩三五个 G,跑起来毫无压力。
16 位里到底存了什么
要理解砍掉的是什么,得先看没砍之前存了什么。
一个 16 位浮点数,位是这么分的:1 位符号,剩下 15 位分给指数和尾数。指数管”数量级有多大”,尾数管”精度有多细”。
两种分法:
- FP16 是 1 位符号 + 5 位指数 + 10 位尾数。精度细,但能表示的范围窄。
- BF16 是 1 位符号 + 8 位指数 + 7 位尾数。精度粗一半多,但范围和 32 位浮点一样宽。
训练大模型普遍用 BF16,原因就在这个取舍上:训练过程中梯度的数量级会剧烈变化,一旦超出表示范围就直接变成 0 或者无穷大,整个训练就废了。宁可精度粗一点,也要保住范围——这是训练界用真金白银换来的共识。
到了推理阶段,情况反过来了。模型已经训完,参数固定,不会再有梯度爆炸这回事。这时候再问一句:这 16 位里,有多少是真正被用上的?
4 位怎么可能够
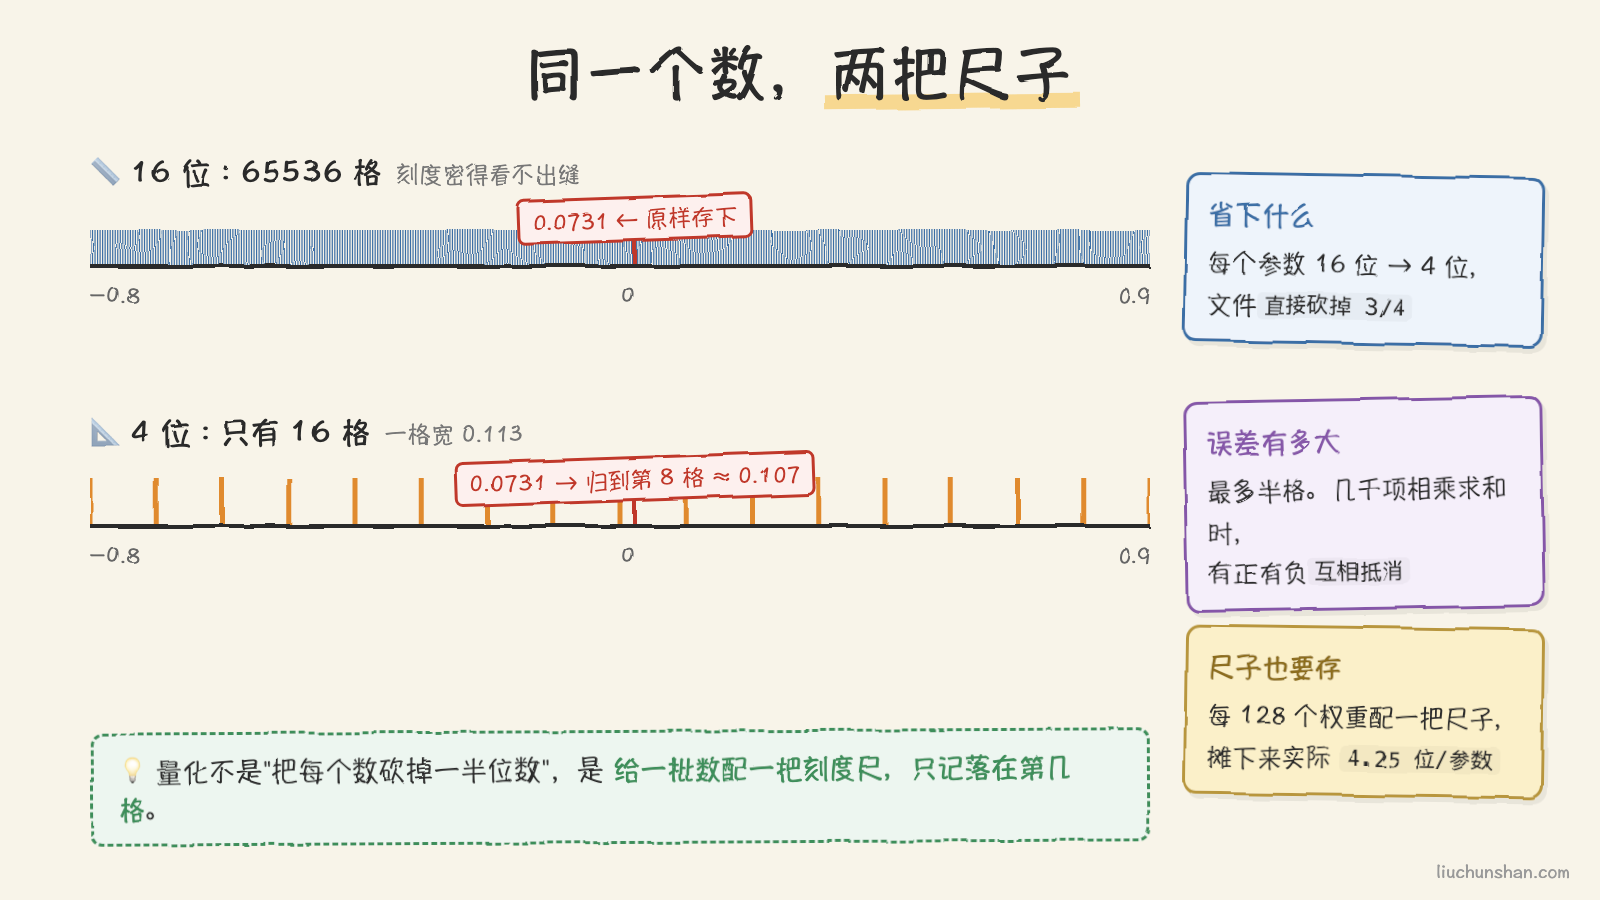
关键的误解在这里:量化不是”把每个数的二进制砍掉一半位数”。
它做的是另一件事——给一批数配一把刻度尺。
假设有一组权重,值都落在 -0.8 到 0.9 之间。4 位能表示 16 个不同的值。那就把 -0.8 到 0.9 这个区间切成 16 格,每个权重记下自己最接近哪一格的编号,编号只要 4 位。同时把”这把尺子是从哪到哪、一格多宽”记下来,这个叫 scale。
还原的时候,拿编号乘以 scale 再加上偏移,就得到一个近似的原值。误差是有的,最多半格。
所以关键问题变成了:这把尺子给多少个数共用。
如果整个模型几十亿个参数共用一把尺子,那肯定完蛋——参数之间数量级差得远,尺子得拉得极宽,绝大多数值会被挤进同一两格里,全都还原成同一个数。
实际做法是分组:每 128 个权重一组,每组自己配一把尺子。这样每组内部的数值范围很接近,16 格够用了。
这也解释了刚才那个”实际比 35 GB 大一点”——每 128 个 4 位权重,要额外存一个 16 位的 scale(有的方案还要存一个零点),摊下来每个参数实际占用 4.25 到 4.5 位而不是整 4 位。这笔额外开销是量化能成立的必要成本。
为什么没变笨
分组这件事解决了技术可行性,但还没解释”为什么效果几乎不掉”。有两个原因。
一是权重的分布本来就很挤。训练好的模型,同一层里的权重绝大多数都是接近 0 的小数,真正的大值是少数。分成 128 个一组之后,组内的值高度集中,切 16 格足够把它们区分开。信息论上,这 16 位里本来就有很多位在存”这个数具体是 0.0731 还是 0.0734”,而这种区别对最终输出基本没有影响。
二是误差会互相抵消。模型算的是矩阵乘法,本质上是几千项相乘再求和。每一项各带一点量化误差,有正有负、大致独立,加起来的时候统计上相互抵消。四千项各差半格,和的相对误差远小于半格——这是大数定律在帮忙。参数越多、维度越高,抵消得越充分。
所以有个略反直觉的结论:模型越大,越扛得住量化。7B 的模型压到 4 位可能会明显感觉到质量下降,70B 压到 4 位往往看不出来。小模型本来参数就紧张,每个参数都在满负荷工作,经不起折腾。
真正难的地方:一个离群值毁掉一把尺子
上面那套逻辑有个前提:组内的值范围接近。
一旦组里混进一个远大于其他值的数,整件事就崩了。假设 127 个值都在 ±0.1 之间,第 128 个是 8.0。尺子必须覆盖到 8.0,于是量程被撑到四十倍宽,一格 0.54——那 127 个值全部被归进最左边那一两格,还原出来全变成差不多的数。
这就是量化里最要命的东西,叫离群值(outlier)。
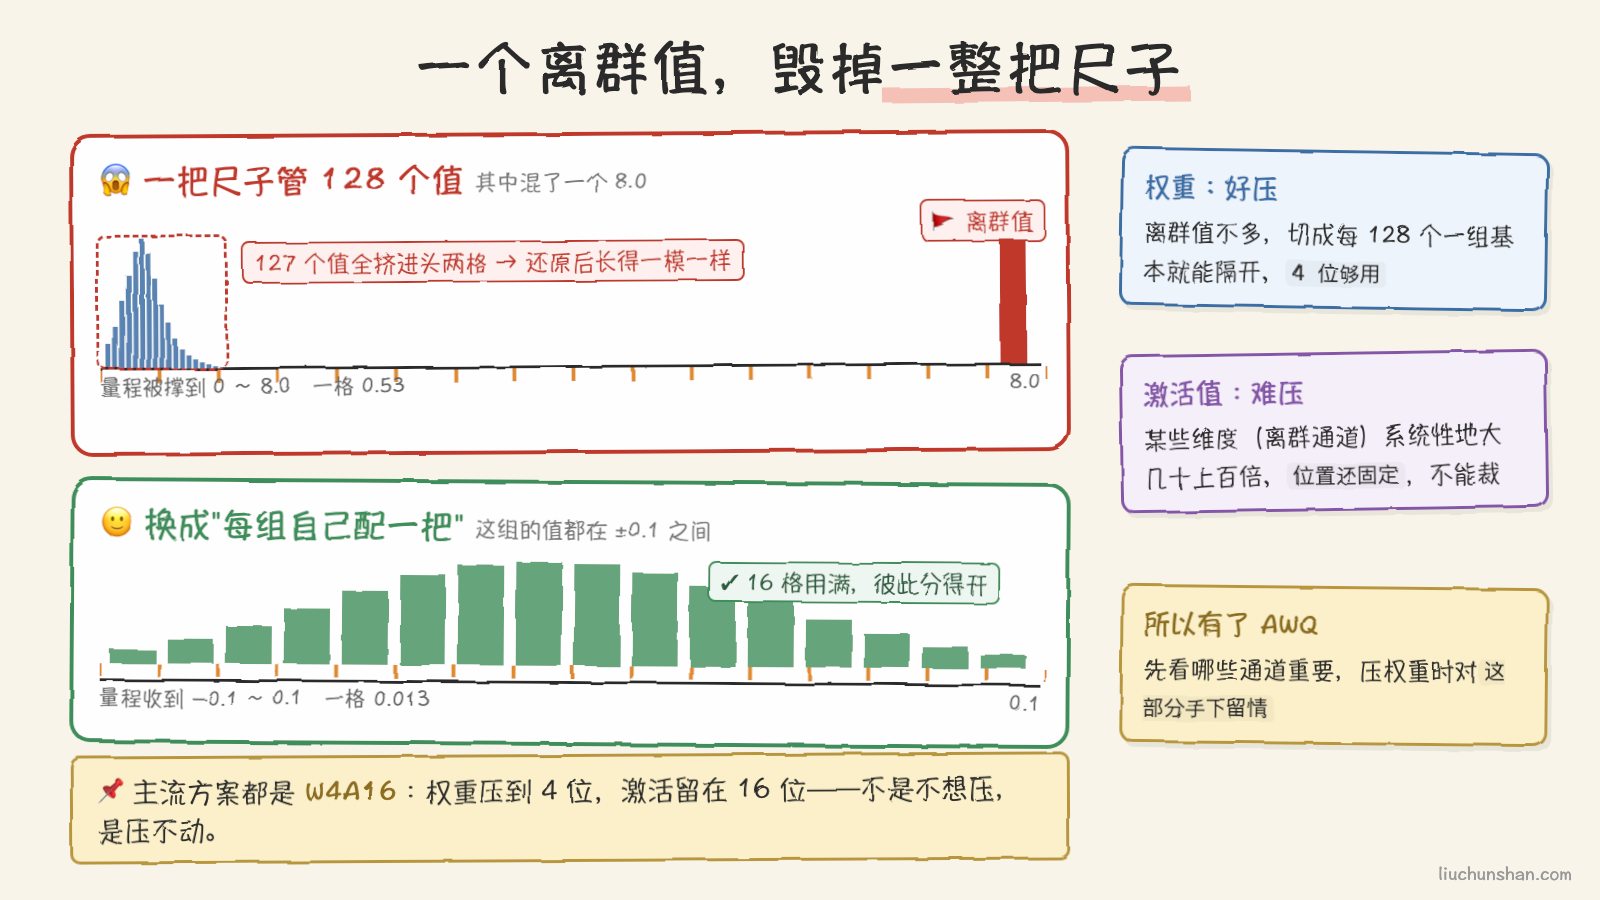
权重里的离群值不算多,分组之后基本能控制住。真正麻烦的是激活值——就是数据流过模型时每一层算出来的中间结果。
大模型有个已经被研究得很透的现象:某些特定的维度(业内叫离群通道)上,激活值会系统性地比其他维度大几十上百倍,而且模型越大越明显。这些离群通道还不是随机出现的,它们固定在那么几个位置上,承载着重要信息,不能简单地裁掉。
结果就是:权重好压,激活难压。
所以今天主流的量化方案几乎都是 W4A16——权重(Weight)压到 4 位,激活(Activation)保持 16 位。你看到的 GPTQ、AWQ 都属于这一类。AWQ 名字里的 A 就是 activation-aware:它的思路是先看激活值哪些通道重要,然后在压权重的时候对这些通道对应的那部分权重手下留情。
至于把激活也压到 8 位甚至 4 位(W8A8、W4A4),能做,但要额外做离群通道的特殊处理,工程复杂度和精度风险都上一个台阶。
压完之后,只有一半变快了
这是最容易被误解的一点:很多人默认”模型小了四倍所以快四倍”。实际不是。
我之前写过大模型推理为什么要拆成两段:模型处理一次请求分 prefill 和 decode 两步,这两步的瓶颈完全不同。
decode 阶段确实快了。生成每一个 token,都要把整个模型的权重从显存读一遍进计算单元。这一步卡在显存带宽上,算力反而闲着。权重少读四分之三字节,这一步就能接近线性地提速。所以量化之后,“字往外蹦”的速度明显变快。
prefill 阶段不但不快,还可能更慢。把你输入的整段文字一次读进去,是大批量的矩阵运算,瓶颈在算力不在带宽。而 4 位权重没法直接参与计算,得先还原成 16 位——这个反量化动作本身要花时间。除非硬件有原生的低精度计算单元能直接吃 4 位,否则这里是净亏的。
所以量化对体感的改善是不均匀的:首字延迟基本没变甚至略差,之后的吐字速度明显变快。如果你的场景是长输入短输出(比如文档摘要),量化带来的加速会比预期小得多;如果是短输入长输出(比如写代码、写文章),提速会很明显。
哪些地方会先露出破绽
量化的质量损失不是均匀撒在所有任务上的,它有明确的偏好。通常最先出问题的是这几类:
- 数学和代码。这类任务是长链条推理,前一步的结果是后一步的输入,误差会一路累积放大。别的任务差一点无所谓,这里一步错步步错。
- 长上下文。上下文越长,注意力计算的链条越长,同样有误差累积的问题。短对话测不出差别,几万 token 之后可能就测出来了。
- 低资源语言。模型在这些语言上的表示本来就稀疏、边界本来就模糊,再削一刀就容易糊掉。
- 小模型。前面说过,参数少的模型没有冗余可供牺牲。
反过来,日常对话、常识问答、简单的文本改写这类任务,4 位和 16 位放在一起做盲测,很难分得出来。
这也给了一个挺实用的判断方法:你要测量化有没有影响,别拿”你好,请介绍一下你自己”去测,那是最测不出问题的题型。拿你真实业务里最难的那几道题去测,跑上几十遍看稳定性。
我自己的用法
几条不复杂的经验:
自己在本地玩,从 INT4 起步,别一上来就下 FP16。省下来的显存拿去放更大的模型或者更长的上下文,这笔交易几乎总是划算的——同样 24G 显存,30B 的 INT4 比 14B 的 FP16 强,而且强得明显。参数量带来的能力差距,通常远大于量化带来的损失。
要对外提供服务、有质量要求的,先用 INT8 过渡,把评测跑一遍,确认掉多少心里有数了再考虑 4 位。别在没有评测的情况下直接上 4 位然后祈祷。
选具体方案时,同为 4 位的 GPTQ 和 AWQ 在多数场景下差别不大,跟着你用的推理框架的推荐走就行,不必纠结。真正影响结果的是”压到几位”和”模型多大”,不是压的算法。
最后说一句我自己的看法。量化这件事有意思的地方在于,它揭示了大模型一个略显尴尬的事实:那些参数里,有相当大一部分精度是白存的。我们用 16 位存下来,不是因为需要 16 位,只是因为训练的时候顺手就是这个格式。真正承载知识的,是这几百亿个数彼此之间的相对关系,而不是每个数小数点后第几位的准确值。
从这个角度看,量化不算压缩,更像是把一直没人注意的水分挤出来而已。
评论