在 system prompt 里写了个当前时间,账单贵了十倍:prompt caching 讲人话
同一段几千字的开场白,每次请求都原样发一遍,模型也原样重算一遍。prompt caching 就是让它别重算:命中缓存的部分只按一折计价。但它是前缀匹配——从第一个不同的字往后,全部作废。所以一个"当前时间:14:32"写在开头,等于宣布后面几千 token 永远全价。这篇讲清缓存到底缓的是什么、为什么只能从头开始匹配、哪些写法会静默地把它毁掉,以及怎么用三个字段确认它真的生效了。
去年我给一个小工具接大模型,写了一段挺长的 system prompt:角色设定、输出格式要求、七八个例子,加起来三千多 token。用户每次问的问题通常就十几个字。
跑了一阵子看账单,我有点纳闷:输入的花销高得离谱,跟输出几乎一个量级。仔细一想才反应过来——那三千多 token 的开场白,每来一次请求就完整地发一遍,模型也完整地重算一遍。用户问的那十几个字反倒是零头。一天一万次请求,就是三千万 token 在反复做同一件事。
解决这件事的机制叫 prompt caching。原理不复杂,但它有一条很硬的规则,踩上去的人会发现自己明明开了缓存,账单一分没少——而且没有任何报错。
缓的到底是什么
要理解缓存,得先知道模型读你的 prompt 时在干什么。
我之前写过大模型推理为什么要拆成两段:模型处理一次请求分 prefill 和 decode 两步。prefill 是把你发过去的整段文字一次性读进去,逐 token 算出每一层的中间结果(业内叫 KV),这一步是并行的、算力密集的;decode 是拿着这些中间结果,一个字一个字往外吐答案。
你反复发的那三千 token 开场白,每次 prefill 都要重新算一遍 KV。但它们每次算出来的结果,完全一样——同样的输入、同样的模型、同样的权重,不可能算出别的。
prompt caching 就是把这份算好的 KV 存起来。下次请求如果开头这三千 token 一模一样,直接把存好的结果搬过来用,prefill 那段活就省了。省下的是实打实的算力,所以厂商愿意把这部分按一折左右计价。
这跟我之前写负载均衡越”公平”,大模型越慢那篇是同一个东西的两面:那篇讲的是服务端怎么把请求路由到”已经存着你那段前缀”的机器上,是运维视角;这篇讲的是你作为调用方,该怎么组织自己的 prompt,才让这份缓存有得可存。
为什么只能从头开始匹配
这是全篇最关键的一句话:缓存是前缀匹配的——从第一个不同的字往后,全部作废。
原因就在 Transformer 的计算方式里。第 N 个 token 的 KV,依赖它前面所有 token 的内容——注意力机制就是让每个位置去”看”前面所有位置。所以你改了第 10 个 token,第 11 个往后每一个的 KV 都跟着变了,一个都不能复用。
反过来说,第 10 个 token 之前的部分不受影响,照样能用。
所以准确的说法不是”改一个字缓存就全没了”,而是”改一个字,这个字之后的全没了,之前的还在”。这一条推论直接决定了 prompt 该怎么排:稳定的东西放前面,易变的东西放后面。
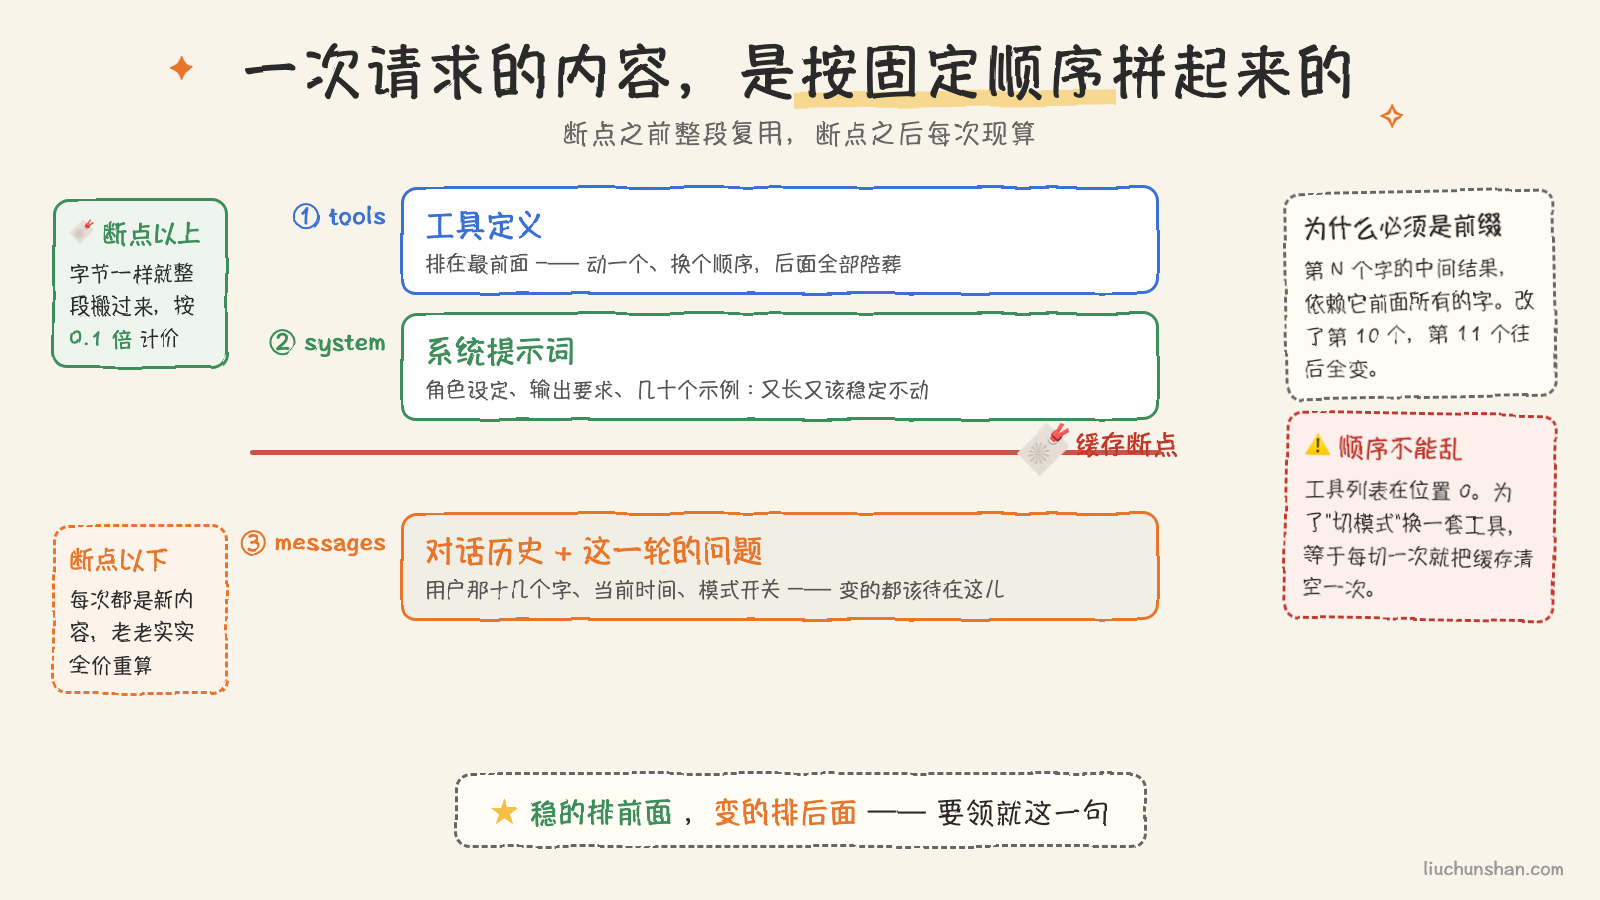
具体到 API 上,一次请求里的内容是按固定顺序拼起来的:先是 tools(工具定义),然后是 system(系统提示词),最后是 messages(对话历史)。你在某个位置插一个「缓存断点」的标记,就等于说”从开头到这里的内容,请存起来”。
这个顺序很重要。工具定义排在最前面,意味着你只要动了工具列表——加一个、删一个、甚至只是换了个顺序——整个缓存就从头作废了,system 和对话历史一起陪葬。我见过有人为了做”模式切换”,在不同模式下给模型不同的工具集,结果每切一次模式,缓存全部重来。更好的做法是工具集固定不变,把模式当成一条消息传进去。
那个时间戳
现在可以说回标题里那件事了。
很多人写 system prompt 时会习惯性地加一行”当前时间:2026-09-15 14:32”,理由很正当——不给的话模型不知道今天几号。
但它坐在 system 的最前面。时间每分钟变一次,意味着这个 prompt 的前缀每分钟就换一份。你后面精心组织的三千 token 上下文、几十个示例,全都排在这个时间戳后面,于是每一次请求都是一次全新的前缀,缓存写进去从来没被读到过——不但没省钱,还要额外付一笔写入的钱。
同一类的杀手还有好几个,共同点是都在前缀里,都每次都变,而且都不报错:
把用户名或会话 ID 拼进系统提示词。这会让缓存变成”每个用户一份”,用户之间完全不共享。如果你的场景是同一段提示词服务很多人,这一下就把缓存的价值削掉大半。
序列化时没固定键的顺序。你把一个字典转成 JSON 塞进 prompt,如果没指定按键名排序,不同次运行出来的字节顺序可能不一样。肉眼看着一模一样,字节层面就是两份不同的东西。
按条件拼接系统提示词。if 开了某个开关: system += "...",看着只有两种情况,实际上几个开关组合起来就是几种不同的前缀,每种都得单独缓存一份。
分叉出去的请求没复用父请求的前缀。做摘要、做压缩、派个子任务出去,这些通常是另起一次 API 调用。如果这次调用把 system 和工具重新拼了一遍、哪怕只差一个空格,它就完全吃不到主请求那份缓存。
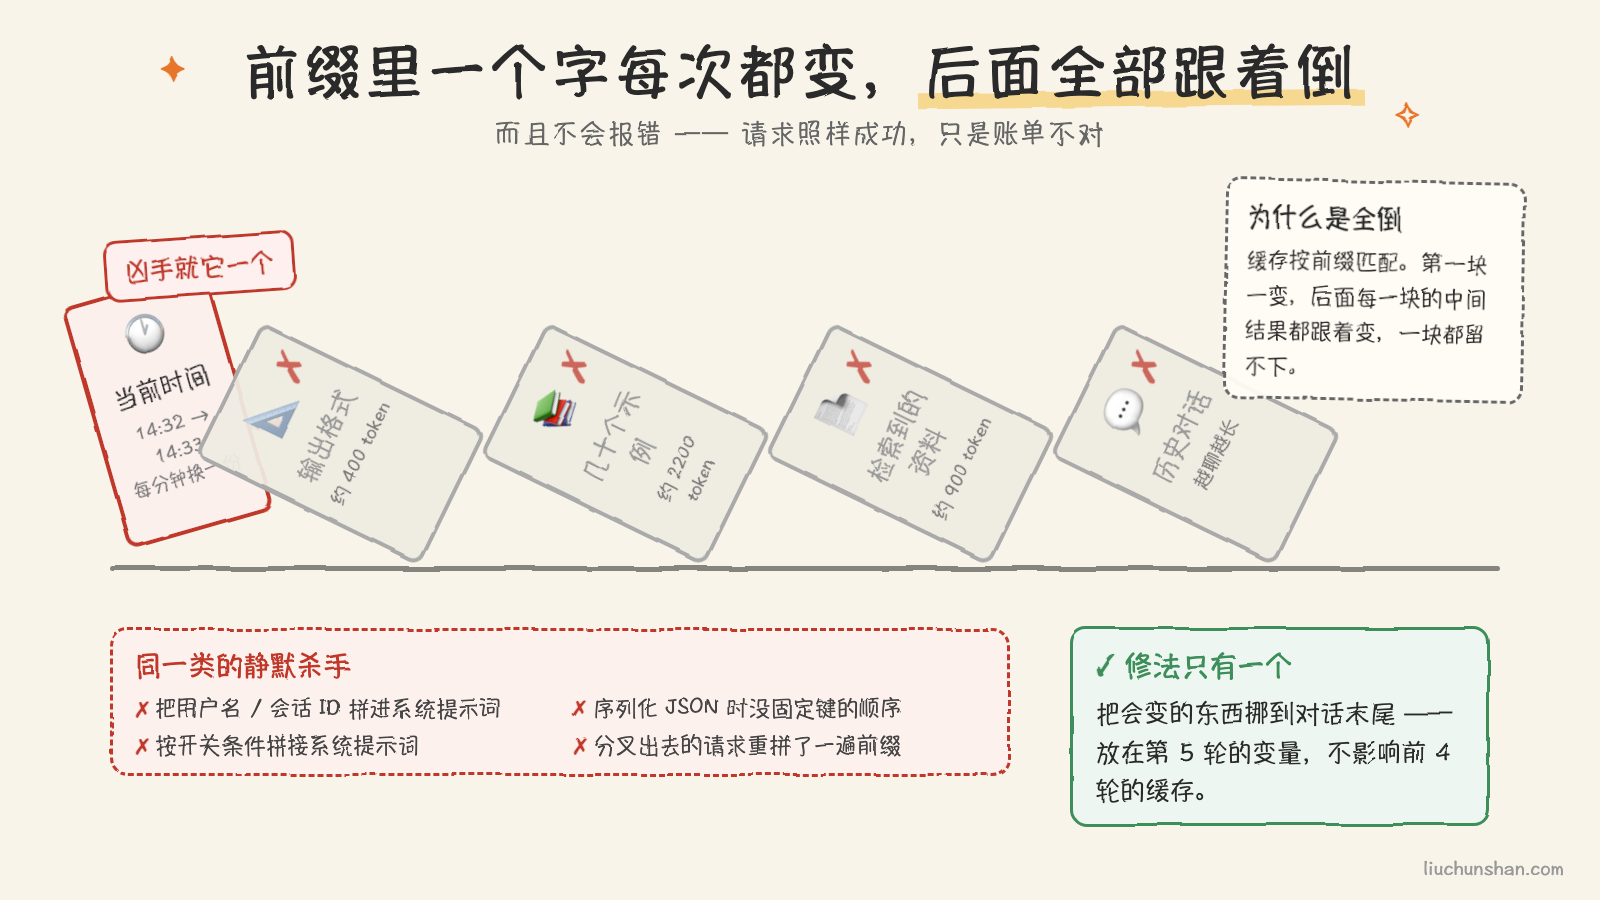
修法都是同一个思路:把会变的东西从前缀里挪出去,放到对话消息的末尾。时间、用户身份、当前模式,这些作为一条消息插在对话后面,只会让它自己之后的部分失效——而它后面本来也没什么东西了。放在第 5 轮对话里的一个变量,不会影响前 4 轮的缓存。
这笔账怎么算
缓存不是白给的,它的计价有三档,得算明白才知道值不值。
- 不走缓存:按输入价原价,记作 1 倍。
- 写入缓存:比原价贵一点,大约 1.25 倍。你要为”存起来”这个动作付一笔钱。
- 读取缓存:便宜一个数量级,大约 0.1 倍。
所以什么时候划算,是一道小学算术题:同一段前缀只用一次,你付 1.25 倍,比不缓存的 1 倍还亏;用两次,1.25 + 0.1 = 1.35 倍,而不缓存要付 2 倍,已经赚了。两次就回本,之后每多一次请求就多省将近九成。
对于那种”一段固定长提示词服务所有请求”的场景,这个杠杆非常大。反过来,如果你的 prompt 每次从第一句就不一样,那它压根没有可复用的前缀,加缓存标记只是白付写入的溢价——这种情况就别开。
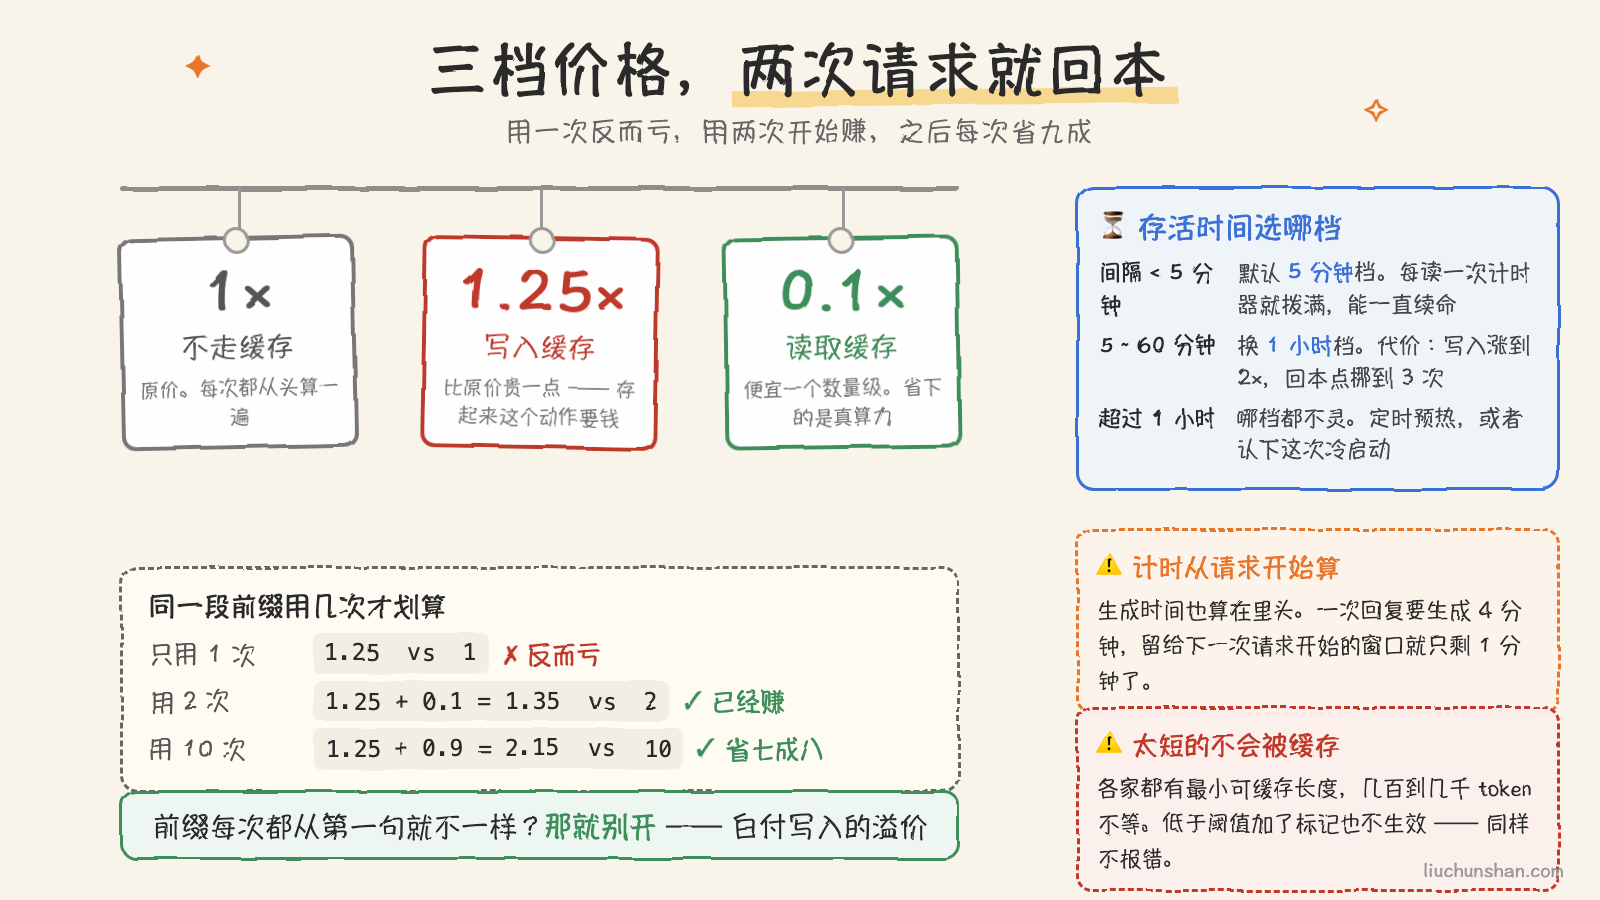
还有个容易忽略的点:缓存条目有存活时间,默认是五分钟,也可以选一小时。但选一小时的代价是写入变成 2 倍,回本点也从两次挪到三次。
判断标准不是”我的对话持续多久”,而是共享同一段前缀的两次请求,间隔多久。有个反直觉的细节:每次读取都会把这个条目的计时器重新拨满。所以只要你的请求密度撑得住五分钟一次,默认的五分钟档能一直被续命,永远不用升级到一小时档。真正需要一小时档的,是那种”用户看完回复想了二十分钟才回下一句”的间歇性场景。
另外,计时是从请求开始算的,生成时间也算在里头。如果一次回复要生成四分钟,那留给下一次请求开始的窗口就只剩一分钟了——长输出的场景要把这一点考虑进去。
怎么确认它真的生效了
这一节我想单独强调,因为缓存失效是静默的:请求照样成功,答案照样正确,只有账单不对。没有任何报错会告诉你”你这次没命中”。
好在返回结果里有三个字段直接给了答案:
cache_creation_input_tokens:这次写进缓存多少 token(付了 1.25 倍)cache_read_input_tokens:这次从缓存读了多少 token(付了 0.1 倍)input_tokens:只是没走缓存的那部分,不是总量
第三条是最容易读错的。我第一次看的时候,见 input_tokens 只有几百,还以为是统计出了 bug——实际上真正的总输入量是这三个数加起来。一个跑了几小时的任务,如果 input_tokens 一直是个小数字,那说明缓存工作得很好,不是没在干活。
最实用的诊断方法:连发两次前缀完全相同的请求,看第二次的 cache_read_input_tokens 是不是大于零。如果一直是零,那前缀里一定藏着个每次都变的东西,去逐字节比对两次请求的内容就能揪出来。
还有一个容易踩的坑:太短的 prompt 压根不会被缓存。各家模型都有一个最小可缓存长度,从几百到几千 token 不等,低于这个阈值,你加了标记也不会生效——同样不报错,只是那两个字段一直是零。要是你确认逻辑没问题却死活不命中,先看看是不是提示词太短了。
最后一句提醒:这件事最贵的失败不是一开始就没配好,而是配好之后被改坏。缓存刚上线时验证过、好用,几个月后有人往 system prompt 里加了个动态字段,或者重构时让工具列表的顺序变得不确定——从那天起每次都全价,没人会收到通知。所以最好把”第二次请求必须有缓存读取”写成一条集成测试的断言,让它自动替你盯着。
写在最后
prompt caching 是那种典型的”原理十分钟讲完,但不知道就会一直亏钱”的东西。它的全部要领其实就一句话:让稳定的内容物理上排在易变的内容前面。
我后来养成一个习惯,写任何要反复调用的提示词之前,先在脑子里把内容分三类:从来不变的、每个会话变一次的、每轮都变的。然后严格按这个顺序往下排。这个动作花不了一分钟,但它决定了缓存能不能工作——而缓存能不能工作,可能就是账单上一个数量级的差别。
顺带一提,这个思路不只对 API 有用。你在编程助手里配置的那些长期规则文件,本质上也是一段每次对话都要重发的固定前缀——把它写得稳定,好处是一样的。
评论