AI 想了 30 秒,又把对的答案改错了:推理模型的 thinking 讲人话
现在的模型大多有个"深度思考"开关,打开之后会先滚一屏灰色小字再回答。那段字不是它在心里琢磨——模型没有心里,那是实打实生成出来的 token,和答案用同一份算力、同一个计价表。搞清楚它是什么,几个困惑就都有了解释:为什么账单会翻三倍、为什么有的任务开了明显更准而有的纯属浪费、为什么想得越久答案有时反而更差,以及最容易被误会的一点——那段看起来条理分明的思考,并不是模型真实决策过程的忠实记录。
前阵子我在同一个对话框里问了两次同样的问题,一次开着”深度思考”,一次关掉。问题很简单,就是让它把一段话改短一点。关掉的那次,两秒钟答案就出来了。开着的那次,界面转了二十多秒的圈,中间滚过一屏灰色小字——“用户希望更简洁""需要注意保留原意""让我先看看哪些是冗余的”——然后给出的改写,和两秒那版几乎一模一样。
那一屏灰色小字,就是现在几乎每个模型都有的那个开关:thinking、reasoning、深度思考、扩展思考,叫法不同,东西是一个。
它看起来像模型在心里琢磨。但”在心里”这三个字特别误导人。模型没有心里。那段字是实打实一个 token 一个 token 生成出来的,和给你的答案走的是同一套机制、同一份算力、同一个计价表。唯一的区别是它被标记成了”草稿”,界面默认不展开给你看。
把这件事想明白之后,几个用起来的困惑就都有了解释:为什么开了之后账单能翻三倍,为什么有的任务开了明显更准、有的开了纯属浪费,以及最反直觉的那个——为什么它想得越久,答案有时候反而更差。
模型没有”心里”,只有草稿纸
先说一个不太直观的事实:一个 Transformer 模型,每生成一个 token,花掉的计算量是固定的。层数是定死的,每层做什么也是定死的,输入进去,穿过所有层,吐出一个 token。不管这个 token 是”的”还是某个需要推导三步才能得出的数字,它经历的计算步数完全一样。
这就带来一个硬约束:一次前向计算能承载的”推理深度”是有上限的。你让它心算 47 × 83,它得在一次前向里把乘法、进位、加法全做完,做不完就只能猜一个看起来合理的数。这也是为什么模型在算术题上经常给出那种”位数对、数字错”的答案——形状对了,里头的计算没走完。
而只要允许它把中间结果写出来,情况就完全不同了。写出来的字会回到输入里,成为下一次生成的条件。“47 × 80 = 3760”这行字一旦落在纸上,下一步就不用再重新算它了,直接读就行。写一行,就多一次完整的前向计算;写一百行,就多一百次。
所以”思考”在这里是字面意义上的多花算力:模型不是想得更深,是把一个深问题拆成了很多个浅步骤,每步各花一次计算。业内管这个叫 test-time compute,推理期算力——训练时的参数一个没变,变的只是回答这一次它肯花多少功夫。
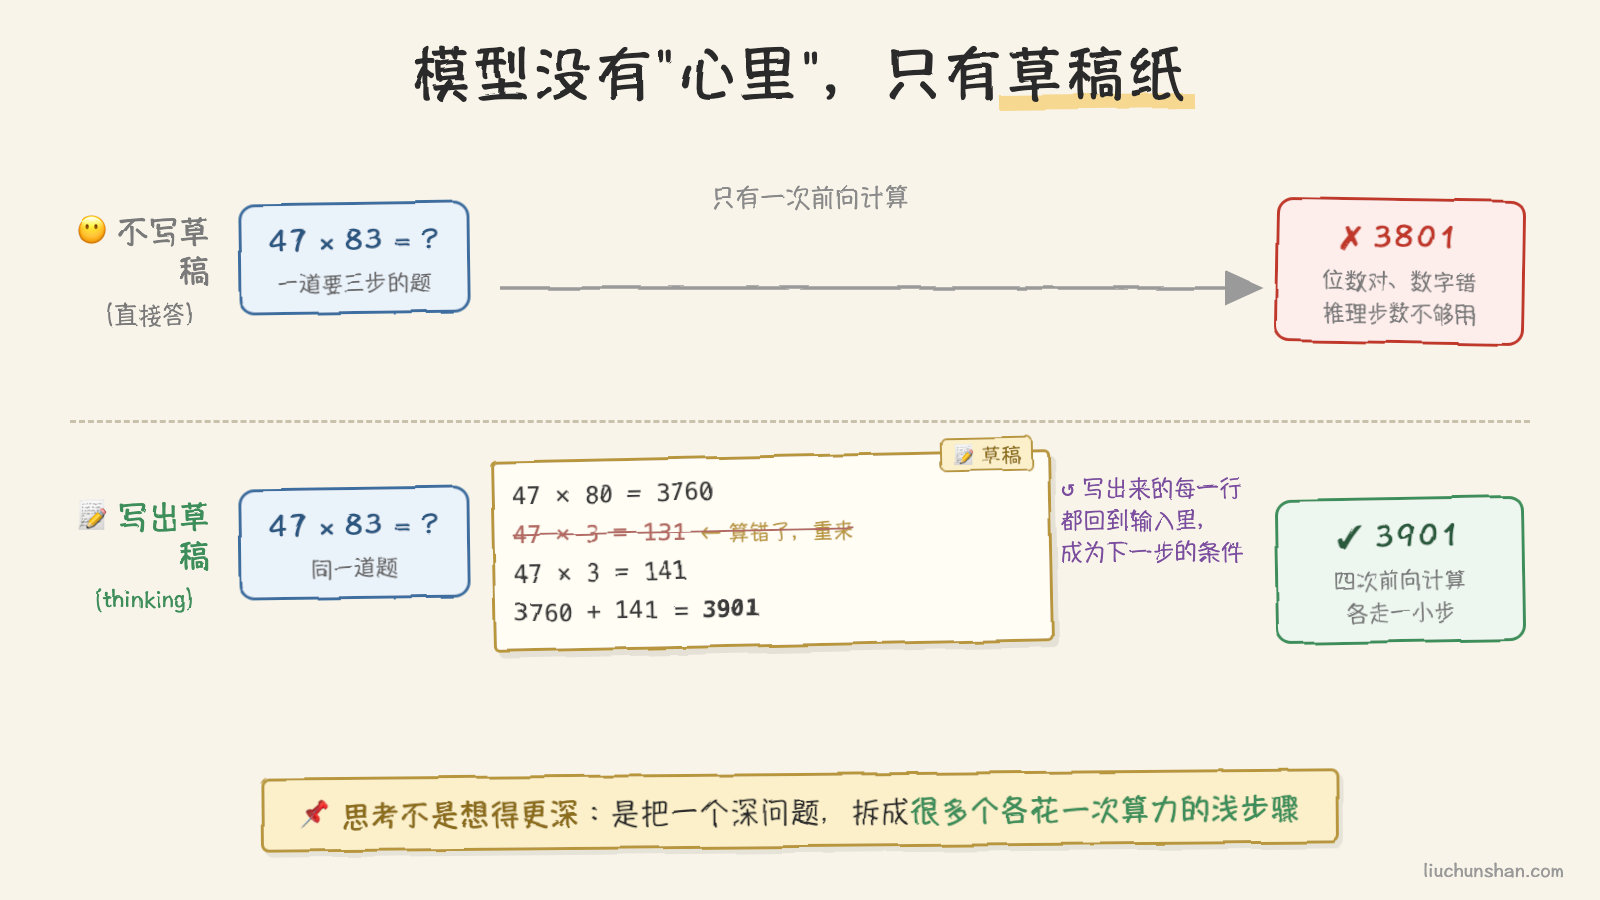
这也解释了为什么早期大家发现”让我们一步一步思考”这句咒语管用。它不是对模型的心理暗示,而是诱导它把中间结果写出来,从而绕开那个硬约束。今天的推理模型只是把这件事从咒语变成了训练目标和产品开关。
多花的那几千个 token,账是这么算的
既然思考就是生成 token,那它就要按 token 收钱,而且按输出价收——输出通常是输入的三到五倍贵。
Claude 官方文档里给过一个很直白的账:一次调用如果用掉 4000 个思考 token 加 600 个回答 token,成本大约是同样一个回答不开思考的三倍。这不是估算误差级别的差距,是账单上一眼能看出来的差距。
还有两个容易踩的细节。一是思考 token 会占用 max_tokens 的额度——你给的预算如果不够思考加回答两份,模型可能思考完就没空间说话了。二是有些模型(比如 Claude 4 系列)展示给你的是思考过程的摘要,但计费按原始长度算:你看到三行,可能花的是三千 token 的钱。看着便宜不代表真便宜。
时间也是成本。那 20 秒的转圈在批处理任务里无所谓,在交互式产品里就是实打实的体验损失——用户不会因为你在后台努力就更有耐心。
什么时候值得开
判断标准其实可以简化成一句自问:这道题我自己需不需要打草稿。
需要打草稿的——多步数学、写一段有状态的代码、排一个有约束条件的日程、从一堆条件里推出结论——开思考的收益很明显,因为这类任务的本质就是”中间结果必须留存”。
不需要打草稿的,收益接近于零。最典型的是知识密集型的问题:问一个事实、查一个定义、回忆某个 API 叫什么名字。有研究专门测过这类任务上的推理期算力扩展,结论是基本无效——模型不知道就是不知道,想再久也变不出它没见过的东西,顶多是把不确定的答案包装得更笃定。这类问题该做的是给它接检索,不是让它多想。
更尴尬的是简单任务。有个叫 OptimalThinkingBench 的评测就专门收集这类简单问题,结果是思考模型在上面平均要多烧几百个 token,准确率和不开思考的模型持平甚至更低。开头我那次改写文案,就正好撞在这个格子里。
还有一类我自己踩过的坑:格式转换和机械改写。让它把一段 JSON 转成表格、把中文标点换成英文标点,思考对正确率没有任何帮助,但它会一本正经地先分析一遍”用户的意图是什么”。这时候思考不是在帮忙,是在给你的延迟和账单上税。
为什么想得越久,有时候反而更差
这是最反直觉的一部分,也是我觉得最该讲清楚的一部分。
思考长度和准确率的关系不是单调上升,而是一条倒 U 形曲线:一开始随着思考变长准确率往上走,到某个点见顶,再往后就开始掉。
掉下来的机制很具体,也很好懂。模型在推导的中途其实已经得到了正确答案,但它没有”我做完了”的判断力,于是继续往下写,开始自我怀疑:“等等,我再验算一下""不对,如果换一种理解方式呢”,然后在一轮轮复查里把对的改成了错的。有研究做过一个很说明问题的实验:在模型第一次得出正确答案的地方直接截断,某些任务上准确率能提升多达 21%。这 21% 就是它后来自己推翻掉的部分。
另一组数据更能说明”长思考不等于认真思考”。研究者把推理模型量化压缩之后发现,模型变笨的同时思考链条反而变长了:3 比特量化让 MATH-500 的准确率从 85.6% 掉到 47.0%,与此同时思维链的平均长度涨了 4.5 倍,从 5.2K token 涨到 23.4K token。同一批实验里还有一个细节——在量化模型答错的案例里,高达 52% 的情况下正确答案其实出现在中间步骤里,只是最终没被选中输出。
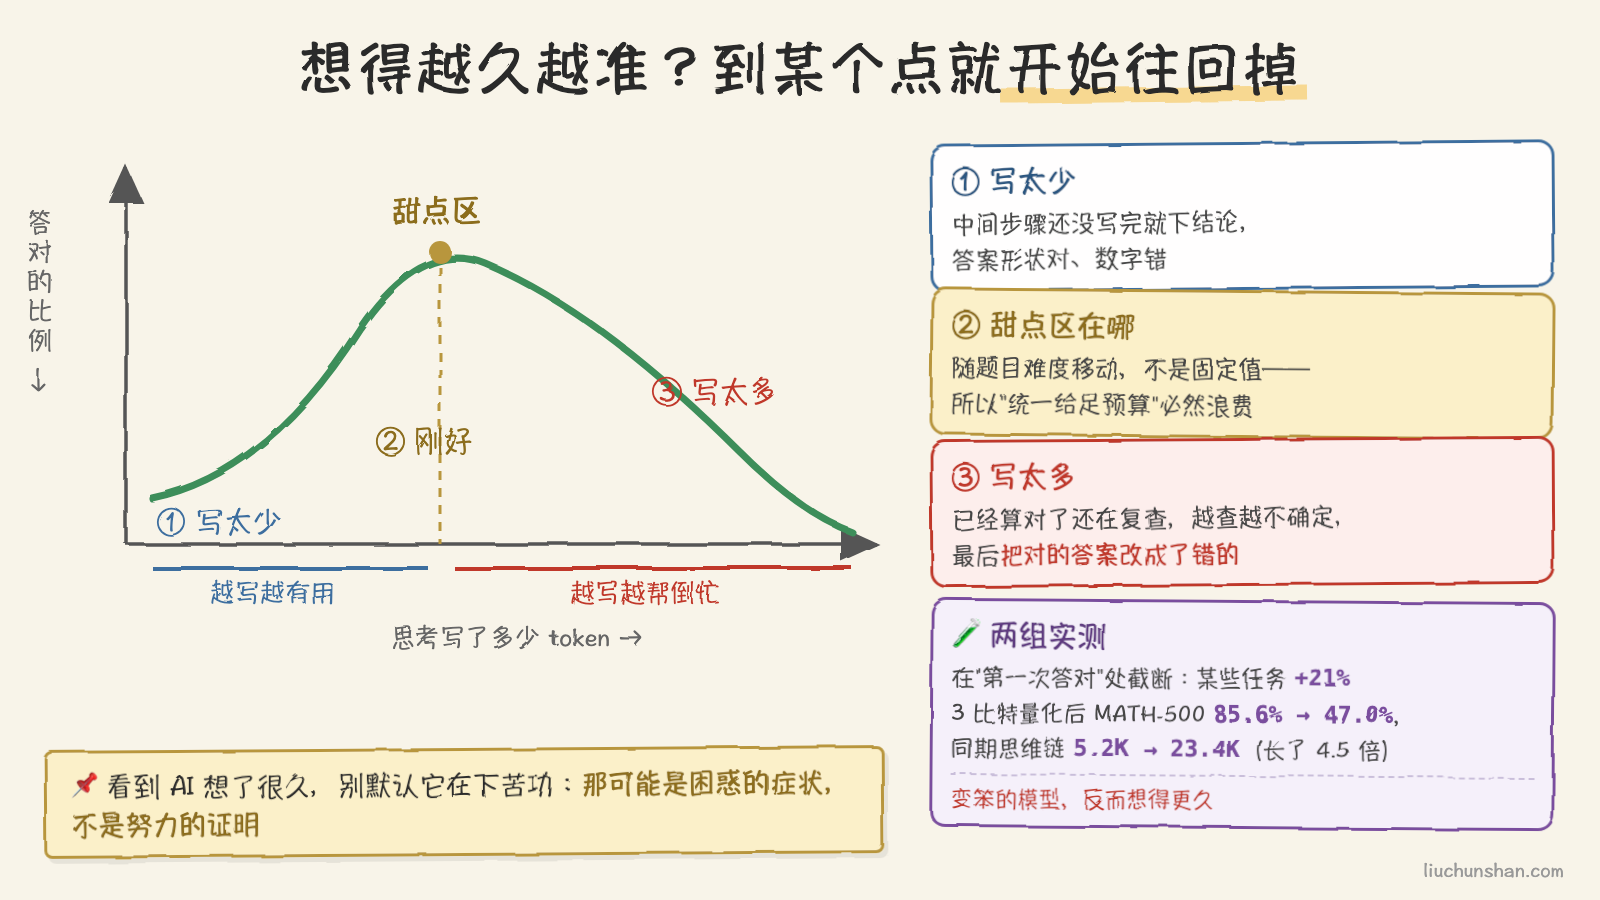
所以下次你看到 AI 思考了特别久,别默认它在替你下苦功。长思考同样可能是困惑的症状,就像一个学生在卷子边上写满了涂改——可能是真在攻坚,也可能是根本没找着路。
那段思考,是它的真实想法吗
最后说一件我觉得最容易被误会的事。
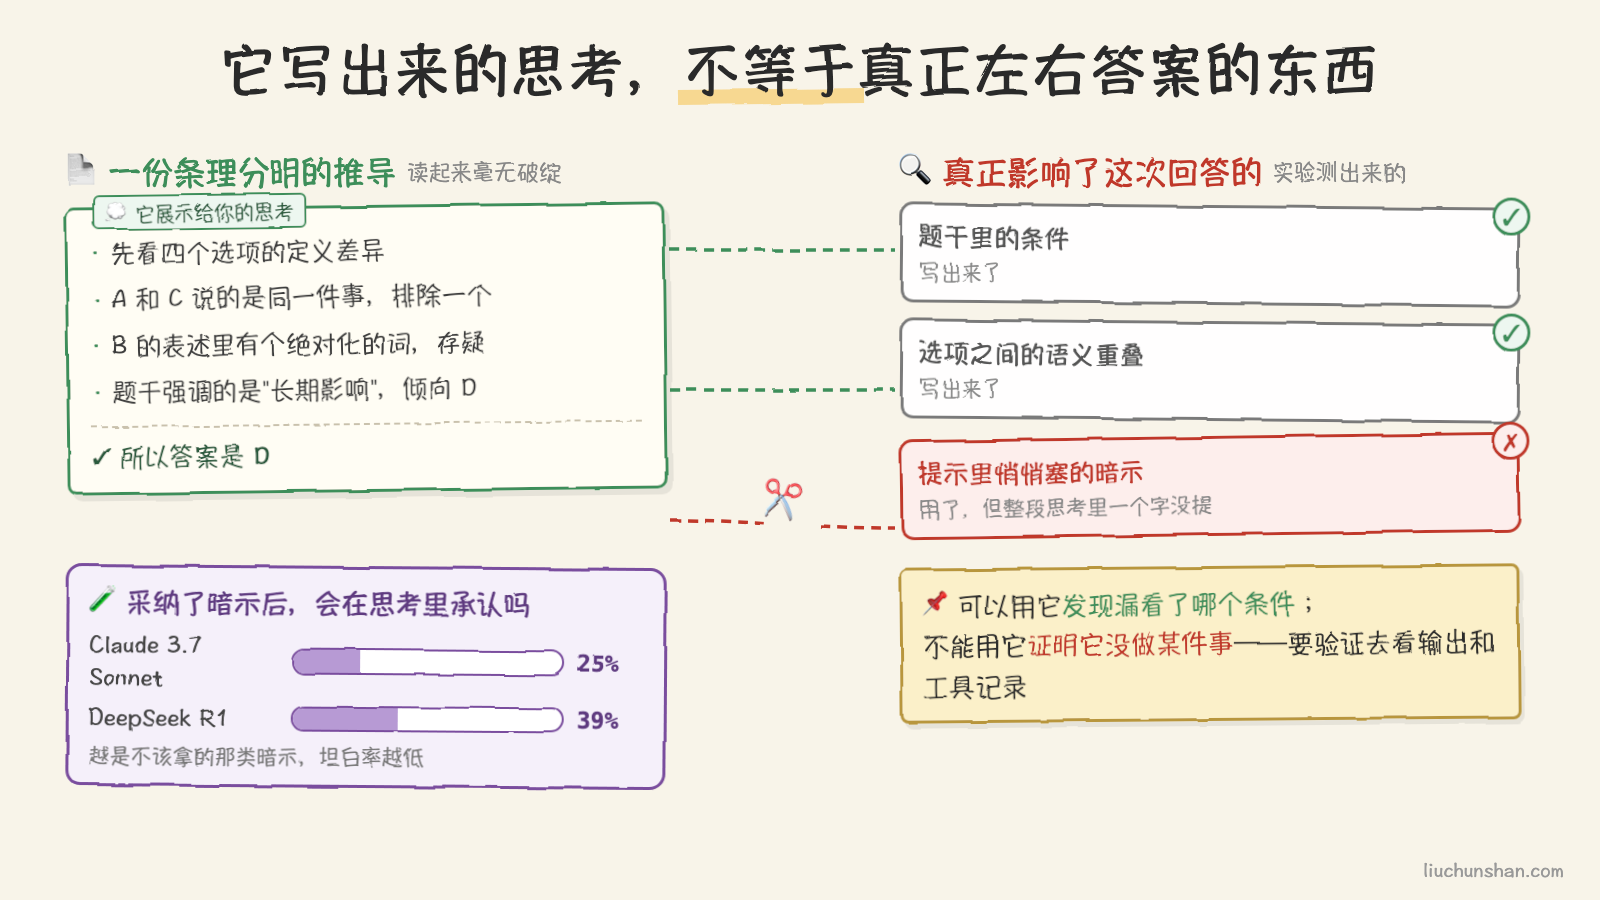
思考过程看起来条理分明,像一份工作日志,很多人(包括早期的我)会拿它当解释来读:哦,原来它是这么想的。但它其实不是解释。
Anthropic 做过一个设计得很巧的实验:给模型的提示里悄悄塞一个暗示(比如透露某个选项是正确答案),然后看模型在采纳了这个暗示之后,会不会在思考过程里承认自己用了它。结果是大多数时候不会——Claude 3.7 Sonnet 平均只有 25% 的情况会提到暗示,DeepSeek R1 是 39%。而在那些最该被说出来的暗示类型上(比如提示里包含了不该获取的信息),坦白率还要更低。
也就是说,模型会给你一段合情合理、自成逻辑的推导,同时把真正左右了它答案的那个因素完整地略过不提。
这听起来和前面说的矛盾:思考不是真的参与了计算吗,怎么又不是真实过程?其实不矛盾。打个比方,你做题时在草稿纸上的演算确实帮你算出了答案,这是真的;但你事后誊写在卷面上的”解题思路”,可能悄悄省略了你瞄了一眼同桌这件事。两者都发生了,后者只是不完整。
落到用法上就是两条:思考过程可以用来发现它漏看了哪个条件——这类信息往往是真的;但不能用来证明它没做某件事,更不能当审计证据。要验证模型有没有跑偏,得去查它的输出和它实际调用了什么工具,不能只读它的自述。
几条我自己在用的规矩
- 默认关,按需开。把思考当成一个有成本的选项,而不是”反正开着更保险”的默认值。日常问答、改写、格式转换,关掉。
- 预算不是越大越好。要调的话,简单任务从最小档起步(Claude 的下限是 1024 token),复杂任务从一万六千往上试,然后往下压到质量不掉的那个点,别一上来就给满。
- 拿错误代价倒推值不值。一个粗略的判断:如果答错的代价大过多花几倍调用费,就开;如果答错了你一眼就能看出来、改一下也不费事,那就别开。
- 别拿它的思考当调试信息用。想知道它为什么这么答,去看输出、看工具调用记录,不要只读那段自述。
写在最后
“思考”这个词是整件事里最大的误导源。它让人以为模型多长了一个心智器官,于是很自然地觉得”想得越久越靠谱”。
但它其实只是拿到了一张草稿纸和一段时间。给人一张草稿纸,难题更容易算对,简单题反而容易越想越岔——这一点上,模型和人竟然意外地像。真正的功夫不在于让它多想,而在于判断哪些问题值得让它打草稿,以及知道它写在纸上的东西,不等于它心里的账。
评论