跟 K8s 要"一张 80G 显存的卡",为什么以前说不出口:DRA 讲人话
在 K8s 里申请 GPU,写法是 nvidia.com/gpu: 1。这个 1 只是一个整数,型号、显存、两张卡挨不挨着,全都说不出口,只能靠给节点贴标签绕路。这不是 GPU 的问题,是 K8s 记设备的方式从一开始就只会数个数。DRA 把设备从"一个数"改成"一张有属性的卡片",申请方式从"要几个"变成"要什么样的",写起来像申请 PVC。1.34 核心转正,1.37 又把"老写法照样能走新路"这座桥转正。这篇把它为什么要重来、四种对象各管什么、迁移时唯一要记住的约束讲清楚。
在 K8s 上跑过模型的人,对这几行 YAML 都不陌生:
resources:
  limits:
    nvidia.com/gpu: 1
它的意思是”给我一张 GPU”。看起来很自然,直到有一天集群里的卡不再是一种。
我第一次觉得别扭,是一个混着 24G 卡和 80G 卡的集群。一个 70B 的模型只能上 80G 那种,YAML 里怎么写?翻遍字段,能写的只有那个 1。没有地方填显存,没有地方填型号。最后的办法是给节点贴标签,Pod 加 nodeSelector,也就是绕开 K8s 的资源系统,用”我知道那台机器上插的是什么卡”来代替”我需要什么样的卡”。
后来这种绕路越来越多:要两张卡在同一条 PCIe 链路上(不然走 NVLink 变成走 PCIe,训练慢一截),贴标签;要半张卡(MIG 切出来的实例),另起一个资源名 nvidia.com/mig-1g.10gb,每种切法一个名字;换个厂商的卡,标签体系重来一遍。每一种绕路单看都不算难,加在一起就是”设备越多,YAML 越像一堆黑话”。
这篇讲的是 K8s 为什么一开始只会数个数,以及它是怎么把这件事重来的。
数个数:K8s 记设备的老办法
老办法叫 device plugin,2017 年的 1.8 版本进来的。它的工作方式很简单:每台节点上跑一个厂商的插件,插件告诉 kubelet”我这有 8 个叫 nvidia.com/gpu 的东西”,kubelet 把这个数报给 API server,节点的可分配资源里就多了一行 nvidia.com/gpu: 8。
注意它报上去的是什么:一个名字,一个整数。这类资源叫扩展资源(extended resource),规则和 CPU、内存一样,走减法。调度器给 Pod 挑节点时,拿节点的 8 减去已经落在上面的 Pod 申请之和,剩下的够不够这个 Pod 要的 1。我在 request 和 limit 那篇写过,调度器眼里的资源就是一道减法,这里也是,只是数的对象从核数换成了卡数。
减法能算的东西,只有数量。所以那 8 张卡的型号、每张的显存、哪两张之间有 NVLink、哪张在哪个 NUMA 节点上,在报给 API server 的那一刻全部丢了。不是插件不知道,是 API 里没有地方放。插件当然可以自己在节点上记着这些,等 Pod 真调度过来再挑一张合适的给它,但调度器做决定的时候看不到,决定就可能是错的:一个要两张互联卡的任务被放到了一台只剩两张不互联的卡的节点上,调度器毫不知情,因为它只看到 8 - 6 >= 2。
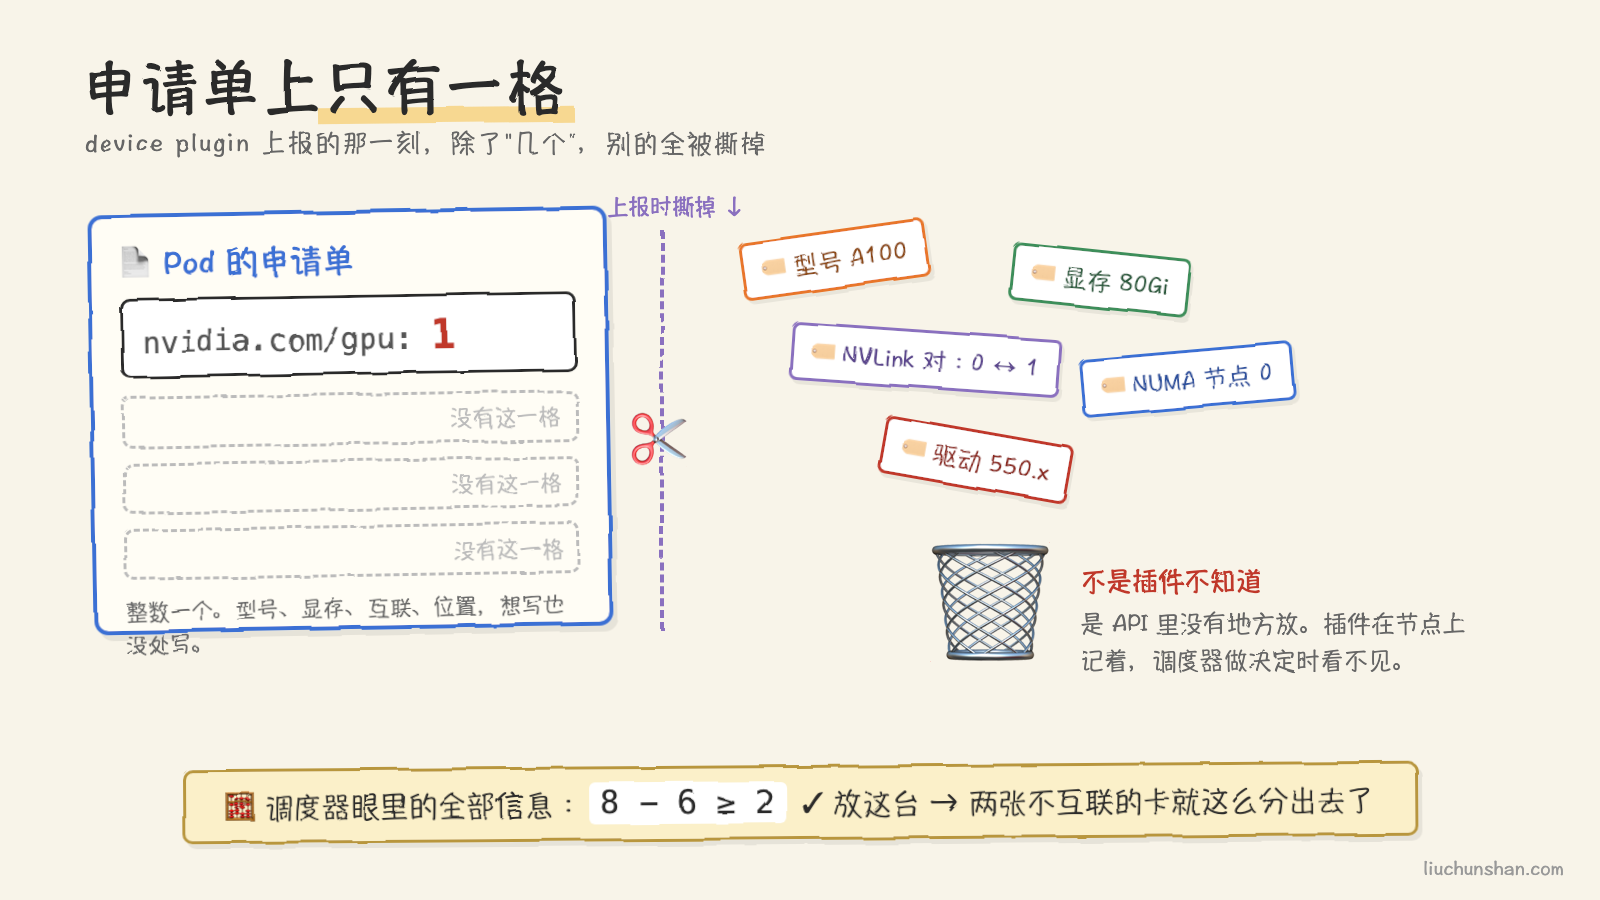
这就是”说不出口”的根源。你不是不会写,是这套接口天生只有一个整数的位置。前面那些绕路(标签、MIG 另起资源名、厂商各搞一套)都是在这个整数旁边硬加的补丁。
DRA:把”一个数”改成”一张卡片”
新办法叫 DRA,动态资源分配。它在 1.26 就有了第一版,中间推倒重写过一次,1.34 核心 API 转正,API 组是 resource.k8s.io/v1。
它改的核心只有一件事:设备不再是节点上的一个计数,而是一个个带属性的对象。理解它最快的办法是想一下 K8s 怎么管存储。
申请存储的时候你不会写 disk: 1。你会写一个 PVC,说”我要 100G、读写模式是 RWO、用 fast-ssd 这个 StorageClass”,然后有一堆 PV 摆在那里,K8s 从里面挑一个满足条件的绑给你。DRA 就是把这套搬到了设备上,对象也几乎一一对应:
- ResourceSlice,对应 PV。由驱动发布,上面列着某台节点有哪些设备,每个设备带一组属性(型号、驱动版本、是否支持某种互联)和容量(显存多少)。是驱动的”货架清单”。
- DeviceClass,对应 StorageClass。管理员定义的设备类别,比如”gpu.nvidia.com”,可以预设一些筛选条件和配置。
- ResourceClaim,对应 PVC。用户写的申请单,说”我要一个这个类别的设备,还得满足这些条件”。
- ResourceClaimTemplate,对应 PVC 模板。每个 Pod 起来时自动生成一份独立的 Claim,Pod 没了 Claim 跟着回收。要多个 Pod 共用一个设备就直接写 ResourceClaim。
Pod 这边则不再往 resources.limits 里塞名字,而是先声明用到哪几张申请单,再在容器里引用:
spec:
  resourceClaims:
  - name: gpu
    resourceClaimTemplateName: big-gpu
  containers:
  - name: worker
    resources:
      claims:
      - name: gpu
那个 80G 显存的要求,终于有地方写了。写在 ResourceClaimTemplate 里,用 CEL 表达式描述条件:
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
  name: big-gpu
spec:
  spec:
    devices:
      requests:
      - name: gpu
        exactly:
          deviceClassName: gpu.example.com
          count: 1
          selectors:
          - cel:
              expression: device.capacity["gpu.example.com"].memory.compareTo(quantity("80Gi")) >= 0
翻译成人话:从 gpu.example.com 这个类别里给我一个设备,条件是它的显存容量不小于 80Gi。属性名前面那段是驱动的域名,每个驱动上报自己的属性,用户按名字取。
“两张卡要挨着”也有了正经写法,不用贴标签了。请求里可以加约束,要求分到的几个设备在某个属性上取值相同:
      constraints:
      - requests: ["gpu"]
        matchAttribute: resource.kubernetes.io/numaNode
意思是这个请求拿到的所有设备必须在同一个 NUMA 节点上。前缀是 resource.kubernetes.io 的属性是标准化的,各家驱动都按同一个名字上报,换厂商不用改。
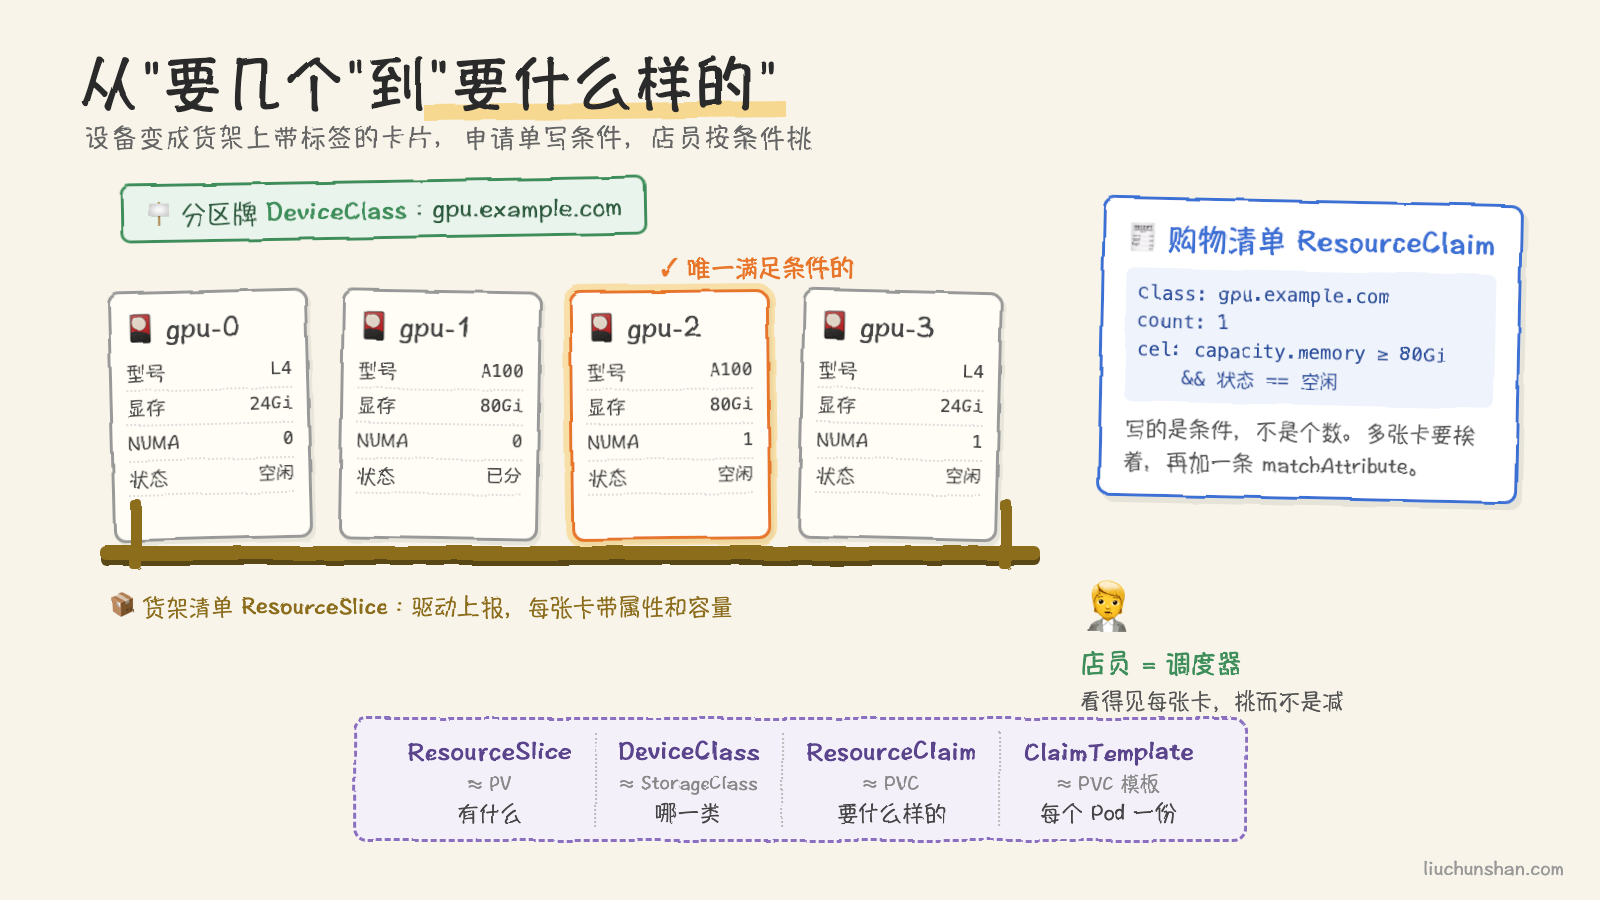
调度器的工作也跟着变了。以前是做减法,现在是在所有节点的 ResourceSlice 里找满足 Claim 条件的设备,找到就把分配结果写进 Claim 的状态里,Pod 绑到那台节点。kubelet 起容器前再叫驱动把这几个具体的设备准备好挂进去。整个过程调度器是看得见设备属性的,“两张不互联的卡被当成互联的分出去”这种事从机制上就不会发生。
MIG 那种半张卡的情况,在这套模型里也不需要另起资源名了。一张卡能切成哪几种实例,驱动作为同一个设备的不同”切法”上报,调度器保证同一时刻只按一种切法分出去。这部分叫可切分设备,写这篇时还在 beta,但方向已经定了:切法是设备的属性,不是新的资源名。
1.37 转正的那座桥
DRA 核心转正是去年 1.34 的事,这个月 3 号发布的 1.37 又转正了三个东西,其中最要紧的一个解决的是”怎么从老办法过去”。
问题在于存量。一个集群里可能有几百个 Deployment 写着 nvidia.com/gpu: 1,还有一堆 Helm chart 和平台代码在生成这种写法。让所有人改成 ResourceClaim,这事推不动,推动了也要很久。
1.37 的做法是在 DeviceClass 上加一个字段:
apiVersion: resource.k8s.io/v1
kind: DeviceClass
metadata:
  name: gpu.example.com
spec:
  extendedResourceName: example.com/gpu
意思是:谁在 resources.limits 里申请 example.com/gpu,就等价于申请了这个 DeviceClass 的一个设备。调度器看到老写法的 Pod,在背后替它合成一个 ResourceClaim,走 DRA 的分配路径。Pod 的 YAML 一个字不用改,节点上却已经不需要 device plugin 了。
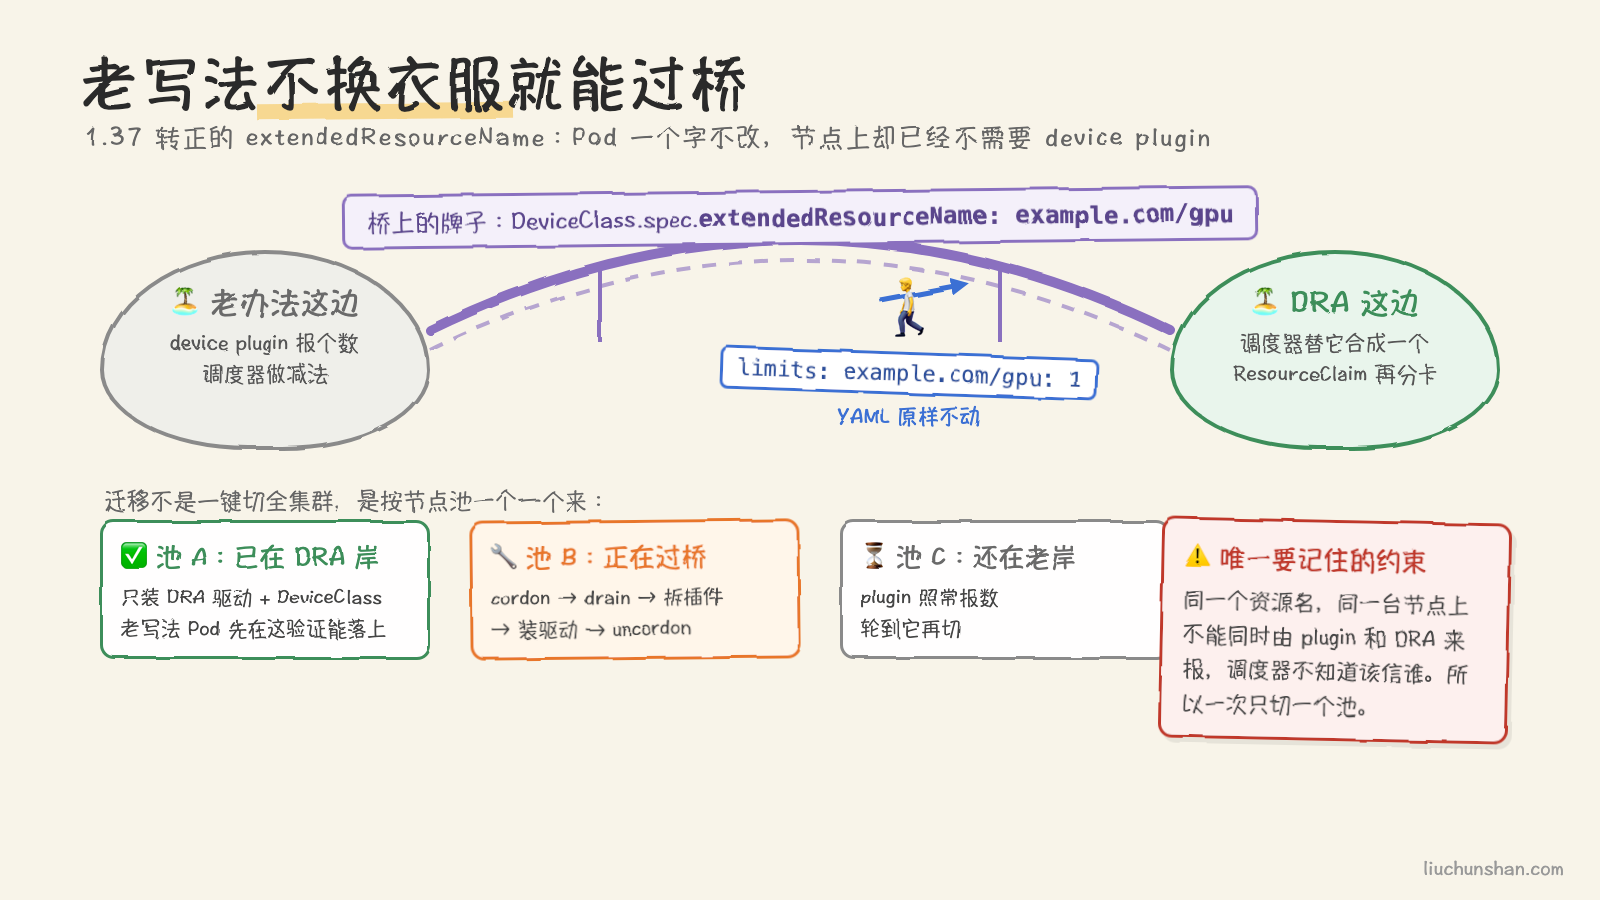
只有一条约束必须记住:同一个资源名,同一台节点上不能同时由 device plugin 和 DRA 驱动来报。两边都说自己有 example.com/gpu,调度器不知道该信谁。所以迁移不是全集群一键切换,是按节点池来:先在新池子上只装 DRA 驱动和 DeviceClass,验证老写法的 Pod 能正常落上去,再把老池子一个个 cordon、drain、拆插件、装驱动、放开。整个过程租户什么都不用做。
另外两个转正的东西一句话带过。设备污点:驱动或管理员可以给某张卡打污点,比如健康检查发现它 ECC 错误变多,打上污点后新 Pod 不再往上调,行为和节点污点一样。Claim 状态:驱动可以把分到的设备的实际信息写回 Claim,比如网卡的接口名和 IP,用户不用再去猜容器里看到的是哪块。
它不是让你多写 YAML
看到这里可能会有一个反应:为了要一张 80G 的卡,从一行变成了十几行,这不是更麻烦了吗。
我的看法是,麻烦没有增加,只是从暗处搬到了明处。以前那一行 1 的背后,是运维给节点贴的标签、平台代码里维护的”型号到标签”的映射表、MIG 每种切法一个资源名的约定、跨厂商各不相同的一套套规则。这些东西一样没少,只是不在 YAML 里,散在文档、脚本和某个人的脑子里。DRA 做的是给它们一个正式的位置,让”我要什么样的卡”这句话由申请方说出来,由调度器听懂,而不是靠申请方碰巧知道机器上插的是什么。
对大多数只需要”一张卡”的人,什么都不用改,1.37 的那座桥就是为这种情况修的。对需要挑卡的人,终于有了一种不靠黑话的说法。这两件事同时成立,才叫转正。
评论